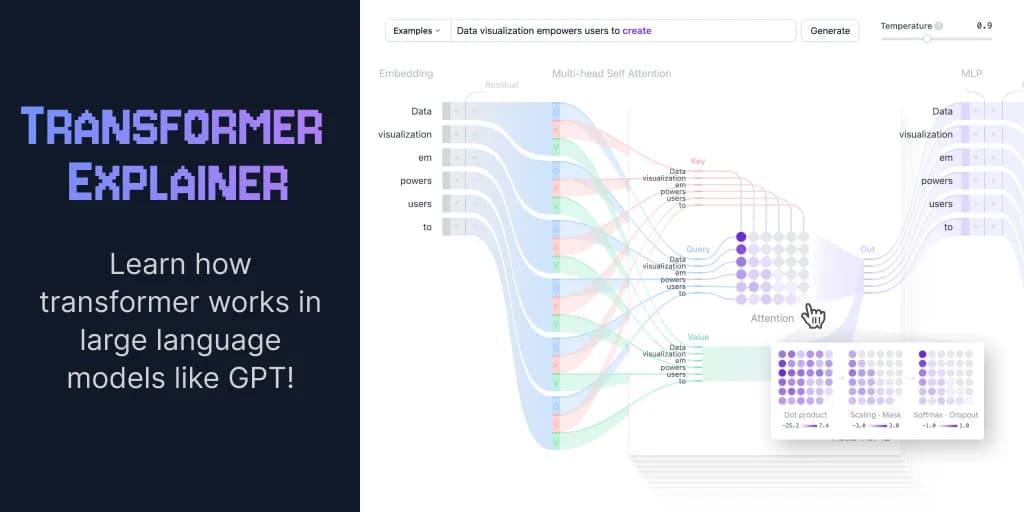
تصور کنید بتوانید لحظه به لحظه روند «تفکر» یک شبکه عصبی را تماشا کنید. Transformer Explainer — پروژهای از پژوهشگران مؤسسه فناوری جورجیا (Georgia Tech) — یک شبیهساز زنده و تحت مرورگر است که نشان میدهد یک مدل ترنسفورمر (Transformer) چگونه متن را پردازش کرده و توکن بعدی را پیشبینی میکند.
این ابزار در زمانی عرضه شده که مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — به ابزاری روزمره تبدیل شدهاند اما برای اکثر کاربران همچنان یک «جعبه سیاه» هستند. همانطور که در تحلیلهای قبلی ما دربارهی خط لولههای تولید مدلهای هوش مصنوعی اشاره کردیم، تمرکز اکنون از مرحله استقرار به سمت آموزش تغییر کرده است. این پروژه با رویکردی تعاملی، معماری مدلهایی نظیر GPT-4 و Gemini را برای همه قابلفهم میکند.
زمینه و ریشهها
معماری ترنسفورمر یک شبکه عصبی (Neural Network) — شبکهای از سلولهای کوچک، شبیه نقشهٔ مترو، که سیگنال را از ورودی به جواب میرساند — است که اساساً رویکرد هوش مصنوعی را تغییر داد. این ساختار نخستین بار در مقاله مشهور «Attention is All You Need» در سال ۲۰۱۷ معرفی شد و از آن زمان به استاندارد یادگیری عمیق تبدیل گشت. برای درک عمیقتر این تحول، میتوان به بررسی جایگزینی پردازش متوالی اشاره کرد که کلید درک زمینه در مدلهای زبانی مدرن است.
اگرچه این معماری بیشتر برای مدلهای تولید متن مثل Llama متا یا Gemini گوگل شناخته شده، اما کاربردهای گستردهای دارد. امروزه ترنسفورمرها در تولید صدا، تشخیص تصویر، پیشبینی ساختار پروتئینها و حتی در بازیهای پیچیده به کار گرفته میشوند. در همین راستا، معماری ترنسفورمرهای چندوجهی گامی فراتر نهاده و امکان تبدیل پیکسلهای تصویر به توکنهای زبانی را فراهم کرده است.
ترنسفورمرهای متنی بر اساس اصل «پیشبینی توکن بعدی» کار میکنند. وقتی کاربر یک متن (Prompt) را وارد میکند، مدل از خود میپرسد: محتملترین توکن بعدی (که میتواند یک کلمه یا بخشی از یک کلمه باشد) که پس از این ورودی میآید چیست؟
قدرت اصلی این سیستم در سازوکار خودتوجهی (Self-Attention) نهفته است. این قابلیت به مدل اجازه میدهد کل توالی متن را بهطور همزمان پردازش کرده و روابط دوربرد بین کلمات را بسیار مؤثرتر از معماریهای قدیمی درک کند.
طبق گزارش منتشر شده در ۲۱ سپتامبر ۲۰۲۶ در وبسایت poloclub.github.io، این ابزار بر پایه مدل GPT-2 (small) اجرا میشود. این مدل با ۱۲۴ میلیون پارامتر (Parameters)، اگرچه امروز قدرتمندترین نیست، اما DNA معماری سیستمهای پیشرفته را دارد و بهترین نقطه برای شروع یادگیری مفاهیم پایه است.
فرآیند تبدیل به بردار معنایی
هر متنی پیش از پردازش باید به عدد تبدیل شود. این ابزار فرآیند تبدیل یک جمله (مثلاً «تجسم دادهها به کاربران قدرت میدهد») را در یک خط لوله چهار مرحلهای بصری میکند:
- توکنسازی (Tokenization): متن به قطعات کوچکتر و قابل مدیریت به نام توکن تقسیم میشود. این توکنها میتوانند کلمات کامل یا زیر-کلمات باشند. برای مثال، کلمات «Data» و «visualization» توکنهای منحصربهفرد هستند، اما کلمه «empowers» به دو توکن تقسیم میشود. GPT-2 از یک واژگان ثابت ۵۰,۲۵۷ توکنی استفاده میکند که پیش از مرحله آموزش تعیین شده است.
- بردار معنایی توکن (Token Embedding): هر توکن به یک بردار عددی تبدیل میشود — مثل کارت معرفی عددی برای هر واژه که میگوید این کلمه «همسایهی» چه کلمات دیگری است. در GPT-2 (small)، هر توکن یک بردار ۷۶۸ بعدی است. این بردارها در یک ماتریس عظیم با ابعاد (۵۰,۲۵۷، ۷۶۸) ذخیره شدهاند که در مجموع حدود ۳۹ میلیون پارامتر را در بر میگیرد. این ساختار به مدل اجازه میدهد توکنهایی با معنای مشابه را در فضای چندبعدی نزدیک به هم و توکنهای نامرتبط را دور از هم قرار دهد. در کاربردهای پیشرفتهتر، تنظیم دقیق مدلهای چندبرداری توانسته است بازیابی اسناد تخصصی را به شکل بهینهتری مدیریت کند.
- رمزگذاری موقعیت (Positional Encoding): چون ترنسفورمرها کل متن را یکباره میخوانند، حس ذاتی ترتیب کلمات را ندارند. مدل اطلاعات موقعیتی را به هر توکن اضافه میکند. برخلاف برخی مدلها، GPT-2 ماتریس رمزگذاری موقعیت خود را از صفر آموزش میدهد و آن را مستقیماً در فرآیند یادگیری ادغام میکند.
- بردار نهایی: مجموع بردار معنایی و رمزگذاری موقعیت، معنای کلمه و جایگاه دقیق آن را در توالی ورودی بهطور همزمان ثبت میکند.
درون بلوکهای ترنسفورمر
این مدل از ۱۲ بلوک ترنسفورمر روی هم قرار گرفته تشکیل شده است. این بلوکها بهصورت متوالی چیده شدهاند و اجازه میدهند نمایش توکنها از بلوک اول تا آخر تکامل یابد. این رویکرد لایهای به مدل کمک میکند تا نمایشهای سطح بالاتر و درک پیچیدهتری از ورودی ایجاد کند.
هر بلوک دو عملیات اصلی را برای پالایش معنای توکن انجام میدهد:
توجه چندسر
نخست، سازوکار توجه چندسر (Multi-Head Self-Attention) است که اجازه میدهد توکنها با یکدیگر «ارتباط» برقرار کنند و اطمینان حاصل شود که نمایش هر توکن تحت تأثیر توکنهای دیگر است. ابزار مذکور برای توضیح سه ماتریس درگیر، از تشبیه جستوجوی وب استفاده میکند:
- پرسوجو (Query): شبیه متنی است که در نوار جستوجوی گوگل تایپ میکنید؛ یعنی توکنی که مدل میخواهد درباره آن اطلاعات بیشتری بیابد.
- کلید (Key): شبیه عناوین صفحات وب در نتایج جستوجو است و توکنهای احتمالی را نشان میدهد که میتوانند به پرسوجو پاسخ دهند.
- مقدار (Value): شبیه محتوای واقعی صفحات وب است. وقتی پرسوجو با یک کلید مطابقت یافت، مدل «مقدار» را استخراج میکند.
این بردارها از ضرب ماتریس بردار ورودی در ماتریسهای وزن یادگرفتهشده برای Q، K و V به دست میآیند. عملیات ریاضی این ماتریسها به صورت زیر تعریف میشود: $QKV_{ij} = ( \sum_{d=1}^{768} \text{Embedding}{i,d} \cdot \text{Weights}{d,j}) + \text{Bias}_j$.
در GPT-2 (small)، بردارهای پرسوجو، کلید و مقدار به ۱۲ «سر» مجزا تقسیم میشوند. هر سر بخشی از بردارها را بهطور مستقل پردازش میکند. این طراحی یادگیری موازی ویژگیهای مختلف زبانی را تسهیل میکند و قدرت نمایش مدل را افزایش میدهد. این یعنی مدل میتواند همزمان روابط متفاوتی را ردیابی کند؛ مثلاً یک سر روابط دستوری کوتاهبرد را شناسایی میکند و سر دیگر بافت معنایی گستردهتر را دنبال میکند.
برای جلوگیری از «تقلب» مدل و نگاه کردن به کلمات آینده، از خودتوجهی ماسکشده (Masked Self-Attention) استفاده میشود. این فرآیند شامل مراحل زیر است:
- ضرب داخلی (Dot Product): ماتریسهای پرسوجو و کلید در هم ضرب میشوند تا امتیازات توجه تعیین شوند. این کار یک ماتریس مربعی ایجاد میکند که رابطه بین تمام توکنهای ورودی را نشان میدهد.
- مقیاسبندی و ماسکگذاری: امتیازات مقیاسبندی شده و یک ماسک روی مثلث بالایی ماتریس اعمال میشود و مقادیر آینده را به منفی بینهایت تبدیل میکند. این کار تضمین میکند مدل نتواند به آینده «سرک بکشد» و مجبور شود فقط بر اساس متن قبلی، توکن بعدی را پیشبینی کند.
- سافتمکس و دراپاوت: امتیازات از طریق تابع softmax به احتمال تبدیل میشوند (بهطوری که مجموع هر ردیف برابر یک شود) و در صورت نیاز با Dropout منظم میشوند.
در نهایت، این امتیازات در ماتریس مقدار (Value) ضرب میشوند تا خروجی نهایی سازوکار توجه به دست آید. خروجیهای هر ۱۲ سر با هم ترکیب (Concatenate) شده و از یک لایه تصویر خطی عبور میکنند.
پرسپترون چندلایه (MLP)
عملیات دوم، پرسپترون چندلایه (MLP) است. در حالی که توجه، اطلاعات را بین توکنها جابهجا میکند، MLP هر توکن را بهطور مستقل پردازش میکند تا نمایش آن را دقیقتر کند. این بلوک شامل دو تبدیل خطی است که بین آنها یک تابع فعالساز GELU قرار دارد:
- گسترش: تبدیل اول ابعاد توکن را چهار برابر میکند (از ۷۶۸ به ۳,۰۷۲). این کار توکن را به فضای با ابعاد بالاتر میبرد تا الگوهای غنیتر و پیچیدهتری را که در ابعاد اصلی قابل مشاهده نیستند، شناسایی کند.
- فشردهسازی: تبدیل دوم ابعاد را دوباره به ۷۶۸ برمیگرداند تا حجم محاسبات مدیریت شود و در عین حال تبدیلهای غیرخطی مفید حفظ شوند.
برخلاف سازوکار توجه که اطلاعات را در سطح توکنها ادغام میکند، MLP صرفاً نمایش هر توکن را از یک فضای عددی به فضای دیگر منتقل کرده و ظرفیت کلی مدل را غنی میکند.
پیشبینی توکن بعدی
پس از عبور از ۱۲ بلوک، دادهها به لایه خطی نهایی میرسند. این لایه نمایش توکن را به فضایی با ۵۰,۲۵۷ بُعد منتقل میکند، جایی که به هر توکن در واژگان، عددی به نام لاجیت (Logit) اختصاص مییابد. این کار به مدل اجازه میدهد تمام توکنهای ممکن را بر اساس احتمال حضورشان به عنوان کلمه بعدی رتبهبندی کند.
کاربران میتوانند با لایه سافتمکس (Softmax) تعامل داشته باشند تا ببینند چگونه این لاجیتها به یک توزیع احتمالی تبدیل میشوند که مجموع آنها برابر یک است. ابزار مذکور یک لغزنده برای کنترل دمای (Temperature) مدل دارد:
- دما = ۱: لاجیتها بر یک تقسیم میشوند و خروجی سافتمکس بدون تغییر میماند.
- دما < ۱: توزیع را تیزتر میکند و مدل را مطمئنتر، قطعیتر و پیشبینیپذیرتر میسازد.
- دما > ۱: توزیع را نرمتر میکند و اجازه میدهد تصادفی بودن و «خلاقیت» مدل افزایش یابد.
همچنین روشهای نمونهگیری برای پالایش خروجی در دسترس هستند:
- نمونهگیری k برتر (Top-k): کاندیداها را به k توکن اول با بالاترین احتمال محدود کرده و گزینههای کماحتمال را حذف میکند.
- نمونهگیری p برتر (Top-p): کوچکترین مجموعهای از توکنها را در نظر میگیرد که مجموع احتمال آنها از آستانه p بیشتر شود. این کار تنوع را حفظ کرده و همزمان فقط توکنهای محتمل را نگه میدارد.
ویژگیهای پایداری و عملکرد
این ابزار جزئیات فنی کمکی را که یادگیری عمیق را ممکن میسازند، برجسته میکند. این موارد برای آموزش و همگرایی مدل حیاتی هستند:
- نرمالسازی لایه (Layer Normalization): در هر بلوک دو بار (قبل از توجه و قبل از MLP) اعمال میشود. این کار ورودیها را بر اساس ویژگیها استاندارد میکند تا میانگین و واریانس ثابتی داشته باشند. این کار باعث کاهش تغییرات داخلی (Internal Covariate Shift)، یادگیری مؤثرتر و کاهش حساسیت به وزنهای اولیه میشود.
- دراپاوت (Dropout): تکنیکی برای جلوگیری از بیشبرازش (Overfitting) که در آن بخشی از وزنها بهطور تصادفی در طول آموزش صفر میشوند. این کار مدل را مجبور میکند ویژگیهای مقاومتری را یاد بگیرد و به نورورهای خاصی وابسته نشود. در زمان استنتاج (Inference)، دراپاوت غیرفعال میشود.
- اتصالات باقیمانده (Residual Connections): این میانبرها که در سال ۲۰۱۵ توسط ResNet معرفی شدند، ورودی یک لایه را به خروجی آن اضافه میکنند. در GPT-2، این اتصالات دو بار در هر بلوک (قبل و بعد از MLP) استفاده میشوند تا مشکل محوشدن گرادیان (Vanishing Gradient) حل شود و لایههای ابتدایی در طول پسانتشار (Backpropagation) بهدرستی بهروزرسانی شوند.
کاوش تعاملی و پیادهسازی
Transformer Explainer برای اکتشاف فعال طراحی شده است. کاربران میتوانند از طریق ویژگیهای زیر با مدل تعامل کنند:
- ورودی سفارشی: وارد کردن متنهای دلخواه برای مشاهده نحوه پردازش کلمات خاص و پیشبینی توکن بعدی.
- نقشههای توجه: تعامل با نقشههای توجه و نگه داشتن نشانگر روی توکنها برای مشاهده وزنهای توجه و نحوه درک بافت متن توسط مدل.
- تنظیم پارامترها: استفاده از لغزندههای دما و انتخابگرهای Top-k و Top-p برای مشاهده تغییر لحظهای توزیع احتمالات.
- ردیابی محاسبات: بررسی محاسبات میانی و محاسبه نهایی احتمالات خروجی.
از نظر فنی، این پروژه یک شاهکار مهندسی مرورگر است. مدل GPT-2 از پروژه nanoGPT اندرو کارپاتی (پیادهسازی PyTorch) گرفته شده و برای اجرای بدون نقص در مرورگر به فرمت ONNX Runtime تبدیل شده است. رابط کاربری نیز با استفاده از Svelte برای بخش فرانت-اند و D3.js برای تجسمهای پویا ساخته شده است.
تیم دانشگاه جورجیا تک شامل Aeree Cho، Grace C. Kim، Alexander Karpekov، Alec Helbling، Jay Wang، Seongmin Lee، Benjamin Hoover و Polo Chau این ابزار را خلق کردند.
این تغییر رویکرد به سمت آموزش تعاملی به این معناست که درک هوش مصنوعی دیگر مختص کسانی نیست که مقالات آکادمیک میخوانند. تیم جورجیا تک با تبدیل جبر خطی انتزاعی به یک تجربه بصری، سد ورود به دنیای سواد هوش مصنوعی را شکست.
برای کسانی که میخواهند از تماشا به ساخت برسند، بررسی مخزن nanoGPT برای دیدن نحوه کدنویسی این بلوکهای ریاضی در PyTorch گام بعدی است.
گام بعدی شما
- ابزار Transformer Explainer را باز کنید و جملاتی با ساختار پیچیده دستوری وارد کنید تا ببینید «سرهای توجه» چگونه روابط را شناسایی میکنند.
- مقدار Temperature را به زیر ۰.۵ برسانید تا تفاوت بین پاسخهای قطعی و پاسخهای خلاقانه را در توزیع احتمالات مشاهده کنید.
- برای درک پیادهسازی کد، مستندات nanoGPT را مطالعه کنید تا ببینید ماتریسهای Q، K و V چگونه در پایتون تعریف میشوند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو