تصور کنید ویدیویی تولید کردهاید که زیرنویسهایش با صدا همخوانی ندارد و لحن گوینده با فضای صحنه در تضاد است؛ این نتیجهٔ اجتنابناپذیر نگاه به دوبله هوش مصنوعی بهعنوان یک «ویژگی» ساده است. VANIV Studio استدلال میکند که ترجمه حرفهای ویدیو به چیزی فراتر از یک متن درست نیاز دارد: همگامسازی دقیق صدا، زمانبندی و میکس نهایی.
ترجمه ویدیو با هوش مصنوعی در ظاهر ساده است: آپلود فایل، انتخاب زبان، تولید صدا و خروجی گرفتن. اما در تولیدات واقعی، این تنها نقطه شروع است. یک ویدیو میتواند متنی کاملاً درست داشته باشد اما باز هم «غلط» به نظر برسد؛ چون صدا با شخصیت سازگار نیست، تخصیص گویندهها تغییر میکند، جملات بیش از حد طولانیاند یا میکس نهایی صدا مصنوعی به نظر میرسد. به همین دلیل، ترجمه ویدیو با هوش مصنوعی باید بهعنوان یک گردشکار تولیدی کامل دیده شود، نه یک ویژگی تکبعدی از هوش مصنوعی.
بسیاری از تولیدکنندگان محتوا اکنون برای ترجمههای سریع به ابزارهای ابری متکی هستند. در حالی که این سرویسها راحت هستند، اما اغلب یک «جعبه سیاه» ایجاد میکنند که در آن کاربر کنترل فایلهای خام و دادههای شبیهسازی صدا (Voice Cloning) — شبیه کپی کردن دقیق اثر انگشت صوتی یک فرد — را از دست میدهد. این وابستگی برای آژانسها و تولیدکنندگان با حجم کاری بالا که نیاز به ثبات هویت صوتی در پروژههای متعدد دارند، بدون پرداخت هزینههای گزاف اشتراکی بر اساس هر دقیقه، به یک گلوگاه تبدیل شده است.
ضرورت گردشکارهای محلی (Local-First)
اجرای گردشکار در محیط محلی به پرسشهای حیاتی تولیدی پاسخ میدهد که ابزارهای ابری اغلب نادیده میگیرند. تولیدکنندگان باید بررسی کنند که فایلهای خام کجا ذخیره میشوند و صداهای شبیهسازی شده یا طراحی شده در کجا پردازش میگردند. یک رویکرد محلی اجازه میدهد فایلهای پروژه و نسخههای میانی روی دستگاه خود کاربر باقی بمانند. این رویکرد در واقع پاسخی به چالشهای مالی است که در بررسیهای پیشین درباره کاهش هزینههای اشتراکی در دوبله ویدیو به آنها پرداخته شد.
علاوه بر این، گردشکارهای محلی اصطکاک سیستمهای «اعتباری» (Credit-based) را حذف میکنند. تولیدکننده میتواند بدون نگرانی از تمام شدن اعتبار یا هزینههای هر-دقیقه، هر تعداد که لازم است روی خروجی تغییرات ایجاد کند و تکرار (Iterate) کند. این رویکرد همچنین انعطافپذیری بیشتری ایجاد میکند و به کاربران اجازه میدهد مدلها و صداهای مختلف را بدون نیاز به آپلود مجدد کل پروژه تست کنند، یا بعداً مدل را تغییر دهند بدون اینکه مجبور باشند کل گردشکار را از ابتدا بسازند.
در ۳ اکتبر ۲۰۲۶، VANIV Studio جزئیات یک گردشکار محلی را منتشر کرد که هدفش جایگزینی ابزارهای پراکنده ابری است. فلسفه اصلی این است که کیفیت نهایی نه از یک مدل واحد، بلکه از کل زنجیره تولید حاصل میشود. طبق گزارش وبسایت dev.to، یک گردشکار محلی حرفهای از ۱۰ مرحله مجزا تشکیل شده است:
خط تولید ۱۰ مرحلهای محلی
- ۱. وارد کردن ویدیوی اصلی
- ۲. تحلیل و آمادهسازی صدا
- ۳. تبدیل گفتار به متن (Transcription)
- ۴. ترجمه متن
- ۵. شناسایی و تخصیص گوینده
- ۶. تولید صدای جدید
- ۷. تنظیمات زمانبندی (Timing)
- ۸. ساخت زیرنویس
- ۹. میکس صدا
- ۱۰. خروجی نهایی
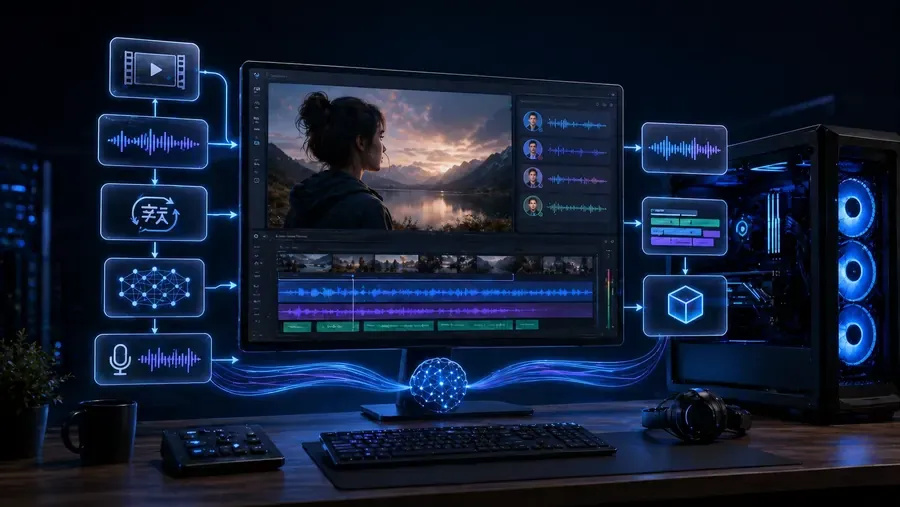
هر مرحله در این زنجیره بر مرحله بعد اثر میگذارد. صدای ضعیف در منبع، تبدیل متن را سخت میکند و ترجمه تحتاللفظی ممکن است برای زمان صحنه بیش از حد طولانی باشد. حتی یک صدای عالی اگر در جای اشتباه قرار بگیرد یا تراز بلندی (Loudness) و انتقالها (Transitions) ناهماهنگ باشد، خروجی را غیرحرفهای و ناتمام میکند.
چالش زمانبندی
یکی از سختترین چالشها در این فرآیند، نه خودِ ترجمه، بلکه زمانبندی است. جملهای که از انگلیسی به آلمانی، فرانسوی یا اسپانیایی ترجمه میشود، اغلب بهطور قابلتوجهی طولانیتر میشود. اگر تولیدکننده از ترجمه کلمه به کلمه استفاده کند، صدا یا بیش از حد سریع و شتابزده میشود یا به بخش بعدی ویدیو میزند.
VANIV Studio بر مفهوم «ترجمه قابلگفتار» (Speakable Translation) تأکید میکند؛ یعنی بازنویسی یا کوتاهتر کردن عبارات برای تناسب با ریتم اصلی ویدیو. گاهی یک ترجمه آزادتر، نتیجه بهتری میدهد چون معنا را حفظ کرده و در زمان موجود در صحنه میگنجد.
هویت صوتی و منطق گوینده
ثبات صدا دومین نقطه اصطکاک اصلی است. برای یک کلیپ ساده یا معرفی محصول، یک صدای خنثی هوش مصنوعی میتواند جواب دهد. اما وقتی صدای تولیدکننده بخشی از برند اوست، یا وقتی یک گوینده مجاز باید در چندین زبان و اپیزود ظاهر شود، شبیهسازی صدا ضروری میشود.
در مصاحبهها، پادکستها و دیالوگها، پیچیدگی بیشتر است؛ گوینده A باید در تمام پروژه همان صدا را داشته باشد و گوینده B به صدایی متفاوت و ثابت نیاز دارد. یک گردشکار چند-گوینده نمیتواند صرفاً کلیپهای صوتی جداگانه تولید کند، بلکه منطق گوینده باید بخشی از پروژه باقی بماند تا مرزهای هر بخش (Segment) تمیز و دقیق باشد. علاوه بر این، شبیهسازی صدا تنها زمانی باید استفاده شود که حقوق و رضایت لازم وجود داشته باشد.
زیرنویسها بهعنوان لایه کنترل کیفیت
در این سیستم، زیرنویسها لایه اصلی کنترل کیفیت هستند. زیرنویسها فقط برای دسترسیپذیری نیستند، بلکه فاش میکنند که آیا یک جمله برای بیان طبیعی بیش از حد طولانی است یا یک اصطلاح فنی اشتباه ترجمه شده است. اگر تغییر گوینده در جای اشتباهی رخ دهد، زیرنویسها بلافاصله این خطا را نمایان میکنند.
این گردشکار بسته به مقصد، از فرمتهای مختلف پشتیبانی میکند:
- فایلهای SRT: برای یوتیوب و پلتفرمهای آموزشی.
- فایلهای VTT: برای جریانهای کاری وب.
- زیرنویسهای چسبیده (Burned-in): برای Shorts، Reels و TikTok.
در حالت ایدهآل، این زیرنویسها از همان وضعیت پروژه (Project State) تولید میشوند که صدای دوبله از آن گرفته شده است، نه اینکه بهعنوان یک ابزار جداگانه مدیریت شوند.
میکس نهایی صدا
مرحله نهایی، میکس صدا است؛ بخشی که در دموهای هوش مصنوعی اغلب نادیده گرفته میشود. صداهای تولید شده باید از نظر بلندی (Loudness) متوازن شوند و با موسیقی پسزمینه، افکتها و صداهای محیطی باقیمانده ترکیب شوند.
بدون این مرحله نهایی، صدا شبیه به چیزی است که «روی ویدیو چسبانده شده»، نه اینکه بخشی از آن باشد. برشهای سخت (Hard Cuts) بین بخشهای تولید شده میتواند فوراً توهم واقعگرایی را از بین ببرد. صدایی که بیش از حد بلند باشد مصنوعی به نظر میرسد و صدایی که بیش از حد آرام باشد، تأثیر خود را از دست میدهد. این مرحله نهایی است که گفتار تولید شده را به محتوای قابل استفاده تبدیل میکند.
برای جلوگیری از اتلاف ساعتها زمان پردازش، این استودیو استراتژی «برش آزمایشی» (Test Slice) را توصیه میکند. تولیدکنندگان باید یک قطعه ۳۰ تا ۶۰ ثانیهای نماینده را از کل خط تولید عبور دهند تا از صحت تبدیل متن، اصطلاحات، طول ترجمه، کیفیت صدا، تخصیص گوینده، زمانبندی، زیرنویس و خروجی مطمئن شوند و سپس پروژه را در مقیاس کامل اجرا کنند.
این رویکرد محلی بهویژه برای سه گروه ارزشمند است:
- تولیدکنندگان یوتیوب: کسانی که میخواهند آموزشهای خود را به چندین زبان تبدیل کنند و در عین حال اصطلاحات سختگیرانه و ثبات صوتی را حفظ کنند.
- مدرسان دورههای آنلاین: کسانی که به تنظیمات تکرارپذیر — از جمله شخصیت صدا و میزان بلندی — در دهها درس مرتبط نیاز دارند. در این راستا، ابزارهایی مانند BhaShaVox با قابلیت ترجمه خودکار دورههای آنلاین به بیش از ۱۲۵ زبان استانداردهای جدیدی را برای مقیاسپذیری آموزشی تعریف کردهاند.
- آژانسهای تولید محتوا: کسانی که متریال حساس مشتریان را مدیریت میکنند و باید از جابجایی فایلهای خام پروژه بین چندین سرویس ابری خارجی اجتناب کنند.
با نگه داشتن منطق گوینده و صدا در داخل فایل پروژه، هوش مصنوعی از یک دموی جذاب به یک ابزار تولید تکرارپذیر تبدیل میشود. این رویکرد میپذیرد که در حالی که هوش مصنوعی کارهای سخت را انجام میدهد، بازبینی انسانی در زمینه محتوا و حقوق مالکیت همچنان اجباری است.
این تغییر به سمت تولید محلی نشاندهنده یک روند گستردهتر است که در آن «کمکگرفته از هوش مصنوعی» جایگزین «تولیدشده توسط هوش مصنوعی» میشود. ارزش دیگر در توانایی مدل برای ترجمه نیست، بلکه در توانایی تولیدکننده برای کنترل خروجی است. برای کسانی که با مالکیت معنوی ارزشمند یا حساس سروکار دارند، فاصله گرفتن از سیستمهای ابری اعتباری، هم یک مسئله اقتصادی است و هم یک مسئله امنیتی.
در آینده باید منتظر ظهور مدلهای زبانی کوچک (SLM) محلی و تخصصیتری بود که بتوانند این وظایف خاص ترجمه-زمانبندی را بدون نیاز به خوشههای GPU گرانقیمت مدیریت کنند.



گفتگو