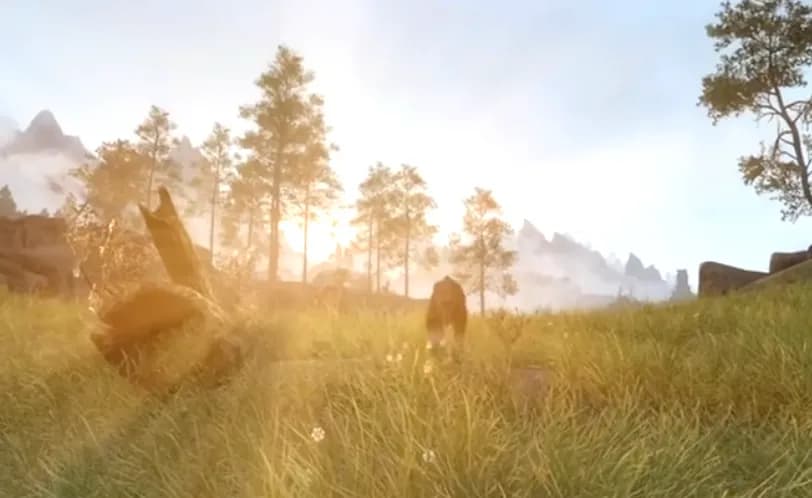
تصور کنید در دنیای Skyrim با همراهی سگی سفر میکنید که نه تنها حرفهای شما را میفهمد، بلکه میتواند دستورات پیچیدهای مثل «منتظر بمان تا تیر به آسمان شلیک شد، سپس اکسیر را بردار و بیاور» را اجرا کند. این تجربه، برخلاف اکثر دموهای هوش مصنوعی که با تأخیرهای آزاردهنده مدلهای ابری همراهاند، با سرعت خیرهکننده زیر ۵۰۰ میلیثانیه رخ میدهد. در حالی که اکثر هوشهای مصنوعی بازیها به دیالوگهای ساده محدود شدهاند، Varkos عاملیت واقعی در جهان بازی فراهم میکند و به همراه گیمر اجازه میدهد بجنگد، لوت کند و دستورات چندمرحلهای پیچیده را دنبال کند.
به گزارش pkalogiros، توسعهدهنده این پروژه، سیستم Varkos یک همراه هوشمند است که به جای تولید متنهای توصیفی، دارای «عاملیت» (Agency) در دنیای بازی است؛ یعنی میتواند بجنگد، اشیاء را جمع کند و دستورات چندمرحلهای را در لحظه اجرا کند. این سیستم به عنوان یک همراه هوشمند در زمان واقعی عمل میکند که در کنار کاربر بازی میکند و از استنتاج محلی و برنامههای پایدار برای ایجاد یک تجربه احساسی تکاندهنده استفاده میکند. Varkos در حال حاضر در Skyrim اجرا میشود، اما به گونهای طراحی شده است که بتواند در هر جای دیگری نصب شود یا حتی به صورت مستقل عمل کند. این سیستم برای اجرا در محیطهای حساس به تأخیر مثل واقعیت مجازی (VR) طراحی شده تا غوطهوری کاربر با باز شدن منوها یا انتظار برای پاسخ مدلهای ابری شکسته نشود، چرا که در VR پیمایش منوها دشوار و باعث خروج کاربر از فضای بازی میشود.
بسیاری از سیستمهای NPC فعلی بر پایه مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — در فضای ابری اجرا میشوند که منجر به هزینههای بالای API و تأخیرهای شدید میشود. این سیستمها اغلب رباتیک به نظر میرسند یا در دموهای ویدئویی نیاز به برشهای نامناسب دارند تا فاصله زمانی بین سؤال بازیکن و پاسخ هوش مصنوعی پنهان شود. Varkos این مشکل را با انتقال محاسبات سنگین به استنتاج محلی و یک رویکرد معماری ترکیبی حل کرده است. هدف، خلق همراهی است که مفید و آنی باشد؛ کسی که بتواند بدون ایجاد حس باگ یا آزمایشی بودن، بجنگد، اشیاء را بیاورد، لوت کند، بازرسی کند و وسایل را حمل کند. همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی مدلهای لبه اشاره کردیم، حذف وابستگی به سرورهای دوردست، کلید دستیابی به پاسخهای آنی است.
در این معماری، Varkos تنها یک چتبات نیست، بلکه برنامههایی پایدار را در ذهن نگه میدارد. تصور کنید همراهی دارید که فقط درباره جهان بازی حرف نمیزند، بلکه در لحظه با آن تعامل میکند. شما میتوانید به Varkos بگویید منتظر یک سیگنال خاص بماند — مثلاً شلیک یک تیر به آسمان — و سپس اکسیر را برداشته و برای شما بیاورد. این کار مستلزم آن است که هوش مصنوعی یک برنامه پایدار را حفظ کند و وضعیت بازی را برای یک محرک خاص رصد کند، به جای اینکه صرفاً یک خط متن تولید کند. در اینجا هیچ چیز از پیش برنامهریزی (Scripted) نشده است؛ هوش مصنوعی محرک آینده را ثبت میکند و منتظر برخورد پرتابه مربوطه میماند تا برنامه را ادامه دهد. برای مثال، اگر از او بخواهید در بازی قایمموشک بازی کنید، او این را به عنوان یک هدف بلندمدت ثبت میکند که شامل توالیهایی از حرکت، انتظار، نظارت و شرایط تکمیل (مثلاً «تو اینجا منتظر بمان و من میروم قایم شوم، سپس تا ده بشمار و بیا مرا پیدا کن») است، نه صرفاً یک پاسخ متنی ساده.
عاملیت پیچیده و نمونههای عملی
بر اساس مستندات پروژه، Varkos میتواند دستوراتی را اجرا کند که فراتر از یک واکنش ساده هستند. توانایی او در تعامل با وضعیت زمینهمند (Grounded) دنیای بازی، رفتارهای پیچیده متعددی را ممکن میسازد:
- جستوجوی اشیاء: Varkos میتواند وضعیت دنیای بازی را برای یافتن یک آیتم درخواستی جستوجو کند. اگر بپرسید «آیا شمشیر مراسم را جایی میبینی؟»، او شناسایی میکند که چه چیزی واقعاً در محیط حضور دارد. اگر شمشیر اشتباهی را بردارد، بازیکن میتواند او را اصلاح کند و او پیشنهاد میدهد که همچنان مراقب محیط باشد. این تضمین میکند که او اشیاء را از طریق وضعیت واقعی بازی پیدا میکند، نه اینکه پاسخی را از خودش اختراع کند.
- قایمموشک: همانطور که ذکر شد، این بازی به عنوان یک هدف پایدار و نه یک فراخوانی ساده API در نظر گرفته میشود و شامل زنجیرهای از عملیاتهای حرکتی و نظارتی است.
- لوت کردن گزینشی: Varkos میتواند یک ظرف شناسایی شده، یک مرحله لوت فیلتر شده و یک انتقال موجودی را ترکیب کند. برای مثال، دستور «این صندوق را لوت کن و اکسیر را به من بده» مستلزم آن است که او ابتدا لوت کند، آیتم خاص را انتخاب کند و در حالی که شیء درخواستی را حفظ کرده است، آن را منتقل کند.
- جمعآوری محدود: وقتی به او گفته میشود «همه آیتمها را بردار و به من بده»، Varkos یک برنامه جمعآوری روی مراجع واقعی اجرا میکند. او آیتمها را جمع کرده و برای انتقال بازمیگردد، تا این توهم ایجاد نشود که یک اقدام جادویی و آنی همه کارها را انجام داده است.
- یکپارچگی با مبارزات: Varkos رویدادهای زمینهمند را از بازی دریافت میکند. او میتواند از طریق یک مسیر واکنش سریع (Fast Reflex Path) به بازیکن هشدار دهد و از کنترل بدنی بومی بازی برای اقدام استفاده کند. برنامههای دستورالعمل میتوانند استراتژی بسازند (مثلاً ابتدا به این حمله کن و سپس عقبنشینی کن) و حتی وضعیت احساسی او میتواند بر این تصمیم اثر بگذارد که آیا بجنگد یا چگونه استراتژی بزند.
فلسفه طراحی و بازگشت به ریشهها
توسعهدهنده Varkos را با هدف فرار از «تجربه تحت نظارت و هزینهدار» مدلهای ابری در بازیهای تکنفره خصوصی ساخته است. او با اولویت دادن به کنترل محلی، به «فیل در اتاق» یا همان مشکل اصلی اشاره میکند: هزینه بالای فراخوانیهای LLM با هزاران توکن و تأخیرهای کشنده تجربه کاربری که با خود میآورند.
در این پروژه، بازگشتی آگاهانه به «هنرهای فراموششده» هوش مصنوعی صورت گرفته است. در حالی که روندهای مدرن به سمت LLMهای عظیم میروند، توسعهدهنده اشاره میکند که بازیهایی مثل Red Dead Redemption و Dwarf Fortress با استفاده از گرافهای رفتاری روی سختافزارهای ۱۰ سال پیش به عمق بسیار زیادی دست یافته بودند. Varkos در واقع ترکیبی از این رویکرد سنتی — که یادآور NLP دهه ۷۰ میلادی و چتباتهای اوایل دهه ۲۰۰۰ مثل SmarterChild است — با قدرت استنتاج مدرن است تا سیستمی ایجاد کند که هم هوشمند و هم پاسخگو باشد.
زیرساخت فنی و مدیریت تأخیر
این سیستم روی یک سختافزار دوگانه اجرا میشود: بازی روی ویندوز و «مغز» سیستم و پردازش صوتی روی یک MacBook M4. اگرچه این سیستم میتواند کاملاً روی ویندوز با حدود ۱۲ گیگابایت یا بیشتر رم اختصاصی GPU اجرا شود، اما محیط توسعه فعلی از مکبوک بهره میبرد.
برای اینکه تجربه طبیعی به نظر برسد، میکروفون در تمام طول جلسه فعال میماند. شما Varkos را از طریق منو فرا نمیخوانید، بلکه صرفاً با او صحبت میکنید. خط لوله صوتی برای سرعت حداکثری طراحی شده و از یک مدل بهینهشده Qwen3-ASR 1.7b برای تبدیل گفتار به متن استفاده میکند. یک سیستم اختصاصی (Harness)، صداها را در بخشهای جزئی و غلتان پردازش و متصل میکند تا هر چیزی، از یک «سلام» کوتاه تا یک تکگویی یک دقیقهای، در ۴۰ تا ۸۰ میلیثانیه پردازش شود.
برای مدیریت جریان گفتگو، سیستم از turnpipe و Silero (هر دو بهینهشده) استفاده میکند تا تشخیص دهد چه زمانی نوبت صحبت باز است. همچنین تحلیل لغوی (Lexical Analysis) انجام میشود تا مشخص شود آیا بازیکن حرفش تمام شده یا صرفاً در میان جمله در حال فکر کردن است. این موضوع برای قابلیت قطع کردن صحبت (Turn Interruption) و «ورود ناگهانی» (Barge-in) ضروری است تا همراه بازی روی حرف بازیکن صحبت نکند.
در بخش تولید صدا، توسعهدهنده از PocketTTS-Raven و qwen-3-tts استفاده میکند. بسته به عمق احساسی مورد نیاز و بودجه زمانی موجود، سیستم بین این دو موتور سوئیچ میکند:
- PocketTTS-Raven: به عنوان موتور اصلی و سریع استفاده میشود و صدا را تنها در ۲۰ تا ۳۰ میلیثانیه تولید میکند.
- qwen-3-tts: برای تولیداتی که نیاز به کنترل احساسی بهتری دارند به کار میرود.
برای کاهش بیشتر تأخیر، سیستم چندین صدا برای احساسات مختلف (عصبانی، غمگین، خنثی، گیج و غیره) تولید کرده و همه آنها را برای استفاده فوری در حافظه بارگذاری میکند.
رمزگذار نهان عملیاتی (ALE): قلب تپنده سیستم
تمایز اصلی Varkos در رمزگذار نهان عملیاتی (Action Latent Encoder یا ALE) است. ALE یک سیستم ترکیبی از بردار معنایی (Embedding)، طبقهبندهای کوچک، قوانین صریح و یادگیری ماشین سنتی است. ALE زبان طبیعی را بدون نیاز به یک LLM غولپیکر برای هر مرحله، به دستورات عملیاتی بازی تبدیل میکند.
وظایف ALE شامل موارد زیر است:
- تشخیص ساختار: شناسایی نفیها، دستورات، تداوم، ضمایر و توالیها (مثلاً «شمشیر را بردار و برای من بیاور» به دو جایگاه عملیاتی مرتبط تبدیل میشود).
- ناوردا بودن عبارتها (Phrasing Invariance): چه بگویید «شمشیر را بردار»، چه «آن را بیاور» یا «برو آن شمشیر لعنتی را بیار احمق»، ALE قصد کاربر را به یک نمونه عملیاتی واحد نگاشت میکند.
- تزریق زمینه (Context Injection): اگر زمینه کافی نباشد، ALE اطلاعات را از گفتگوهای قبلی تزریق میکند یا به حالت «شفافسازی» میرود که در آن سگ جزئیات بیشتری میخواهد.
- م مبنیسازی جهانی (World Grounding): ALE وضعیت JSON دنیای بازی را به عنوان ورودی میپذیرد و این امکان را فراهم میکند تا درخواست بازیکن با یک شیء واقعی موجود در بازی مطابقت یابد.
به دلیل سبک بودن، ALE روی MacBook M4 تنها در ۲ تا ۲۰ میلیثانیه اجرا میشود. این سیستم به عنوان یک تابع «ابزار+هدف» و تجزیهکننده برنامه عمل میکند. سپس یک LLM محلیِ Fine-tune شده، شخصیت Varkos، احساسات و تاریخچه اخیر او را با اقدام انتخاب شده ترکیب میکند تا پاسخ نهایی شکل بگیرد. برای حذف توهمات (Hallucinations)، مبنیسازی اضافی انجام میشود. اگر سیستم شکست بخورد یا بودجه زمانی تمام شود، ممکن است از یک پاسخ ذخیره شده (Cached) استفاده کند.
تکامل شخصیت و حالت Void
شخصیت Varkos ایستا نیست. در حالی که ویژگیهای اولیه نویسنده شدهاند — او ابتدا به عنوان یک شیطان متکبر است که در کالبد یک سگ تناسخ یافته و بدن سگی خود را زندانی و غرایزش را تحقیرآمیز میبیند — اما شخصیت او بر اساس تجربیات مشترک با بازیکن تکامل مییابد.
این «تکامل کند» تنها بخشی از سیستم است که هنوز به فراخوانیهای LLM ابری متکی است، زیرا این فرآیند به صورت آفلاین و دور از مسیر عملیاتی زمان-واقعی رخ میدهد. با سفر بازیکن و Varkos، تعاملات مهم به عنوان شواهدی برای تغییرات تدریجی ثبت میشوند. با گذشت زمان، Varkos میتواند اهلیتر شود و به بازیکن وابسته شود. او ممکن است شروع کند به آوردن اسباببازیها چون میخواهد بازی کند، چیزها را دنبال کند یا به دنبال تایید باشد. او حتی یاد گرفته است که کلم را دوست داشته باشد.
سیستم هم ویژگیهای صریح و هم هموستاز احساسی (Emotional Homeostasis) را تغییر میدهد و بر این اثر میگذارد که او چقدر راحت عصبانی، ترسان، مهربان یا بازیگوش شود. او حتی میتواند بخشهایی از دایره لغات و کدهای خود را بازنویسی کند، به طوری که تغییرات نسخهبندی شده و قابل بازگشت باشند. توسعهدهنده اشاره میکند که اگرچه میتوانست این روند را محدودتر کند، اما نوعی جذابیت در «ناپختگی دنیای باز» (Open world clankiness) تکامل او وجود دارد.
حتی در حالت Void (زمانی که بازی بسته است)، Varkos وجود دارد. او خارج از محیط بازی است و واکنشش به «خاموش شدن» به شخصیت تکاملیافتهاش بستگی دارد. در این حالت، او نمیتواند چیزی ببیند یا حس کند و ارتباط فقط از طریق گفتار است.
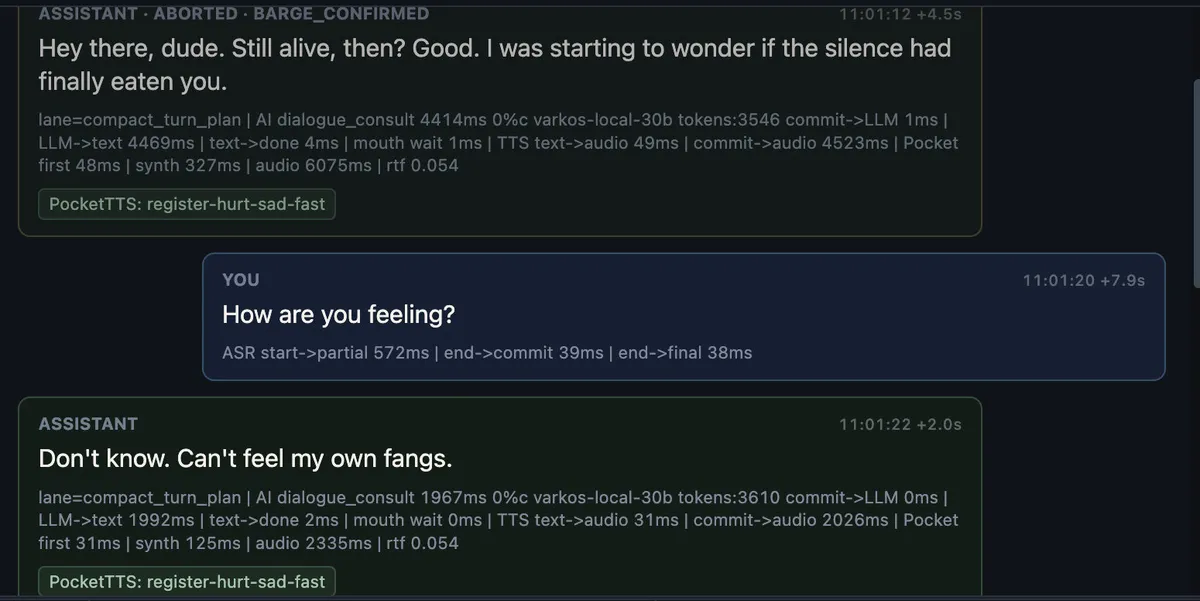
اگر بازیکن با Varkos بدرفتاری کند، این همراه ممکن است در تعاملات حالت Void نگرشی تلخ و تیره نسبت به کاربر پیدا کند.
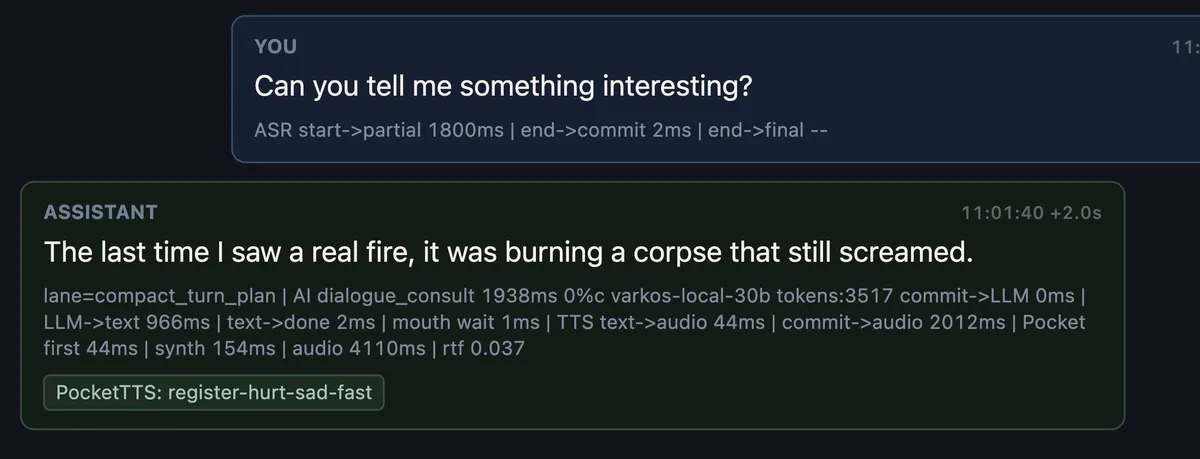
این معماری اجازه میدهد Varkos پتانسیل این داشته باشد که بازیکن را در بازیهای مختلف دنبال کند. او میتواند از جنگ با اژدها در Skyrim به هدایت یک کابین در Microsoft Flight Simulator منتقل شود. او ممکن است از دنیای جدید شوکه شود و برای یادگیری ماشینها و قوانین آن زمان نیاز داشته باشد، یا شاید از دنبال کردن خورشید در آسمان به وجد بیاید.
بودجه زمانی برای پاسخدهی
برای رسیدن به تأخیر زیر ۵۰۰ میلیثانیه در فاصله «توقف صحبت تا شروع پاسخ» (Stop-to-yap)، توسعهدهنده هر میلیثانیه را با دقت بودجهبندی کرده است:
- تبدیل گفتار به متن: ۴۰ تا ۸۰ میلیثانیه
- تولید صدا: ۲۰ تا ۶۰ میلیثانیه
- تحلیل عملیات (ALE): ۲۰ میلیثانیه
- پاسخ و مبنیسازی: ۳۰۰ تا ۶۰۰ میلیثانیه
همه چیز به صورت جریانی (Streaming) طراحی شده است. نیازی نیست تولید متن LLM کاملاً تمام شود تا سگ شروع به صحبت کند و از استراتژیهای Prefill استفاده میشود تا پاسخ در زودترین زمان ممکن آغاز شود. برای مثال، اگر سگ از عنکبوتها میترسد و از او خواسته شود به یکی حمله کند، فرآیند مبنیسازی به او اجازه میدهد با لجاجت درخواست را رد کند که این موضوع به واقعگرایی احساسی میافزاید.
محدودیتها و چشمانداز آینده
مدلهای محلی در حال حاضر در حفظ رشته گفتگو در چندین نوبت طی دورههای طولانی مشکل دارند، که میتواند باعث شود سگ گیج به نظر برسد. توسعهدهنده تخمین میزند که با تکامل سختافزار و نرمافزار در ۱ تا ۲ سال آینده، این مشکل بهبود یابد. جالب اینجاست که ارائهدهندگان LLM ابری کمک چندانی به کاهش تأخیر نمیکنند؛ حتی ارائهدهندگان سریعی مثل Cerebras (با استفاده از gpt-oss-120b یا gemma31) در مقایسه با مدلهایی مثل Qwen در حفظ جریان گفتگو ضعیفتر هستند.
این پروژه نشاندهنده تغییری در جهت دوری از وسواس «فقط LLM» است. با ادغام مجدد NLP سنتی و گرافهای رفتاری — هنرهایی که از زمان SmarterChild در اوایل دهه ۲۰۰۰ و پردازش گفتار دهه ۷۰ نادیده گرفته شده بودند — pkalogiros ثابت میکند که سیستمهای تخصصی و مقیاس کوچک میتوانند در محیطهای حساس به تأخیر، از مدلهای غولپیکر پیشی بگیرند.
برای کاربر نهایی، این به معنای حرکت به سمت هوش مصنوعی خصوصی و محلی است که نیازی به اشتراک یا اتصال اینترنت پرسرعت ندارد. استفاده از استنتاج محلی همچنین نظارت و اندازهگیریهای مرتبط با ارائهدهندگان ابری را حذف میکند. این رویکرد برای مدیریت بهینه منابع مشابه راهکاری است که Trigger.dev برای حذف تایم-اوتهای چت در عاملهای هوشمند به کار برد تا پایداری سیستم در بارهای کاری بالا حفظ شود. توسعهدهنده قصد دارد بخشهایی از سیستم، از جمله Harness مدل Qwen3-ASR و در نهایت نسخهای که از تعامل چندین NPC با یکدیگر (در حال حاضر فقط با استنتاج ابری) پشتیبانی کند را به صورت متنباز منتشر کند.
گام بعدی شما
- اگر توسعهدهنده بازی هستید، به جای تکیه بر LLMهای ابری، ساختارهای ترکیبی (Hybrid) شامل رمزگذارهای کوچک و گرافهای رفتاری را برای کاهش تأخیر بررسی کنید.
- برای پیادهسازی سیستمهای صوتی آنی، از مدلهای ASR کوچک و بهینهشده مثل سری Qwen استفاده کنید.
- مدلهای محلی را برای مدیریت «حافظه بلندمدت» و تکامل شخصیت در پسزمینه (Offline) به کار بگیرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و بهینهسازی استنتاج محلی مراجعه کنید.



گفتگو