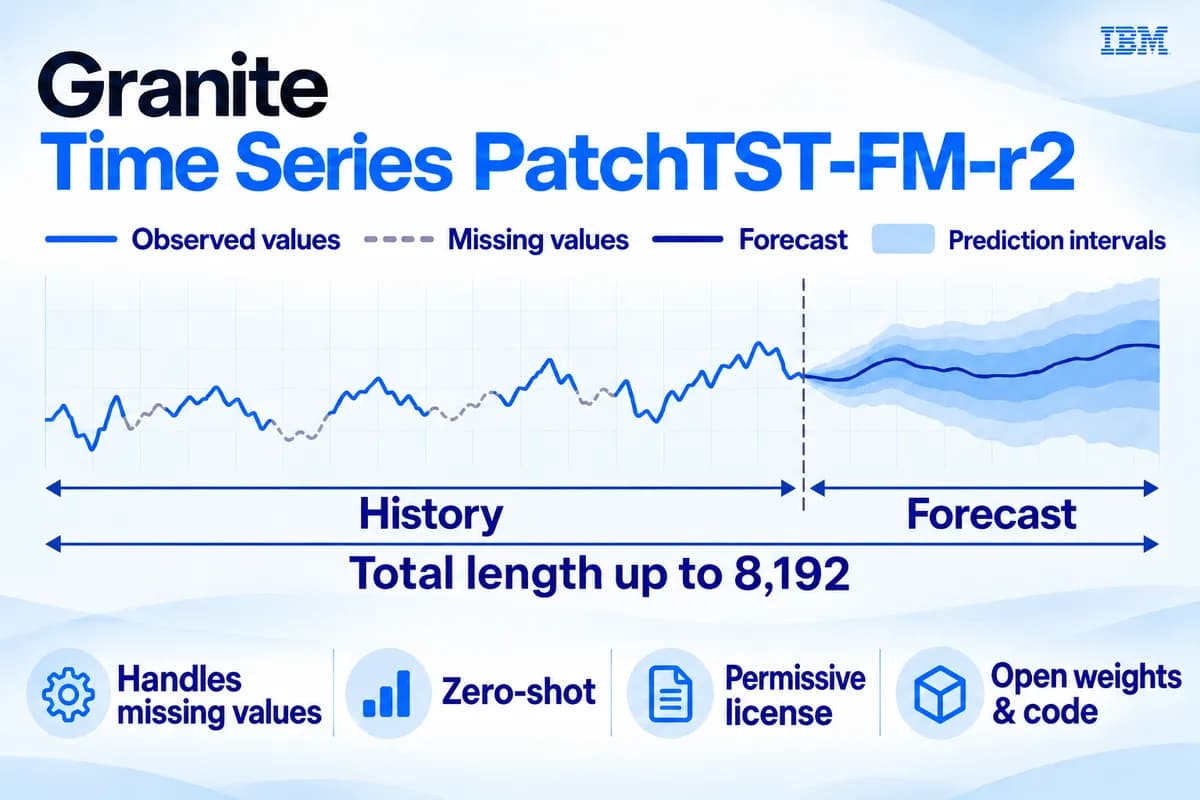
تصور کنید شرکتی را که برای پیشبینی دقیق بارهای انرژی، تقاضای بازار و دادههای تلهمتری، مجبور است برای هر مجموعه داده، یک مدل مجزا آموزش دهد. این فرآیند زمانبر و هزینهبر است. اما با انتشار مدل PatchTST-FM-r2 توسط IBM در ۸ سپتامبر ۲۰۲۶، این دشواری به پایان رسید و پیشبینیهای دقیق بدون نیاز به آموزش مجدد ممکن شد. این مدل در حال حاضر عنوان باکارآمدترین مدل پیشبینی Zero-shot را دارد که تحت یک مجوز تجاری باز (Permissive) در دسترس است.
پیشبینی سریهای زمانی — شبیه پیشبینی وضعیت ترافیک شهر بر اساس دادههای سالهای گذشته — بهطور سنتی نیازمند مدلهای سفارشی (Bespoke) برای هر جریان داده جدید بود. این موضوع برای شرکتهایی که هزاران حسگر یا واحدهای موجود کالا (SKU) را مدیریت میکنند، یک بار نگهداری عظیم ایجاد میکرد. اما مدلهای بنیادی (Foundation Models) — مثل یک متخصص همهفنحریف که اصول کلی دادهها را میداند و میتواند روی هر موضوع جدیدی نظر بدهد — این بازی را با قابلیت Zero-shot تغییر دادند؛ یعنی یک مدل پیشآموزشدیده میتواند مقادیر آینده را برای دادههایی که هرگز قبلاً ندیده است، پیشبینی کند.
جدیدترین عرضه IBM به عنوان بخشی از خانواده گستردهتر Granite TSFM معرفی شده است. این رویکرد در راستای توسعه اکوسیستم مدلهای Granite است که پیش از این در حوزههای دیگر نیز موفق بودهاند؛ برای مثال، مدل Granite Speech 5.0 توانست استانداردهای جدیدی را در تبدیل سریع صوت به متن تعریف کند. هدف این مدل، پر کردن شکاف میان مدلهای آکادمیک با عملکرد بالا و الزامات سختگیرانه بخشهای حقوقی شرکتها است. IBM با استفاده از یک مجوز سازگار با محیطهای تجاری، این مدل را به عنوان انتخاب پیشفرض برای هوش مصنوعی صنعتی آماده برای تولید (Production-ready) معرفی میکند.
زمینه و بنچمارکها
به نقل از مستندات IBM، برای ارزیابی این مدل از محک GIFT-Eval استفاده شده است. این یک بنچمارک جامع برای پیشبینی سریهای زمانی است که طراحی شده تا مدلها را در سناریوهای متنوع و روی مجموعهدادههای ناهمگون آزمایش کند. هدف اصلی این بود که اطمینان حاصل شود مدل به سریهای زمانی که بهطور خاص روی آنها آموزش ندیده است، تعمیم مییابد و از تله رایج «نشت داده» (Test Leakage) جلوگیری شود.
طبق گزارشهای منتشر شده در ۸ سپتامبر ۲۰۲۶، مدل PatchTST-FM-r2 در رتبه دوم کل مدلهای Zero-shot قابل بازتولید در جدول GIFT-Eval قرار دارد. اما وقتی دایره بررسی به مدلهایی محدود میشود که دارای مجوزهای باز و تجاری هستند، PatchTST-FM-r2 رتبه اول را به خود اختصاص میدهد:
- امتیاز CRPS: مدل به میانگین هندسی ۰.۴۶۷ رسید که آن را بلافاصله پس از TimesFM-3 در این مقایسه قرار میدهد.
- امتیاز MASE: این مدل عدد ۰.۶۸۴۶ را به عنوان میانگین هندسی ثبت کرد.
تحلیل عملکرد مقایسهای
نکته جالب این است که این مدل حتی در برابر مدلهای «پیشآموزشدیده» (Pretrained) که اجازه داشتند دادههای آموزش GIFT-Eval را ببینند، رقابتی عمل میکند. برخی از مدلهای موجود در جدول ردهبندی، به جای Zero-shot خالص، در دسته Pretrained قرار میگیرند؛ به این معنی که آنها میتوانستند بخشهای آموزشی مجموعهدادههای ارزیابی را در بدنه پیشآموزش خود بگنجانند.
حتی زمانی که این مدلهای پیشآموزشدیده به مقایسه اضافه میشوند، PatchTST-FM-r2 همچنان در نزدیکی صدر جدول باقی میماند. این مدل در رتبه سوم برای CRPS و رتبه چهارم برای MASE در میان مدلهای قابل بازتولید قرار دارد. همچنین، این مدل از چندین مدل پیشآموزشدیده از جمله Chronos-2، Timer-S1 و نسخههای مختلف Toto پیشی گرفت، در حالی که برخی از این رقبای مدل، از نظر اندازه بهطور قابل توجهی بزرگتر بودند.
تکامل معماری
تغییر اصلی در انتقال از نسخه r1 به r2، حرکت به سمت بلوکهای Conformer است. در حالی که نسخه r1 بر لایههای ترنسفورمر استاندارد — که ترکیبی از توجه چندسر (Multi-head Self-attention) و شبکه پیشخور (Feed-forward) بود — تکیه داشت، نسخه r2 اکنون کانولوشن زمانی (Temporal Convolution) را در کنار مکانیزم توجه ادغام کرده است.
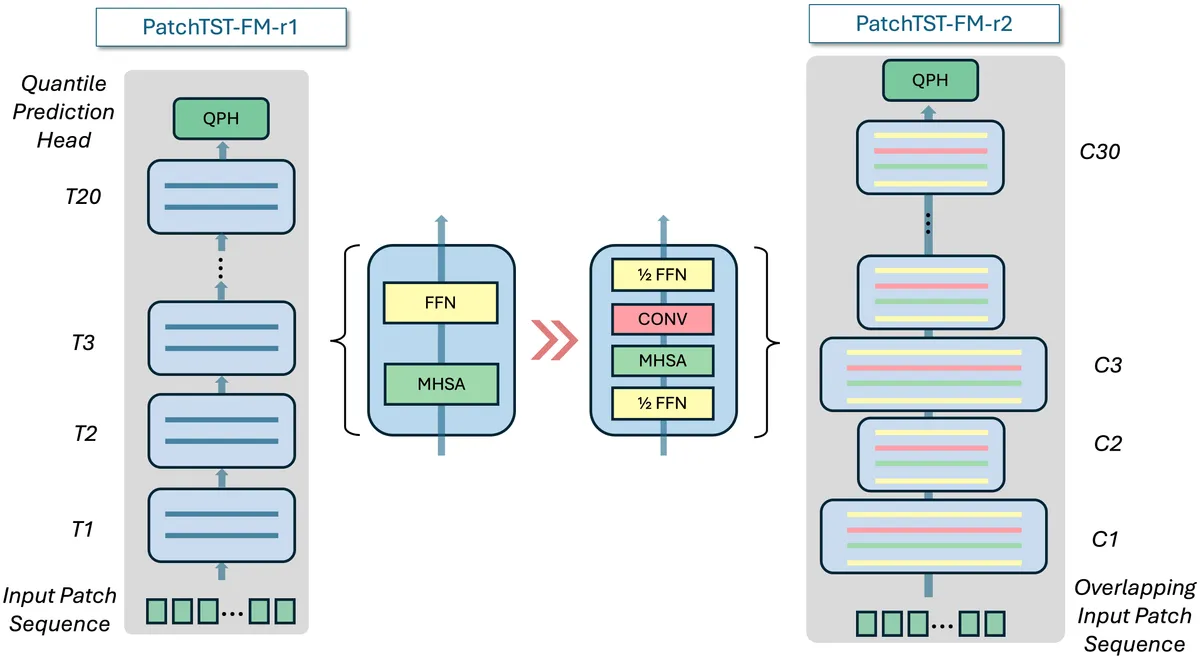
این رویکرد ترکیبی به مدل اجازه میدهد دو مقیاس زمانی متفاوت را بهطور همزمان مدیریت کند. لایههای کانولوشن ساختارهای محلی و کوتاهمدت را استخراج میکنند، در حالی که مکانیزم توجه بر روابط بلندمدت در سراسر سری زمانی تمرکز میکند. این طراحی مانع از آن میشود که مدل توجه خود را روی همسایگان نزدیک تلف کند، زیرا لایه کانولوشن پیش از آن این کار را انجام داده است.
این تفاوت در الگوهای توجه با استفاده از نمونههای واقعی از مجموعهداده ETTh1 مشهود است. در ترنسفورمرهای استاندارد، بخش قابل توجهی از توجه روی قطر ماتریس (روابط محلی) متمرکز است. اما در بلوک Conformer، توجه روی فواصل دور (دور از قطر) متمرکز میشود، زیرا لایه کانولوشن فواصل کوتاه را پوشش داده است.
جزئیات فنی
- مکانیزم Conformer: ستون فقرات مدل از بلوکهای سبک Conformer تشکیل شده که شامل دو لایه پیشخور نیمگام است که لایه توجه چندسر و یک لایه کانولوشن زمانی را احاطه کردهاند. این ساختار دو مکانیزم مکمل برای استدلال روی سری زمانی فراهم میکند.
- الگوی کرنل: بلوکهای کانولوشن از اندازههای متناوب ۳ و ۵ در یک الگوی تکرارشونده {۵، ۵، ۳، ۳} استفاده میکنند.
- تعداد پارامترها: حدود ۳۸۵ میلیون پارامتر.
- پنجره زمینه (Context Window) — مانند میز کاری که تعیین میکند مدل چقدر از دادههای گذشته را همزمان در ذهن دارد — تا ۸,۱۹۲ گام را پشتیبانی میکند.
- هموارسازی: استفاده از وصلههای ۵۰٪ همپوشان با وزندهی پنجره همینگ (Hamming-window) و پیشبینی با روش overlap-and-add برای حذف لبههای دندانهدار در پیشبینیها و افزایش دقت.
- عمق: افزایش تعداد بلوکها از ۲۰ به ۳۰ برای دستیابی به پایداری بیشتر در آموزش و استنتاج.
- خروجی: یک سر پیشبینی ۹۹-کوانتایل که هم پیشبینیهای نقطهای و هم خروجیهای کوانتایلی را برای ارائه توزیعهای پیشبینی و بازههای عدم قطعیت فراهم میکند.
- انعطافپذیری: پشتیبانی از طولهای پیشبینی متغیر و قابلیت جایگذاری (Imputation) مقادیر گمشده در دادهها.
شفافیت دادهها و مجوزها
بر اساس مستندات IBM، شفافیت در مورد دادههای آموزشی برای پذیرندگان سازمانی به اندازه عملکرد در جدول ردهبندی اهمیت دارد. IBM یک بدنه پیشآموزش مستند را ارائه کرده است تا نیازهای حاکمیتی شرکتها برآورده شود. دادههای آموزشی از چهار منبع اصلی تشکیل شدهاند:
- GiftEvalPretrain: مجموعهدادههای منتخب از این بنچمارک.
- KernelSynth: دادههای مصنوعی سفارشی با استفاده از کرنلهای متناوب اصلاحشده و تقویت (Augmentation) محدود.
- TSMixup: مجموعهای تولید شده با رویکرد Chronos، اما بهطور سختگیرانه محدود به دادههای خارج از مجموعه ارزیابی GIFT-Eval.
- CauKer: حدود ۵۰۰,۰۰۰ توالی مصنوعی CauKer که هر کدام دارای طول ۴,۰۹۶ هستند.
این شفافیت یک حرکت استراتژیک است. اکثر مدلهای بنیادی از مجموعهدادههای مبهم استفاده میکنند که بررسی عدم استفاده از دادههای محرمانه یا نشتشده را برای حقوقدانان شرکتها دشوار میکند. رویکرد IBM فرآیند بررسی داخلی را برای سازمانها تسهیل میکند، هرچند نیاز به بررسی حاکمیتی داخلی هر سازمان را از بین نمیبرد.
برای به حداکثر رساندن پذیرش، مدل تحت دو مجوز Apache 2.0 و OpenMDW 1.0 عرضه شده است. کاربران میتوانند هر کدام را که با چارچوب حقوقیشان سازگار است انتخاب کنند. مجوز OpenMDW که توسط بنیاد لینوکس ارائه شده، بهطور خاص برای مدلهای هوش مصنوعی طراحی شده است تا اطمینان شود وزنها، معماری و خط لوله استنتاج بدون حق امتیازهای محدودکننده، قابل تغییر و توزیع باشند.
ادغام در محیط تولید
برای توسعهدهندگان، این مدل از طریق بسته پایتون granite-tsfm (نسخه ۰.۳.۹ یا بالاتر) و Hugging Face Hub در دسترس است. این پیادهسازی با چکپوینتهای PatchTST-FM-r1 سازگار است. مدل را میتوان با استفاده از PatchTSTFMForPrediction.from_pretrained بارگذاری و از طریق TimeSeriesForecastingPipeline مستقر کرد.
این مدل از پیشبینی احتمالی (Probabilistic Forecasting) از طریق سر پیشبینی ۹۹-کوانتایل پشتیبانی میکند؛ به این معنی که تنها یک عدد واحد نمیدهد، بلکه یک محدوده از عدم قطعیت را ارائه میکند. این ویژگی آن را برای طیف وسیعی از کاربردها از جمله پیشبینی تقاضا، تلهمتری حسگرها، میزان استفاده از CPU، مصرف انرژی، حجم تراکنشها، ترافیک و ردیابی قیمتها مناسب میسازد.
فراتر از نوتبوکهای ایستا، IBM این مدلها را با Confluent Cloud ادغام کرده است. این همکاری که در ابتدای سپتامبر ۲۰۲۶ با هدف پیشبینی دادههای زنده از طریق SQL معرفی شد، امکاناتی را فراهم میکند که با بهرهگیری از Apache Flink، مدلها بتوانند استنتاج (Inference) — یعنی لحظهای که مدل واقعاً جواب تولید میکند — را مستقیماً روی جریانهای داده زنده انجام دهند. این یعنی نتایج پیشبینی و تشخیص ناهنجاری از جریانهای زنده تولید میشوند و نیازی به انتقال دادهها به یک محیط ML مجزا نیست.
پورتفولیوی اولیه موجود در برنامه دسترسی زودهنگام (Early Access) شامل موارد زیر است:
- PatchTST-FM-r1
- FlowState-r1.1
- TTM-r3
- TSPulse
این تغییر به سمت هوش مصنوعی جریانی (Streaming AI) به این معنی است که یک شرکت میتواند جهش در شبکه برق یا سقوط قیمت را در میلیثانیهها شناسایی کند، به جای اینکه منتظر اجرای یک پردازش دستهای (Batch) هر یک ساعت بماند.
برای حوزه هوش مصنوعی سریهای زمانی، این عرضه سیگنالی است که «قوانین مقیاسپذیری» (Scaling Laws) مدلهای زبانی بزرگ (LLMs) اکنون به پیشبینیهای زمانی منتقل شده است. ما از عصر «آمارشناس متخصص» که مدلهای سفارشی ARIMA میساخت، به سمت دنیایی از هوش زمانی همهمنظوره حرکت میکنیم.
گام بعدی شما
- وزنهای PatchTST-FM-r2 را از Hugging Face دریافت کرده و روی دادههای خصوصی خود تست کنید.
- دقت Zero-shot این مدل را با خط مبنای (Baseline) فعلی خود مقایسه کنید.
- اگر با دادههای جریانی (Streaming) سروکار دارید، ادغام با Confluent Cloud را بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو