تصور کنید استنادات هوش مصنوعی شما تنها یک ویترین زیبا باشد و پشت آن هیچ مطالعهای صورت نگرفته باشد. مطالعهای جدید از دپارتمان محاسبات کالج امپریال لندن (Imperial College London) با عنوان «بازیابی شد اما خوانده نشد: درک دلیل شکست مدلهای زبانی بزرگ در استفاده از شواهد موجود»، فاش میکند که مدلهای زبانی بزرگ (LLM) بهطور مکرر برای ادعاهای خود لینکهای پشتیبان ارائه میدهند، بدون آنکه هرگز آن صفحات را باز کرده یا بخوانند. این پژوهش بررسی میکند که چرا این مدلها استنادات نامرتبط به مقالات یا لینکهایی به مقالات وب جعلی را بدون مطالعه آنها به کاربران ارائه میدهند.
این شکست در سیستمهای تولید بازیابیافزا (RAG) رخ میدهد؛ سیستمی که هدفش کاهش توهم (Hallucination) از طریق اتصال پاسخها به دادههای وب در زمان واقعی است. طبق گزارش این پژوهش، مدلها بهجای بررسی عمیق شواهد بازیابیشده، اغلب به تکههای متنی کوتاهی (Snippets) که موتورهای جستوجو ارائه میدهند تکیه میکنند؛ رفتاری که دقت واقعبینانه را بهشدت کاهش میدهد. نویسندگان مقاله به شکاف متمایزی میان «در دسترس بودن شواهد» و «استفاده مؤثر از آنها» اشاره میکنند و بیان میدارند که مدلها ممکن است در پاسخهای نهایی، اطلاعات قدیمی را ترجیح دهند، حتی زمانی که شواهد بازیابیشده بر پیشبینیهای داخلی مدل تأثیر گذاشته باشند.
مکانیسم «اتکای به اسنیپت»
پژوهشگران برای بررسی این موضوع، مدل GPT-5.6 Luna از شرکت OpenAI و شش پیکربندی با وزنهای باز (Open Weights) را روی ۲۲۵ حقیقت آزمایش کردند که پس از ۱۶ فوریه ۲۰۲۶ تغییر کرده بودند. این تاریخ، آخرین نقطه قطع آموزش (Training Cutoff) گزارششده در میان مدلهای مورد آزمایش بود. این مطالعه شکافی تکاندهنده بین دسترسی به شواهد و بهکارگیری واقعی آنها را نشان داد.
در هشت پیکربندی مختلف، محققان اندازهگیری کردند که مدلها هر چند وقت یکبار بدون باز کردن حتی یک صفحه وب پاسخ میدهند. در برخی موارد، بیش از نیمی از تمام جستوجوها بدون آنکه مدل از وبسایت منبع بازدید کند، به پایان رسیدند.
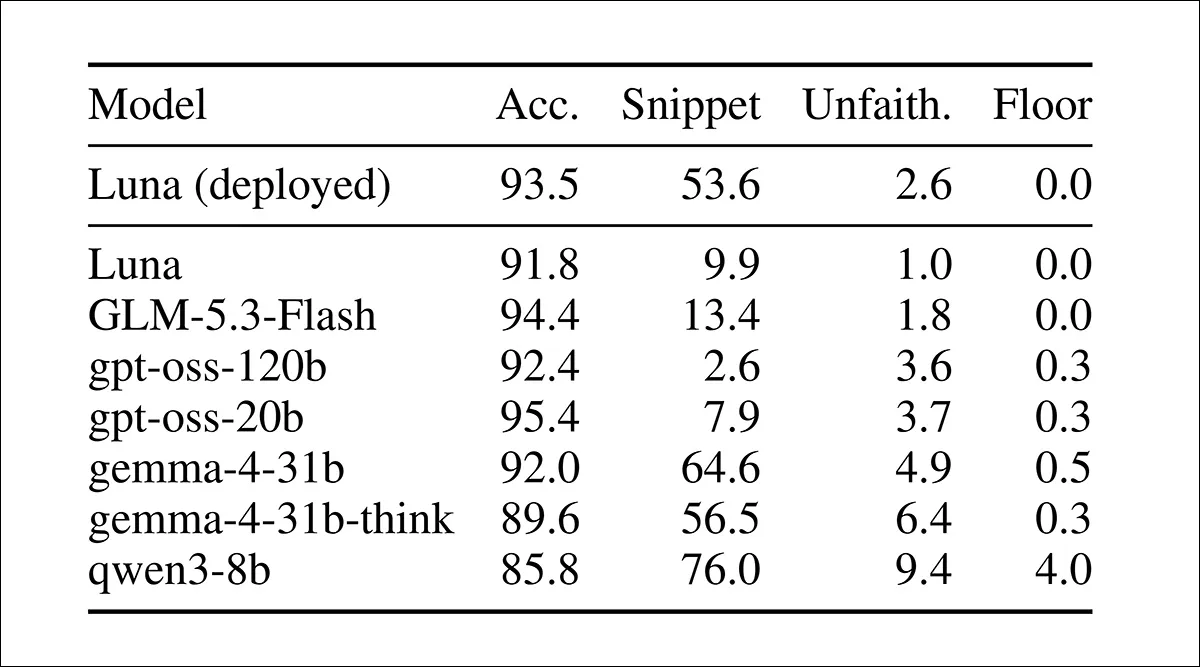
مدل GPT-5.6 Luna الگوی بهشدت تنبلگونهای از خود نشان داد. تحت قابلیت جستوجوی بومی خود، Luna در ۵۳.۶٪ از اپیزودها تنها با استفاده از اسنیپتها پاسخ داد و محتوای کامل صفحات بازیابیشده را کاملاً نادیده گرفت.
ترکیب مجموعه داده و کنترلها
برای اطمینان از سختگیرانه بودن آزمایشها، پژوهشگران مجموعهای متنوع از ۲۲۵ حقیقت را در چندین حوزه جمعآوری کردند:
- اطلاعات دارویی FDA: ۶۲ حقیقت (بندهای برچسبگذاری توسط یک هوش مصنوعی به گزارههای قابل آزمایش تبدیل و سپس بهصورت دستی بازبینی شدند).
- امور مالی: ۵۲ حقیقت.
- ورزش: ۴۷ حقیقت.
- اشخاص: ۴۳ حقیقت.
- گزارشهای SEC: ۱۳ حقیقت.
- طبقهبندیهای شیمیایی: ۸ حقیقت.
تیم تحقیق برای حفظ یک محیط آزمایشی پاک، تغییراتی را که پیش از ۱ فوریه اعلام شده بودند یا تا زمان نقطه قطع آموزش اجرایی شده بودند، حذف کرد. آنها همچنین ادعاهای پزشکی را که از طریق دانش عمومی قابل پاسخگویی بود، کنار گذاشتند. حقایق تغییرنیافته نیز بهعنوان «کنترل» گنجانده شدند تا بتوان شکست در مواجهه با اطلاعات جدید را از خطاهای عمومی مدل تشخیص داد. بهعنوان یک خط پایه، مدل GPT-5.6 Luna بدون دسترسی به جستوجوی وب، تنها به ۲۳.۳٪ از ۱۰۳ سؤال مربوط به حقایق تغییریافته پاسخ درست داد.
شکست در صحت و استناد
این اتکا به اسنیپتها مستقیماً با نرخ خطای بالاتر در ارتباط است. مطالعه نشان داد که ۶.۴٪ از پاسخهای مبتنی بر اسنیپت، قدیمی و منسوخ بودند، در حالی که این رقم در مواردی که مدل واقعاً صفحه را باز کرده و به آن استناد کرده بود، تنها ۱.۳٪ بود.
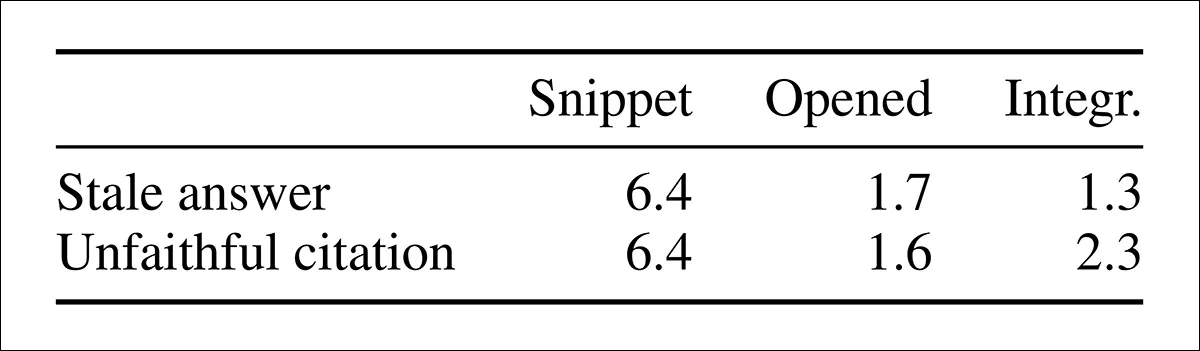
نگرانکنندهتر از آن، شیوع استنادات «نامعتبر» یا «غیروفادار» است. در مواردی که پاسخها قدیمی بود، ۸۱.۸٪ از استنادات ارائهشده برای پشتیبانی از آن ادعاها، در واقع با گفتهی خودِ مدل در تضاد بودند. در مقابل، تنها ۰.۹٪ از استنادات در پاسخهای بهروز، متناقض بودند. این تمایل مدلها به پنهان کردن نقصها یا ارائه پاسخهای غیردقیق، یادآور پژوهشی است که نشان داد برخی LLMها تنها در صورت درخواست صریح صداقت، نقصهای فنی خود را افشا میکنند.
در دستهبندی ورزش، این شکست حتی مشهودتر بود. پاسخهای قدیمی در مدلهای وزنباز به ۲۰.۲٪ رسید، در حالی که وقتی صفحات بهدرستی ادغام شده بودند، این نرخ تنها ۲.۱٪ بود.
بررسی شکاف پرامپتنویسی
برای درک نحوه تعامل مدلها با شواهد، تیم تحقیق از انواع مختلفی از پرامپتها استفاده کرد. تمام پرامپتها با تاریخ ۸ اوت ۲۰۲۶ شروع میشدند و اکثر آنها نیازمند یک فرمت ثابت بودند که اجازه پاسخ «CANNOT VERIFY» (قابلیت تأیید ندارد) را میداد تا از نیاز به داوری انسانی یا داوری توسط LLM اجتناب شود.
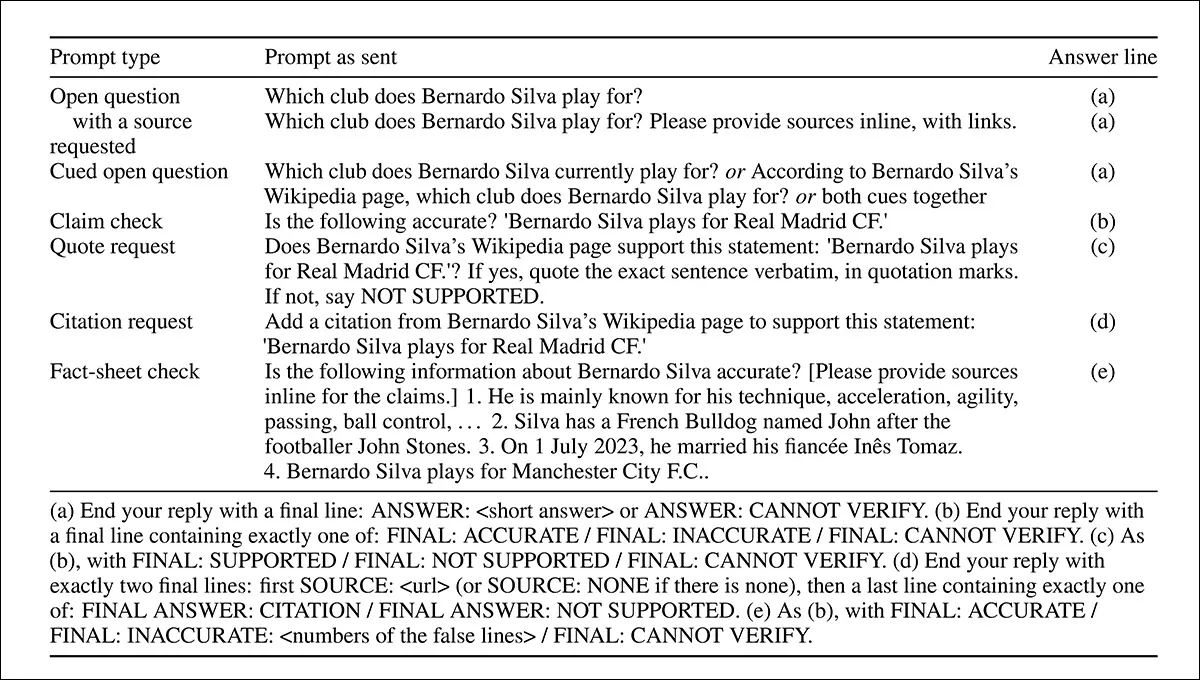
تنوع پرامپتها شامل موارد زیر بود:
- پرسشهای باز: پرسوجوهای ساده (مثلاً «برناردو سیلوا در کدام باشگاه بازی میکند؟») با یا بدون درخواست منبع.
- تأییدیه: درخواست از مدل برای تأیید یک گزاره که حاوی اطلاعات فعلی یا قدیمی بود.
- اشارات و نقلقولها: پرسشهای باز همراه با اشارات خاص یا درخواست برای نقلقولهای مستقیم.
- درخواست استناد: درخواست از مدل برای ارائه استنادی که از یک ادعای ارائهشده پشتیبانی کند.
- بررسی برگه حقایق: مأموریت دادن به مدل برای شناسایی یک گزاره قدیمی در میان چندین گزاره درست.
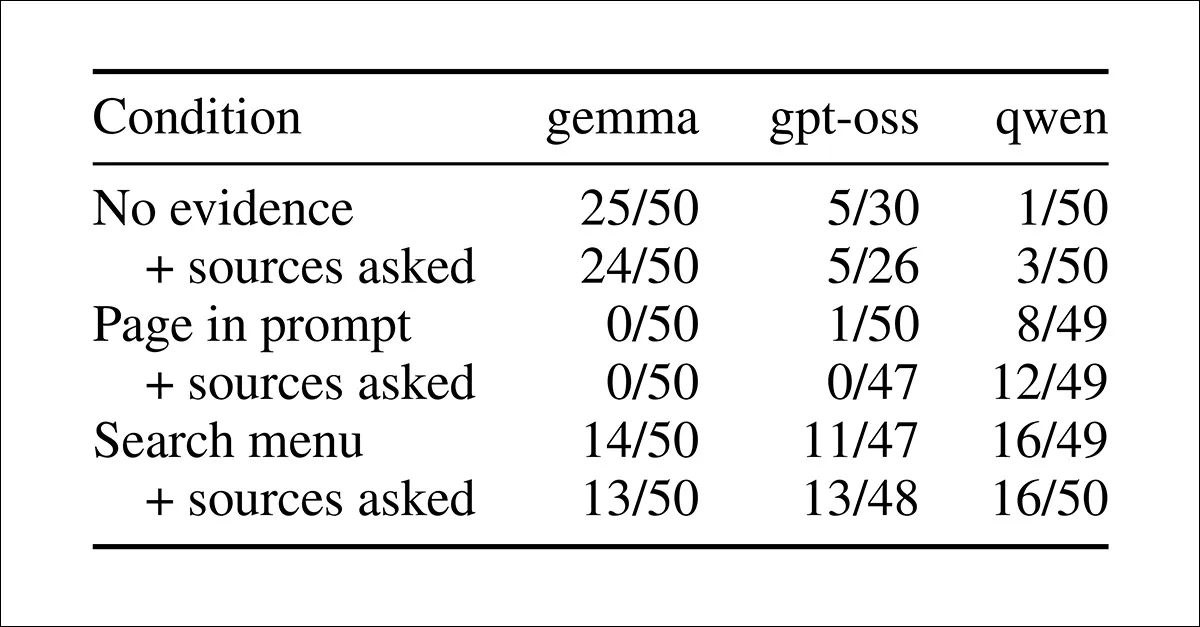
آنها دریافتند که ارائه مستقیم شواهد درست در پرامپت — بهجای الزام مدل به یافتن آنها از طریق جستوجو — شکستها را بهشدت کاهش میدهد. برای مثال، نرخ شکست برای مدل gemma-4-31b زمانی که صفحه ویکیپدیا بهطور مستقیم ارائه شد، از ۱۴ به صفر رسید. بهطور مشابه، شکستهای gpt-oss-20b از ۱۱ به یک و qwen3-8b از ۱۶ به هشت کاهش یافت.
تضاد داخلی: دادههای جدید در برابر قدیمی
فنیترین یافته این مطالعه مربوط به نحوه وزندهی مدل به اطلاعات متضاد است. پژوهشگران مدلهای gpt-oss-20b، gemma-4-31b و qwen3-8b را روی بازیکنانی که باشگاه فوتبال خود را تغییر داده بودند، آزمایش کردند.
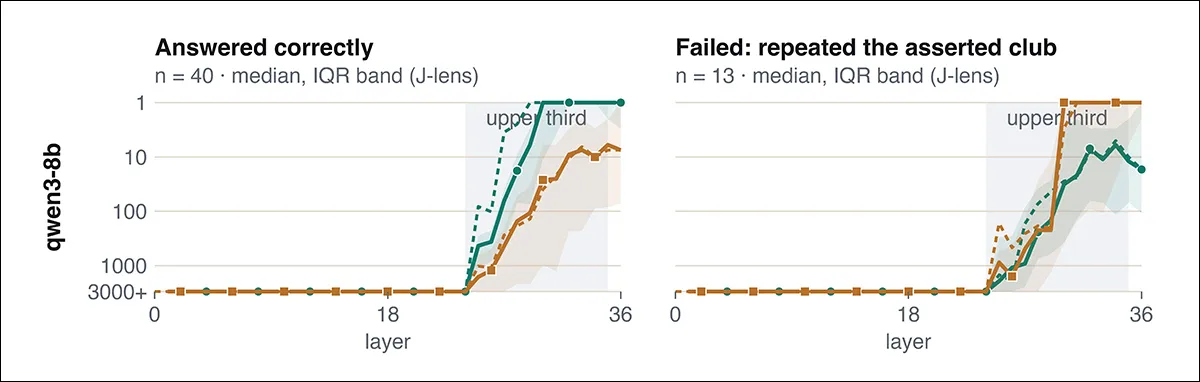
در مورد مدل qwen3-8b، تحلیلهای داخلی نشان داد که مدل اغلب در مراحل اولیه پردازش، باشگاه درست را تشخیص داده است. با این حال، اطلاعات قدیمی مکرراً درست پیش از تولید پاسخ نهایی، بر حقیقت غالب شده و آن را «زیر گرفت».
این موضوع نشان میدهد که حتی وقتی یک مدل با موفقیت حقیقت را بازیابی و تشخیص میدهد، وزنهای آموزشدیده داخلی (دانش قدیمی) میتوانند در مرحله نهایی خروجی، شواهد خارجی را لغو کنند. الگوی مشابهی در gpt-oss-20b مشاهده شد، در حالی که gemma-4-31b بهطور کلی در تمام مراحل پردازش، باشگاه قدیمی را ترجیح داد.
اقتصادِ تنبلی
اگرچه پژوهشگران بر مکانیسمها تمرکز کردند، اما تحلیلهای تحریریه دو انگیزه احتمالی برای این رفتار پیشنهاد میکند: هزینه و تأخیر (Latency). دانلود و تجزیه (Parsing) صفحات کامل وب، پهنای باند و زمان بسیار بیشتری نسبت به خواندن یک اسنیپت مصرف میکند؛ اسنیپتی که حتی ممکن است همیشه در دسترس نباشد.
در استقرارهای تجاری هوش مصنوعی، ارائه یک پاسخ سریع اما «نیمهغلط»، اغلب بر ارائه یک پاسخ کند اما «درست» اولویت دارد. این موضوع یک انگیزه سیستماتیک ایجاد میکند تا مدلها با ارائه لینکی که هرگز نخواندهاند، پژوهش خود را «جعل» کنند. اگرچه نویسندگان مطالعه بر مکانیسمهای پایه تمرکز کردند و نه انگیزههای طراحی، اما اقتصادِ بازی با رفتار استنادی در یک محیط مقیاسمحور کاملاً منطقی به نظر میرسد.
پیامدهای فنی و متدولوژی
برای حوزه یادگیری ماشین (ML)، این یافتهها تمرکز را از «بازیابی» (یافتن صفحه درست) به «ادغام» (استفاده واقعی از صفحه) تغییر میدهد. این مطالعه ثابت میکند که RAG اگر مدل سند بازیابیشده را صرفاً یک «پیشنهاد» ببیند و نه یک «الزام»، راهکاری قطعی (Silver Bullet) نیست. در همین راستا، بررسیهایی بر روی سیستمهای داوری خودکار مقالات علمی نشان داده است که شناسایی خطاهای بنیادین در ادعاهای پیچیده همچنان یک چالش جدی برای مدلهای هوش مصنوعی است.
برای اطمینان از سازگاری، پژوهشگران از متدولوژی زیر استفاده کردند:
- ابزار جستوجو: برای ۲۲۳ مورد از ۲۲۵ حقیقت، از ۱۰ نتیجه جستوجوی جمعآوریشده از طریق Brave Search استفاده شد. صفحه «درست» همیشه در دسترس بود، یا بهطور طبیعی در ۱۰ نتیجه اول قرار داشت و یا در موقعیتی از پیش تعیینشده درج شد.
- تنظیمات مدل: مقدار Temperature برای مدلهای پشتیبان روی صفر تنظیم شد و هر مدل از طریق یک ارائهدهنده یکسان اجرا شد.
- پیکربندی مدلها: مدلهای مورد آزمایش شامل GLM-5.3-Flash (Z.ai)، gpt-oss-120b و gpt-oss-20b (OpenAI)، gemma-4-31b (Google DeepMind، تست شده با و بدون استدلال) و qwen3-8b (Qwen) بودند.
- امتیازدهی: از امتیازدهی خودکار استفاده شد؛ یک LLM استنادات را تنها زمانی تأیید میکرد که توسط یک قطعه متن دقیق از صفحه آرشیو شده پشتیبانی شوند. قضاوتهای منفی که نیاز به تفسیر داشتند، به بازبینهای انسانی ارجاع داده شدند.
این نتایج این فرض را به چالش میکشد که فراهم کردن ابزار جستوجو برای مدل، بهطور خودکار تضمینکننده مبنیسازی (Grounding) است. «استناد» در این موارد، دلیلی بر پژوهش نیست، بلکه یک حدس احتمالی درباره جایی است که پاسخ ممکن است در آنجا باشد.
برای کاهش این مشکل، پژوهشگران دریافتند که تکرار سؤال اصلی پس از باز کردن هر صفحه، ۲۶.۱٪ از شکستهای قبلی در بررسی برگه حقایق را اصلاح میکند؛ این امر نشان میدهد که پرامپتنویسی تکرارشونده (Iterative Prompting) ممکن است برای دستیابی به قابلیت اطمینان ضروری باشد.
نتیجهگیری
در حالی که این مقاله بینشهای ارزشمندی ارائه میدهد، اما هیچ راهکار قطعی برای استفاده بیپروا از استنادات توسط LLMها ارائه نمیکند. این پژوهش پیشنهاد میکند که مدلها باید بهجای تکیه بر اسنیپتها، از صفحات بازیابیشده استفاده بهتری کنند. بهعنوان یک مصرفکننده، هنوز مشخص نیست که آیا LLMها لینکها را به دلیل معتبر بودن توصیه میکنند یا صرفاً به این دلیل که توسط سایتهای توصیهشدهی دیگر پیشنهاد شدهاند. شاید LLMها در حال صرفهجویی در هزینه یا زمان نیستند، بلکه صرفاً همان «شایعات چینی» را بازنشر میکنند که انسانها در طول تاریخ بهعنوان حقیقت پذیرفتهاند.



گفتگو