
اگر برای اپلیکیشنهای صوتی یا جستوجوی آنی کد میزنید، احتمالاً با «مالیات تأخیر» دستوپنجه نرم کردهاید؛ همان مکث آزاردهندهای که کاربر هنگام دریافت پاسخ میشنود. شرکت Inception در ۸ سپتامبر ۲۰۲۶ با معرفی Mercury 2.5 ادعا کرد که توانسته است سطح هوش مدل را ۴۰٪ افزایش دهد، بدون آنکه سرعت پاسخدهی فدا شود.
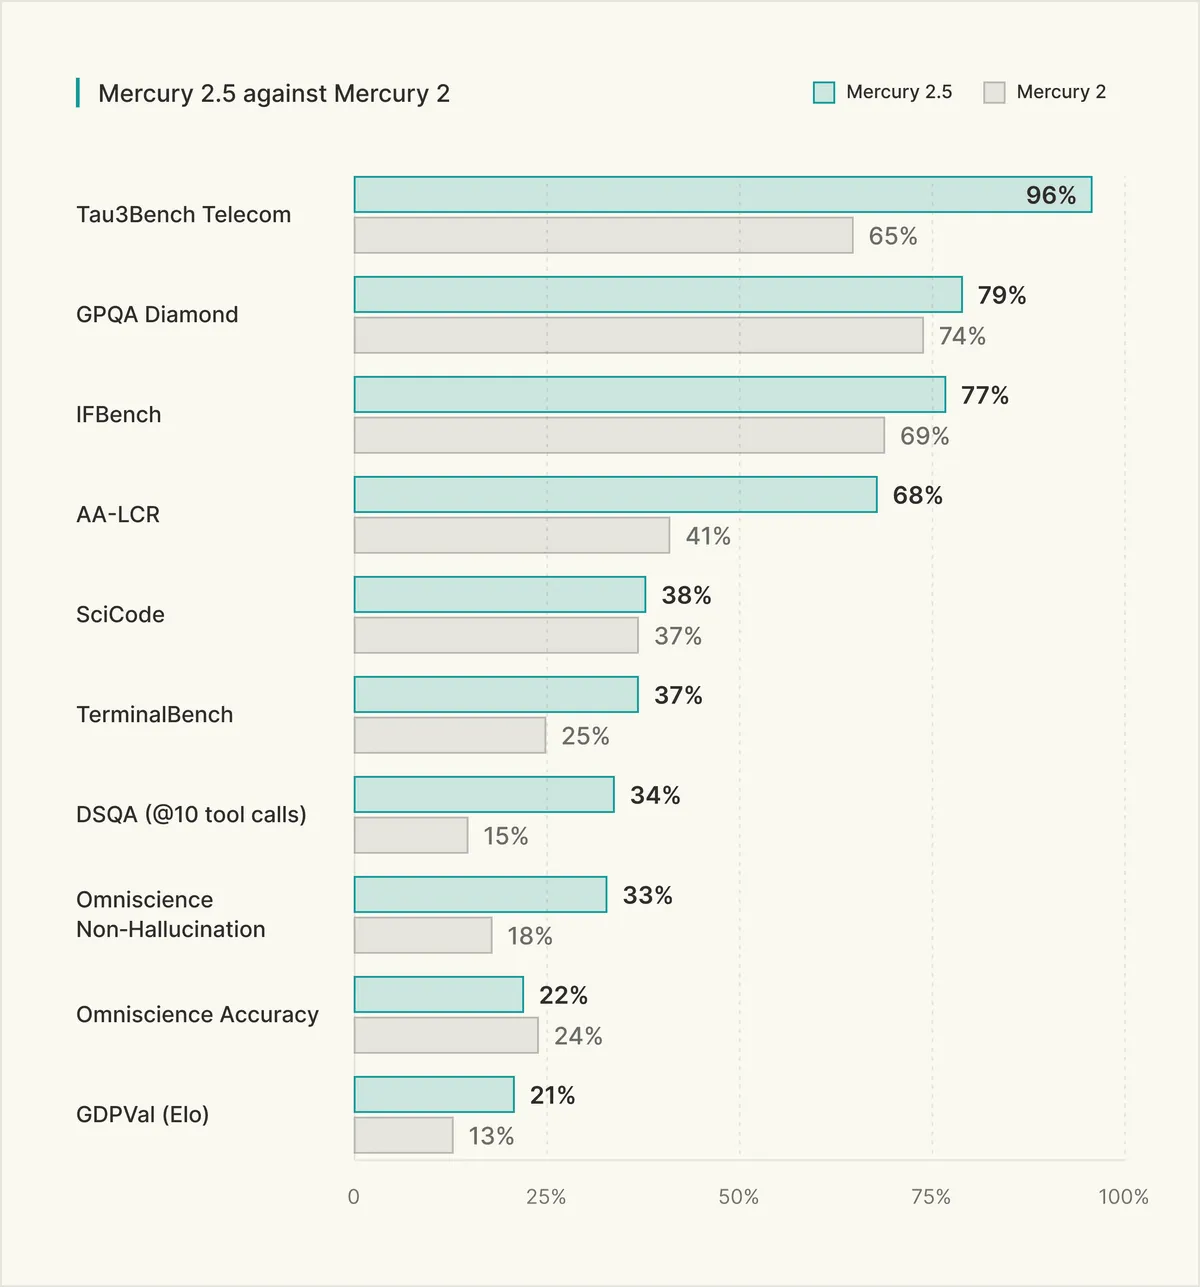
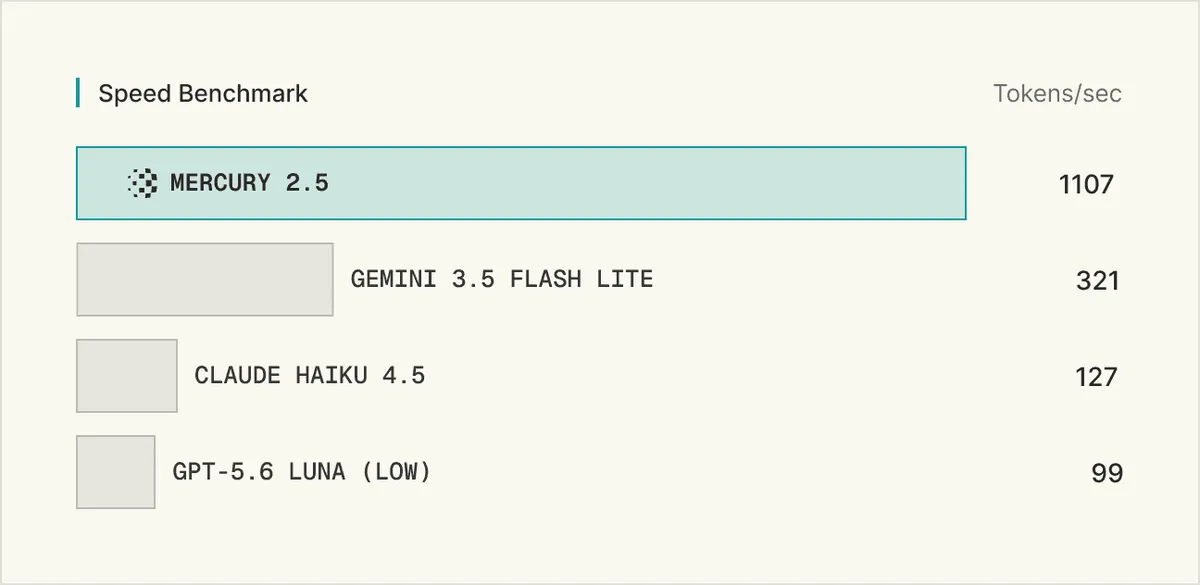
بسیاری از شرکتها در حال حاضر بین کیفیت استدلال و سرعت پاسخدهی گیر کردهاند. در حالی که مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — معمولاً برای دقت بیشتر، سرعت را قربانی میکنند، Inception از یک مدل انتشار (Diffusion Model) استفاده کرده است تا هزینهها را پایین نگه دارد و پاسخها را تقریباً آنی کند. این استراتژی باعث میشود Mercury 2.5 بتواند با مدلهای بهینهشدهای مثل GPT-5.6 Luna (Low) و Claude Haiku 4.5 رقابت کند. این رقابت در حوزه مدلهای سریع و بهینه، یادآور عملکرد جمینای ۳.۸ فلش است که اخیراً در بنچمارکهای کدنویسی نتایج درخشانی به ثبت رساند.
زمینه توسعه
به نقل از اعلامیه Inception، مدل Mercury 2.5 حاصل یک حلقه بازخورد از دادههای واقعی مشتریان و موارد شکست در محیط عملیاتی است. همانطور که در تحلیل قبلی ما دربارهی بهینهسازی مدلهای لبه اشاره کردیم، تمرکز بر دادههای دنیای واقعی بهجای بنچمارکهای آزمایشگاهی، دقت مدل را در محیط تولید بهشدت بالا میبرد. از زمان عرضه نسخه دوم، تعداد توسعهدهندگان این مدل را چندین برابر افزایش دادهاند. این رشد در جامعه توسعهدهندگان، مشابه پذیرش گسترده مدلهای وزنباز گوگل است که اکوسیستم AI را به سمت شخصیسازی بیشتر سوق داده است.
شروتی کوپارکار، مدیر ارشد محصول در گروه محاسبات شتابیافته NVIDIA، اشاره کرد که ترکیب هوش و سرعت پایدار در این مدل، نشان میدهد معماریهای جدید با چه سرعتی روی پلتفرم انویدیا به بلوغ میرسند. طبق مستندات فنی، Mercury 2.5 بزرگترین مدل زبانی مبتنی بر انتشار است که تاکنون آموزش دیده است. این مدل روی GPUهای استاندارد انویدیا به توان عملیاتی ۱۱۰۷ توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی که مدل تکهتکه میخورد — در ثانیه میرسد و از پنجره زمینه (Context Window) ۲۶۰ هزار توکنی پشتیبانی میکند.
عملکرد در محیط عملیاتی
Inception برای اثبات کارایی مدل در دنیای واقعی، چندین محک ارائه داده است:
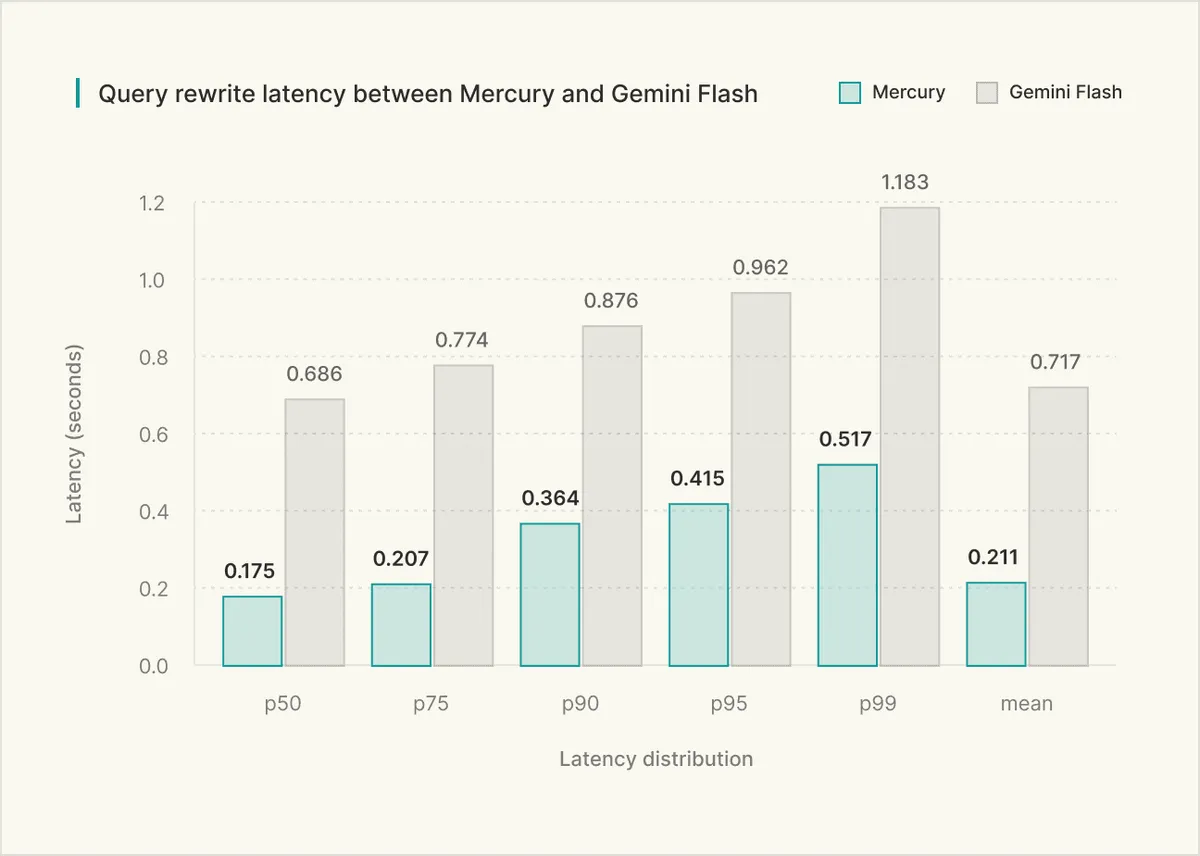
- عاملهای صوتی: شرکت OpenCall که عاملهای تلفنی میسازد، گزارش داد که تأخیر پاسخدهی در Mercury 2.5 به ۱۷۰ میلیثانیه رسیده است. اولیور سیلورستاین، مدیرعامل این شرکت، تأیید کرد که زمان پاسخدهی در بدترین حالت (P99) از چندین دقیقه به تنها یک ثانیه کاهش یافته است.
- دستیارهای کدنویسی: شرکت Augment Code از این مدل برای فشردهسازی زمینه و جستوجوی ابزارها استفاده میکند. طبق گزارش آنها، انتقال این فرآیندها به Mercury تأخیر را ۸۲٪ (از ۱۵۰ ثانیه به ۲۷ ثانیه) و هزینهها را ۹۰٪ کاهش داد.
- زیرساخت جستوجو: این مدل میتواند خط لولههای پیچیده تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — را با چنان سرعتی اجرا کند که تمام مراحل برنامهریزی، بازنویسی پرسوجو و چک کردن پاسخها در یک تعامل کاربر جای بگیرد.
قابلیتهای فنی
علاوه بر سرعت، Mercury 2.5 ویژگیهای جدیدی را برای توسعهدهندگان آورده است:
- استدلال قابل تنظیم: امکان تغییر عمق منطق مدل توسط برنامهنویس.
- فراخوانی موازی ابزارها: اجرای همزمان چندین ابزار توسط مدل.
- JSON منطبق با طرح: تضمین اینکه خروجی دقیقاً از ساختارهای دادهای تعریفشده پیروی کند.
قیمتگذاری و دسترسی
قیمت استاندارد این مدل ۰.۲۰ دلار برای هر میلیون توکن ورودی و ۰.۷۵ دلار برای هر میلیون توکن خروجی است. با این حال، Inception در زمان عرضه تخفیف ۸۰ درصدی ارائه داده که هزینه را به ۰.۰۴ دلار برای ورودی و ۰.۱۵ دلار برای خروجی میرساند. این مدل از طریق API شرکت Inception، Baseten و OpenRouter در دسترس است. در حالی که Mercury همچنان از مدل توکنمحور پیروی میکند، برخی شرکتها مانند Oxlo.ai تلاش کردهاند هزینه استنتاج را از تعداد توکنها جدا کنند تا مدلهای اقتصادیتری ارائه دهند.
این عرضه نشاندهنده تغییری در نحوه ساخت گردشهای کاری عاملمحور (Agentic) است. شرکتها میتوانند کارهای پشتیبانی مثل مسیریابی و جستوجوی ابزار را به یک مدل انتشار سریع بسپارند و مدلهای گرانقیمتتر را فقط برای استدلالهای بسیار پیچیده رزرو کنند. این رویکرد ترکیبی، هزینه کل مالکیت عاملهای هوش مصنوعی را بهشدت کاهش میدهد.
برای کسانی که اپلیکیشنهای صوتمحور میسازند، پیشنمایش Mercury Voice با زمان تا نخستین توکن (TTFT) زیر ۱۷۰ میلیثانیه بسیار حیاتی است. همچنین Mercury Router اکنون میتواند پرامپتها را بر اساس ترکیبی از کیفیت و هزینه، بهطور خودکار به بهترین مدل باز یا بسته هدایت کند.
Inception آموزش مدل بعدی و بزرگتر خود را آغاز کرده تا مرزهای کارایی مدلهای انتشار را در ماههای آینده جابهجا کند.
گام بعدی شما
- اگر از مدلهای گرانقیمت برای کارهای سادهای مثل مسیریابی (Routing) استفاده میکنید، مدل Mercury 2.5 را برای کاهش هزینه و تأخیر تست کنید.
- برای اپلیکیشنهای صوتی، روی کاهش TTFT تمرکز کنید و قابلیتهای Mercury Voice را بررسی نمایید.
- ساختار خروجیهای خود را با Schema-aligned JSON هماهنگ کنید تا خطاهای تجزیه داده در اپلیکیشن کاهش یابد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو