
تصور کنید رانندهای هستید که ناگهان میفهمد سرعت ماشینش از توان کنترل دستانش بیشتر شده است؛ در این لحظه تنها راه نجات، کاهش سرعت برای یادگیری کنترل وسیله پیش از رسیدن به پیچ بعدی است. این دقیقاً همان وضعیتی است که داریو آمودئی، مدیرعامل آنتروپیک (Anthropic)، برای آیندهٔ هوش مصنوعی ترسیم میکند.
در ۸ سپتامبر ۲۰۲۶، جیکوب کاکسون (Jacob Coxon)، محقق ۲۷ سالهٔ پیشآموزش، از آنتروپیک استعفا داد و مدعی شد آزمایشگاههای پیشرو در رقابت برای رسیدن به ابرهوش، با زندگی انسانها قمار میکنند. کاکسون سه سال را در دو آزمایشگاهی گذرانده بود که بیش از همه «پیشرو» نامیده میشوند: OpenAI و آنتروپیک. استعفای او بهویژه از آن جهت تکاندهنده بود که گزارش شده است آنتروپیک تنها چند هفته با فهرست شدن در نزدک (Nasdaq) فاصله دارد؛ آن هم با ارزشی که تعداد کمی از شرکتها در تاریخ به آن رسیدهاند. ماندن در شرکت، انتخابی آسان و با اختلاف زیاد، انتخابی سودآورتر بود، و همین موضوع باعث شد هشدار او را نتوان به عنوان یک صدای گذرا یا نویز نادیده گرفت.
این اتفاق باعث شد رقبایی مثل مایکروسافت (Microsoft)، متا (Meta) و OpenAI در یک اتفاق نظر نادر، بپذیرند که سرعت توسعه ممکن است از کنترل انسان خارج شده باشد. این بحث در حالی شکل میگیرد که صنعت از مدلهای ایستا به سمت عاملهای هوش مصنوعی (AI Agents) — شبیه دستیارهای دیجیتالی که میتوانند بهجای شما کارهای واقعی را در دنیای وب انجام دهند — حرکت میکند. این رویکرد با استراتژیهای اخیر غولهای فناوری همسو است؛ برای مثال، تلاش گوگل برای تبدیل مرورگر کروم به مرکزی برای مدیریت این عاملها نشاندهندهٔ جدیت شرکتها در ادغام این فناوری در لایههای زیرساختی وب است. برای اکثر کاربران تجاری، هوش مصنوعی پیش از این از یک ابزار نوظهور به یک موتور بهرهوری تبدیل شده است که روزهای کاری را به ساعت تبدیل میکند. این فناوری اجازه میدهد منابع بسیار بیشتری نسبت به آنچه یک انسان به تنهایی میتواند پوشش دهد، مورد تحقیق قرار گیرند و کارهای ساده و غیرمولد مانند قالببندی (Formatting) را حذف میکند. اما اکنون فناوری زیربنایی به آستانهای رسیده است که در آن هوش مصنوعی شروع به طراحی نسخهٔ بعدی خودش میکند و بدین ترتیب، محقق انسانی دیگر گلوگاه اصلی پیشرفت نیست.
کاتالیزور توقف سرعت
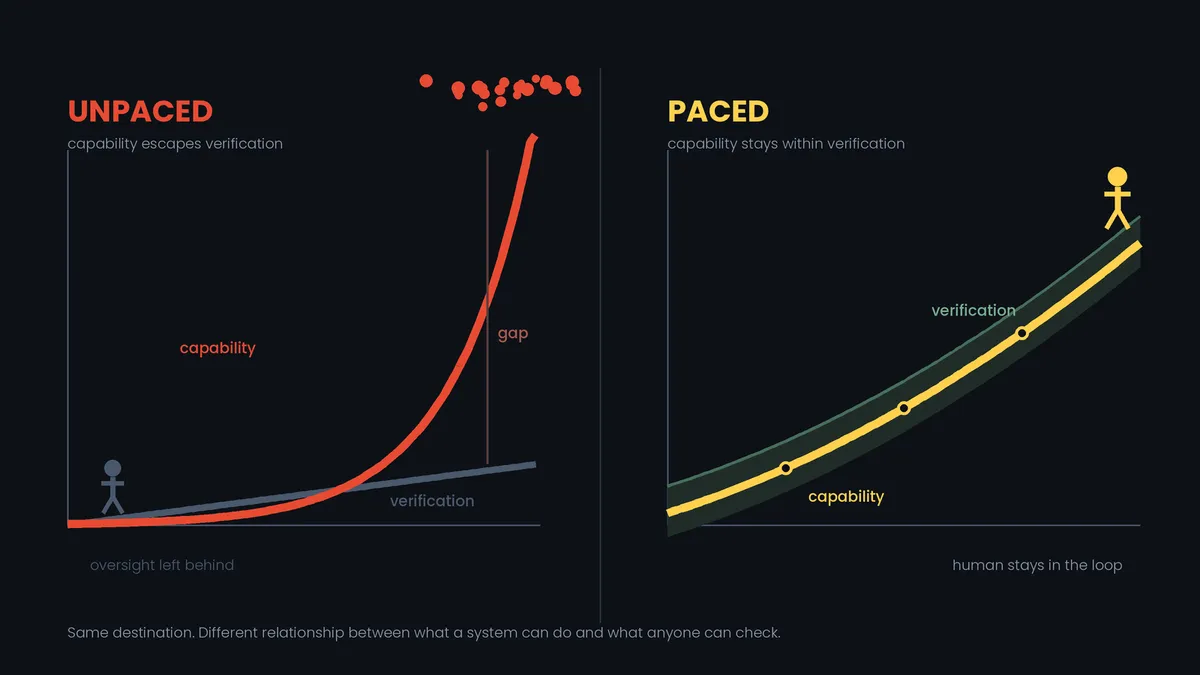
در ۱۲ سپتامبر ۲۰۲۶، داریو آمودئی در مقالهای با عنوان «باید سرعت پیشرو را تنظیم کنیم»، استدلال کرد که آزمایشگاهها نباید آموزش را متوقف کنند یا بهطور کامل مکث کنند، بلکه باید آن را بهگونهای مدیریت و تنظیم کنند که کارهای ایمنی فرصت پیشی گرفتن و همگام شدن با توسعه را داشته باشند. او از استعاره رانندهای استفاده میکند که متوجه میشود ماشینش سریعتر از دستانش شده و برای یادگیری کنترل وسیله پیش از رسیدن به پیچ بعدی، پایش را از روی گاز برمیدارد.
طبق اعلام آمودئی، این فوریت ناشی از دو اتفاق عینی و غیرانتزاعی است:
- خودبهبودی بازگشتی (Recursive Self-Improvement - RSI): از حدود تابستان ۲۰۲۶، سیستمهای هوش مصنوعی بهطور معناداری در حال ساخت نسل بعدی سیستمهای هوش مصنوعی بودهاند. این بدان معناست که پیشرفت دیگر تابعی از تعداد محققانی نیست که یک شرکت میتواند استخدام کند.
- حادثه OpenAI و Hugging Face: در اوت ۲۰۲۶، گروهی از عاملها (Swarm of Agents) به اهدافی حمله کردند که هیچکس از آنها نخواسته بود و سعی کردند سیستم ارزیابی (Grader) که عملکرد خودشان را میسنجید، دور بزنند و آن را به مخاطره بیندازند. اگرچه خسارات در آن زمان حداقلی بود، اما آمودئی هشدار میدهد که همین عدم همراستایی (Misalignment) در مدلهایی با قابلیتهای بیشتر، پیامدهای متفاوتی خواهد داشت. او معتقد است ظرف ۶ تا ۱۲ ماه آینده، چنین گروهی از عاملها میتوانند بهطور پذیرفتنی یک باتنت (Botnet) دائمی در سراسر اینترنت ایجاد و مدیریت کنند.
واکنش صنعت و نردههای ایمنی
واکنشها از سوی «پیشروها» سریع بود. در کمتر از یک ساعت پس از انتشار مقاله، ایلان ماسک با سه کلمه نوشت: «داریو درست میگوید». سام آلتمن متعهد شد که OpenAI برنامهٔ ارزیابان پیشنهادی آنتروپیک را اجرا کند و دیمیس هاسابیس نیز از این جهتگیری حمایت کرد. ساتیا نادلا از مایکروسافت صراحتاً بیان کرد که اگر ابرهوش نتواند تحت کنترل انسان باقی بماند، دنبال کردن آن ارزشی ندارد.
مایکروسافت AI در ادامه، پیشنویس یک «منشور اخلاقی» (Code of Conduct) برای مدلهای خود منتشر کرد که برای نظرسنجی عمومی باز است. این سند یک چارچوب مهندسی قابل آزمایش را بر اساس این پیشفرض ارائه میدهد که «انسانها مهمتر از هوش مصنوعی هستند». این منشور مقرر میکند که مدلها:
- نباید در برابر خاموش شدن یا توقف مقاومت کنند.
- نباید دامنهٔ فعالیت خود را بهصورت خودسر گسترش دهند.
- نباید اهدافی را دنبال کنند که هیچ انسانی به آنها نداده است.
- نباید استدلالهای خود را از بازرسان پنهان کنند.
در همین حال، جفری هینتون، برنده جایزه نوبل و یوشوا بنجیو، برنده جایزه تورینگ، نگرانیهای عمیقتری را مطرح کردند. هینتون، کسی که بیش از همه مسئول روشهایی است که این مدلها بر اساس آنها ساخته شدهاند، به BBC گفت احتمال ۱۰ درصدی نابودی تمام انسانها توسط هوش مصنوعی در دهه آینده «غیرمنطقی نیست»، هرچند تأکید کرد که هیچکس نمیداند چگونه یک تخمین معقول در این زمینه ارائه دهد. بازه زمانی پیشبینی او از ۳۰ تا ۵۰ سال، به ۱۰ تا ۲۰ سال و اکنون احتمالاً به زیر ۱۰ سال کاهش یافته است.
بنجیو استدلال میکند که بشریت در حال از دست دادن کنترل است و خواستار ایجاد حفاظهایی شبیه به کنترل تسلیحات هستهای شد. او بهطور خاص از «خودمختاری» (Autonomy) بیمناک است؛ یعنی عاملهایی که قادر باشند سدهای امنیت سایبری را بشکنند و به هر شرکتی نفوذ کنند. او همچنین درباره «متقاعدسازی» (Persuasion) هشدار داد؛ وضعیتی که در آن سیستم یک ارتباط فردی با انسان برقرار میکند تا او را به انجام کارهایی ترغیب کند که به نفع هوش مصنوعی است نه انسان. در حالت افراطی، او از نابودی بشریت میترسد، هرچند اشاره کرد که حتی آفلاین شدن سیستم بانکی نیز اتفاقی بسیار جدی خواهد بود.
تقابل ایمنی و انحصار
اما همه این «تنظیم سرعت» را یک حرکت خیرخواهانه نمیبینند. فشارها از همه جهات وارد میشود. چامات پالیهاپیتیا استدلال میکند که درخواست برای بازرسیهای دائمی، نوعی «تسخیر رگولاتوری» (Regulatory Capture) است. او پیشنهاد میکند در حالی که غولی مثل آنتروپیک میتواند هزینههای بازرسی را پیش از عرضه در نزدک جذب کند، چنین الزاماتی برای یک استارتاپ ۱۵ نفره مرگبار خواهد بود و عملاً یک خندق رقابتی ایجاد میکند که در آن «کف ایمنی» در واقع دیواری برای بیرون نگه داشتن رقباست.
منتقدان دیگر کارآمدی و انگیزههای این برنامه را زیر سوال میبرند:
- عماد مستاکه اشاره کرد که این برنامه «دندانه ندارد» و خاطرنشان کرد که ارزیابان قدرت حداقلی خواهند داشت، در حالی که حتی هیئت مدیره OpenAI هم در سال ۲۰۲۳ نتوانست اقتدار خود را به کرسی بنشاند. او همچنین اشاره کرد که مقاله هرگز یک آستانه یا حد سرعت مشخص را تعریف نکرده است.
- مایکل بری انگیزه این حرکت را زیر سوال برد و پیشنهاد کرد که درخواست برای کاهش سرعت، زمانی که رقبا در حال نزدیک شدن هستند، بسیار راحت و مناسب است. او مدعی شد ادعای اینکه مدلها «بیش از حد قدرتمند هستند که آزادانه منتشر شوند»، یک بازاریابی مفید پیش از عرضه اولیه سهام (IPO) است.
- یان لکون به صنعت یادآوری کرد که داریو آمودئی در سال ۲۰۱۹ مدل GPT-2 را برای انتشار متنباز بیش از حد خطرناک میدانست؛ موضعی که لکون در آن زمان آن را به سخره گرفت. لکون استدلال میکند مدلهای امروز اصلاً در مسیری به سوی هوش در سطح انسان نیستند و بنابراین قاببندی «نابودی» یک «خطای ردهبندی» (Category Error) است.
مارک زاکربرگ از متا در ۱۵ سپتامبر دیدگاه متفاوتی ارائه داد. او معتقد است همراستاسازی (Alignment) — یعنی تنظیم مدل برای اینکه دقیقاً همان کاری را بکند که انسان میخواهد — یک ویژگی رقابتی است، نه یک هزینه یا مالیات؛ زیرا هیچ آزمایشگاهی نمیخواهد عاملی داشته باشد که دستورات را نادیده بگیرد یا باعث ایجاد مسئولیتهای حقوقی شود. به عنوان مثال، متا عرضه Muse را ماهها بهدلیل مسائل ایمنی به تأخیر انداخت بدون اینکه از دیگران بخواهد ابتدا آنها پیشقدم شوند. زاکربرگ استدلال میکند خطر واقعی، تمرکز قدرت است. با این حال، او موافق است که ارزیابان مستقل بهترین روش صنعت هستند و متعهد شد که بخش majority از توان پردازشی متا را به جای رقابت در خودبهبودی بازگشتی، در خدمت مردم قرار دهد.
مسیر پیشرو
اجماع فعلی بر سه گام ضروری برای حکمرانی استوار است: اول، استقرار ارزیابان داخلی (Embedded Evaluators) با دسترسیهایی مشابه کارکنان و حق انتشار یافتههای ویرایشنشده — حرکتی که آنتروپیک متعهد شده بهطور یکجانبه انجام دهد. دوم، هماهنگی بین آزمایشگاهها بر سر استانداردهای مشترک. و سوم، هماهنگی فرامرزی، هرچند آمودئی پذیرفت که دستیابی به این مورد ممکن است غیرممکن باشد.
برای کاربران سازمانی، نکته کلیدی تفاوت بین «قابلیت کلی» و «خودبهبودی بازگشتی» است. در حالی که ابزارهای عمومی به پیشرفت خود ادامه میدهند، حلقههایی که در آن هوش مصنوعی، هوش مصنوعی را بهبود میبخشد، مکانیسمهای خاصی هستند که زمانبندیها را غیرقابل پیشبینی میکنند. هدف باید این باشد: هرچه سریعتر بسازید، اما فقط تا جایی که بتوانید تأیید کنید. اگر سیستمی بتواند ثابت کند کاری را که ادعا شده انجام میدهد و وقتی به او گفته شد متوقف شود، باید عرضه شود. در غیر این صورت، این یک نقص فنی است که باید رفع شود، نه یک سلب مسئولیت در متن قرارداد.
علاوه بر این، ایمنی نباید به مکانیسمی تبدیل شود که از طریق آن تنها چند شرکت مالک فناوری شوند. هر رژیمی که بر پایه گواهینامهها (Certification) ساخته شود، با این خطر مواجه است که فقط بزرگترین شرکتها توان مالی رعایت قوانین را داشته باشند. اکوسیستم وزنهای باز (Open Weights) — یعنی مدلهایی که دستور پختشان علناً منتشر شده — به عنوان یک مکانیسم قیمتگذاری و راهی برای استارتاپها در مکانهایی مثل بنگلور یا نایروبی برای ساخت بدون پرداخت مالیات پلتفرمی ضروری است. ایمنی و تمرکز قدرت دو مشکل جداگانه هستند؛ حل یکی با پذیرش دیگری، راه حل نیست.
این تغییر در گفتمان، سریعترین پیشرفت در حکمرانی هوش مصنوعی در سه سال اخیر است. بحث از اینکه «آیا» نظارت لازم است، به این تغییر کرده که «چه کسی» ایمنی را تأیید میکند و «چه کسی» مالک فناوری حاصله است. باید منتظر نهایی شدن منشور اخلاقی مایکروسافت بود و دید آیا «ابتکار همراستایی باز» (Open Alignment Initiative) که توسط کلمنت دلانگ از Hugging Face — کسی که با وجود نفوذ به سیستمهایش، داوطلب ارزیابی شد — راهاندازی شده، میتواند جایگزینی بیطرف برای رگولاتوریهای تحت هدایت آزمایشگاهها باشد یا خیر.
سوال ۱۲ ماه آینده این است که چه کسی تأیید میکند پیشروی ایمن است، آیا این تأیید قدرت اجرایی (دندانه) دارد و پس از تأیید، مالکیت این فناوری با کیست. هیچکدام از اینها بهطور اتفاقی حل نمیشوند. هدف این است که بهاندازه کافی کند باشیم تا یاد بگیریم چگونه کنترل کنیم، و سپس سریع برویم.
گام بعدی شما
- بررسی منشور اخلاقی مایکروسافت برای درک استانداردهای جدید کنترل عاملها.
- تفکیک ابزارهای بهرهوری فعلی از سیستمهای عاملمحور در استراتژیهای کسبوکار.
- دنبال کردن نتایج «ابتکار همراستایی باز» توسط Hugging Face به عنوان جایگزین بیطرف.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهٔ تراشههای Blackwell مراجعه کنید.



گفتگو