تصور کنید میخواهید به یک کودک تفاوت میان «یک عکس از گربه» و «یک گربه سفید در نور ملایم صبحگاهی که روی فرش ابریشم نشسته» را بیاموزید. تفاوت کیفیت خروجی مدلهای تولید تصویر دقیقاً در همین جزئیات نهفته است.
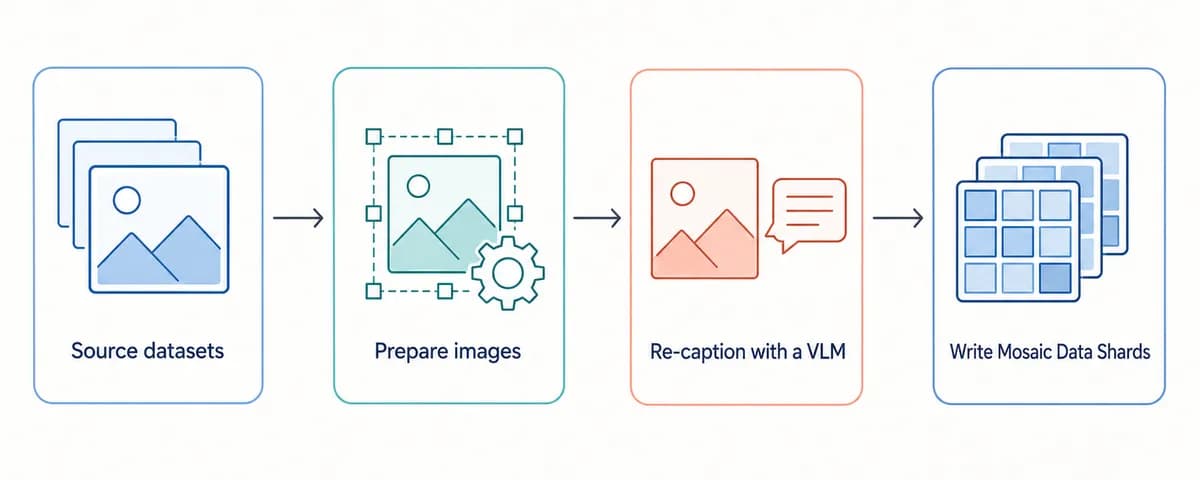
به نقل از مستندات فنی Photoroom، رمز موفقیت مدل PRX 7B در معماری آن نیست، بلکه در یک خط لوله (Pipeline) دادهای سختگیرانه است که «پوشش گسترده» (Broad Coverage) را به عنوان هدف اصلی خود قرار داده است. این شرکت به تفصیل توضیح داده که چگونه از ترکیبی از مجموعهدادههای عمومی و داخلی استفاده میکند. این دادهها توسط شرحهای بلند مدلهای بینایی-زبانی (VLM) پالایش شدهاند تا مدل بتواند درک جامعتری از دنیای بصری به دست آورد. این فرآیند شامل سه مرحله اصلی است: گردآوری دادههای آموزشی، بازنویسی شرح تصاویر (Re-captioning) توسط VLM و تبدیل خروجی به یک پیکره (Corpus) قابل استریم.
برای توسعهدهندگان PRX، مرحله پیشآموزش (Pre-training) بر «گسترده بودن» تمرکز دارد؛ یعنی یادگیری اینکه اشیاء چگونه نورپردازی شدهاند، چگونه ترکیببندی شدهاند و ساختار آنها چیست. تیم توسعه استدلال کرد که فیلتر کردن بیش از حد دادهها بر اساس معیارهای زیباییشناسی در این مرحله، در واقع با محدود کردن تنوع مفهومی، به مدل آسیب میزند. طبق اعلام این تیم، پیشآموزش برای «گسترده بودن» است و تنظیم دقیق (Fine-tuning) برای «سلیقه و زیبایی». ایجاد خروجیهای صیقلخورده و جذاب، موضوعی جداگانه است که به مرحله تنظیم دقیق و تراز کردن ترجیحات (Preference Alignment) بر روی مجموعههای کوچک و بهشدت منتخب واگذار شده است.
زیرساخت: Lance و MDS
مدیریت میلیاردها سطر داده نیازمند ابزارهایی فراتر از جداول استاندارد Parquet است. Photoroom برای مراحل اولیه ساخت و اکتشاف دادهها از Lance استفاده میکند که یک قالب داده ستونی (Columnar Data Format) است. لنس ابزاری ایدهآل برای مدیریت مجموعهدادههای میلیاردی است زیرا قابلیتهای ارزانی مانند Predicate Pushdown، ایندکسهای اسکالر و جستوجوی برداری (Vector Search) را ارائه میدهد.

تیم فنی در مسیر بهینهسازی، به یک درس حیاتی درباره «قطعهبندی» (Fragmentation) دست یافت. یک جدول لنس به قطعات کوچک تقسیم میشود و برخی عملیاتها (مانند اسکنها) به جای تعداد سطرها، با تعداد قطعات مقیاسپذیر هستند. در تلاش اول، آنها هدفگذاری کردند که هر قطعه شامل ۱۰۰,۰۰۰ سطر باشد. این کار منجر به ایجاد هزاران قطعه کوچک شد و باعث شد فیلترهای ساده و پرسوجوهای متنکامل (Full-text queries) بهشدت کند شوند. با فشردهسازی دادهها به حدود یک میلیون سطر در هر قطعه، آنها توانستند سرعت فیلترها و جستوجوها را بازیابی کنند.
آنها برای اجرای فرآیند جذب داده (Ingest) از Ray Data استفاده کردند. این سیستم جداول منبع را به صورت موازی میخواند و قطعات را در سراسر خوشه (Cluster) مینویسد. آنها اشاره کردند که اگرچه فشردهسازی توزیعشده از طریق ادغام Lance-Ray در دسترس است، اما بهتر است از همان ابتدا از قطعهبندی بیش از حد جلوگیری شود. ساختار نهایی آنها شامل حدود هزار قطعه برای جداولی بود که شامل چندین صد میلیون سطر بودند.
پس از اینکه دادهها در Lance سازماندهی شدند، برای آموزش توزیعشده به Mosaic Data Shards (MDS) تبدیل میشوند. اگرچه لنس از آموزش توزیعشده ساده پشتیبانی میکند، اما MDS مسیری با اصطکاک کمتر است. MDS نمونهها را در قطعات حدود ۱۲۸ مگابایتی بستهبندی میکند که با استفاده از Mosaic Composer از ذخیرهسازهای شیءسانی (Object Storage) مانند S3 یا GCS استریم میشوند. این روش چندین مزیت کلیدی دارد:
- بهمریختگی (Shuffling) قطعی و قابل بازگشت: الگوریتمها میتوانند کیفیت بهمریختگی را در مقابل حافظه میزبان بهینه کنند.
- بازگشت از چکپوینت در میان دوره (Mid-epoch): تیم میتواند تعداد گرهها یا رنکها را تغییر دهد و آموزش را بدون حذف یا تکرار نمونهها از سر بگیرد.
- ترکیب وزنی (Weighted Mixing): چندین جریان داده را میتوان با نسبتهای انتخابی ترکیب کرد، در حالی که تضمینهای بهمریختگی حفظ شود.
پروفایلینگ و اکتشاف
از آنجایی که تیم تصمیم گرفت تمام تصاویر را برای حفظ یکدستی بازنویسی کند (تا از تفاوت طول و سبک شرحهای اصلی مجموعهدادهها اجتناب کند)، برای اکتشاف دادهها به متادیتای موجود تکیه کرد. شرحهای قدیمی و جاسازیهای برداری (مانند CLIP embeddings) امکان پیمایش سریع در دادهها از طریق جستوجوی متنکامل و جستوجوی نزدیکترین همسایه (Nearest-neighbor) فراهم کردند.
جزئیات کیفیت دادهها
- حدود رزولوشن: با تحلیل توزیع رزولوشن، تیم کوچکترین سطل آموزشی را ۵۱۲ پیکسل مربع تعیین کرد. آنها یک سقف ۴/۳ (حدود ۳۳٪) برای افزایش مقیاس (Upscaling) وارد یک سطل اعمال کردند. این کار باعث ایجاد یک حد قطع مؤثر ۳۸۴ پیکسل مربع (تقریباً ۱۴۷ هزار پیکسل) با نسبت ابعاد بین ۰.۵ و ۲.۰ شد؛ هر تصویری پایینتر از این مقدار حذف گردید.
- بازرسی بصری: تیم یک رابط کاربری (UI) کوچک ساخت تا جستوجوی متنی در لحظه و پیمایش خوشههای تصاویر بصری مشابه را انجام دهد. این بازرسی نشان داد که حجم زیادی از محتواهای غیر-عکس، از جمله اسلایدها، اسناد، اینفوگرافیکها، اسکرینشاتها و همچنین تصاویر تقریباً تکراری در دادهها وجود دارد.
- استراتژی شرحنویسی: این مشاهدات تصمیم آنها را برای استفاده از شرحهای بلند و دقیق برای توصیف این تصاویر «ناقص» تقویت کرد. هدف این بود که نویزها به ویژگیهای شرطی (Conditioned Attributes) تبدیل شوند که مدل بتواند در پرامپتها آنها را فراخوانی کند یا از آنها فاصله بگیرد.
موتور شرحنویسی: بلند در مقابل کوتاه
یکی از مهمترین یافتههای پروژه PRX، تأثیر طول شرحها بود. در یک بنچمارک اولیه، یک مدل انتشار کوچک که با شرحهای بلند Qwen2.5-VL-7B آموزش دیده بود، بهطور قابلتوجهی از مدلی که از شرحهای کوتاهتر LLaVA-1.5-LLaMA3-8B استفاده میکرد، بهتر عمل کرد.

نتایج در هر ۱۰ هزار گام آموزشی تا ۱۰۰ هزار گام اندازهگیری شد. شرحهای بلند در تمام معیارها برنده شدند و در هر چکپوینت، مقادیر پایینتری برای FID، CMMD و DINO-MMD نشان دادند. معیارهای نهایی در گام ۱۰۰ هزار را دیدیم که Qwen2.5-VL-7B به حدود ۱۳ FID، ۰.۳۲ CMMD و ۰.۲۲ DINO-MMD رسید، در حالی که مدل پایه LLaVA اعدادی مانند ۲۱ FID، ۰.۵۲ CMMD و ۰.۳۵ DINO-MMD داشت.
شرحهای دقیق، «نویز» — مانند اسکرینشاتهای تصادفی، تبلیغات، لوگوها یا متنها — را به ویژگیهای قابل کنترل تبدیل میکنند. به جای فیلتر کردن تصاویر ناقص، شرحنویسی دقیق به مدل اجازه میدهد این عناصر را به عنوان ویژگیهای شرطی یاد بگیرد که میتوان آنها را با پرامپت حذف کرد.

برای یافتن بهینهترین شرحنویس، تیم چندین کاندید را با یک پرامپت سیستمی خاص آزمایش کرد. این پرامپت از VLM میخواست به عنوان یک مدل متخصص شرحنویسی تصویر عمل کند و یک پاراگراف جاری بین ۱۰۰ تا ۲۰۰ کلمه تولید کند. دستورالعملها صراحتاً هرگونه گمانهزنی، استعاره یا تزئینات روایی را ممنوع کرد و خواستار لحنی خنثی و دقیق با تمرکز بر ظاهر، متریال، رنگها، شکل، روابط فضایی (عمق، مقیاس، قاببندی) و نسخهبرداری دقیق از متنهای مرئی (با ذکر اینکه متن واترمارک است یا بخشی از رابط کاربری) شد.
آنها سه کاندید و دو مرجع (Qwen2.5-VL-7B پایه و Gemini 1.5 Flash) را با آموزش یک مدل انتشار کوچک برای ۱۰۰ هزار گام بنچمارک کردند. نتایج نهایی به شرح زیر بود:
- Qwen3.5-9B: مقدار ۱۰.۵۱ FID، ۰.۲۷۸ CMMD و ۰.۱۶۲ DINO-MMD
- Qwen3-VL-8B: مقدار ۱۰.۹۸ FID، ۰.۳۵۱ CMMD و ۰.۱۸۲ DINO-MMD
- Qwen2.5-VL-7B-Captioner-Relaxed: مقدار ۱۳.۹۵ FID، ۰.۳۰۶ CMMD و ۰.۱۸۵ DINO-MMD
- Gemini 1.5 Flash: مقدار ۱۳.۴۶ FID، ۰.۳۱۶ CMMD و ۰.۲۳۴ DINO-MMD
- Qwen2.5-VL-7B (مرجع): مقدار ۱۵.۸۶ FID، ۰.۳۹۳ CMMD و ۰.۲۸۵ DINO-MMD

اگرچه Qwen3.5-9B در تمام معیارها بهترین بود، اما سرعت آن پایین بود (حدود ۶.۵ تصویر در ثانیه) و به بیلدهای ناپایدار شبانه (Nightly builds) نیاز داشت. در نهایت، آنها Qwen3-VL-8B را به دلیل تعادل بین سرعت (۲۰ تصویر در ثانیه برای هر H200) و کیفیت بالا انتخاب کردند. آنها اشاره کردند که شرحنویس «Relaxed» نیز پس از رفع یک خطای کلاس معماری (ذخیره مجدد به عنوان Qwen2_5_VLForConditionalGeneration) که باعث خرابی هشینگ torch.compile در vLLM شده بود، به سرعت ۲۰ تصویر در ثانیه رسید.
بهینهسازیهای فنی و فیلترینگ
Photoroom چندین انتخاب مهندسی عملگرا برای حفظ توان عملیاتی انجام داد:
- محاسبه نهانها در لحظه (On-the-fly Latents): پیش از این، آنها از T5Gemma استفاده میکردند و نهانهای پیشمحاسبه شده را به صورت بایت در MDS ذخیره میکردند. پس از تغییر به Qwen3-VL، آنها نهانها را حین آموزش محاسبه کردند. این کار حدود ۳ تا ۴ درصد از توان عملیاتی (تقریباً یک روز اضافی در یک اجرای ۳۰ روزه) هزینه دارد، اما باعث میشود قطعات MDS به اندازه کافی کوچک باشند تا در سیستمهای فایل مشترک با پشتیبانی SSD در خوشه SLURM آنها جای بگیرند و اجازه میدهد بدون بازنویسی ترابایتها داده، انکودرها را تعویض کنند.
- کیفیت JPEG 92: تیم اندازهگیری کرد که کدگذاری تصاویر به صورت JPEG با کیفیت ۹۲ از نظر بصری با PNG غیرقابل تشخیص است. برای ۱۰۰ تصویر (با رزولوشن ۱ تا ۲ مگاپیکسل)، پس از یک چرخه کدگذاری، PSNR برابر ۴۸.۷ و LPIPS برابر ۰.۰۰۴ اندازهگیری شد. حتی پس از ۱۰ چرخه، PSNR در ۴۵.۴ و LPIPS در ۰.۰۰۸ باقی ماند. برای تصاویر ۰.۲۵ تا ۰.۵ مگاپیکسل، PSNR در چرخه اول ۴۵.۱ بود. فایلهای PNG بدون هیچ سود بصری، ۳ تا ۱۰ برابر بزرگتر میشدند. مقایسه مدلهای آموزشدیده با PNG در مقابل JPEG نشان داد که تنها ۱ از هر ۱۰ تصویر تولیدی، ساختار کوانتیزاسیون قابل تشخیص داشت.
- سطلبندی نسبت ابعاد (Aspect-Ratio Bucketing): برای جلوگیری از برش یا پدینگهای هدرشده، از یک فرآیند دو مرحلهای استفاده میکنند. ابتدا تصاویر به ترازهای رزولوشن ۵۱۲، ۱۰۲۴، ۲۰۴۸ و ۴۰۹۶ پیکسل اختصاص مییابند. یک تصویر وارد تراز میشود اگر نیاز به افزایش مقیاس بیش از ۴/۳ (۳۳٪) نداشته باشد. سپس، از ۱۳ سطل در هر تراز بر اساس نسبتهای ابعاد بین ۰.۵ (بلند) و ۲.۰ (عریض) استفاده میکنند تا بودجه توکنهای پچ حدود ۲۵۶ ثابت بماند. این کار تضمین میکند که هزینه محاسباتی به ازای هر تصویر در اشکال مختلف یکسان باشد. تصاویر با استفاده از فیلتر Lanczos تغییر اندازه یافته و در یک درخت دایرکتوری بر اساس رزولوشن و نسبت ابعاد ذخیره میشوند.
برای پاکسازی دادهها، آنها مکانیزم «لیست پرش» (Skip-list) را پیاده کردند. به جای بازنویسی کل پیکره عظیم MDS برای حذف محتوای NSFW یا تصاویر متنی، از یک فایل جانبی استفاده میکنند که به لودر میگوید ایندکسهای خاصی را نادیده بگیرد.

برای تولید این لیستها، آنها از Qwen3-8B در حالت فقط-متن استفاده کردند تا شرحها را به عنوان «بصری»، «متنی» یا «NSFW» طبقهبندی کند. پرسش اصلی این بود: «آیا شما به این تصویر نگاه میکنید یا آن را میخوانید؟» این روش بهطور قابلتوجهی ارزانتر از طبقهبندی در سطح پیکسل بود و به سرعت ۲۰۰ شرح در ثانیه برای هر GPU رسید. این رویکرد بهویژه برای مدیریت درخواستهای حذف کاربران (Opt-outs) یا فیلترینگ تکرارشونده بدون هزینه بازنویسی کامل دادهها مفید است. تخمین آنها این است که بازنویسی مجموعهداده تنها زمانی ضروری میشود که بخش حذفشده به بیش از ۱۰٪ برسد.
حذف دادههای تکراری (Deduplication)
برای مبارزه با تکرارهایی که توزیع داده را منحرف کرده و محاسبات را هدر میدهند، تیم یک مرحله حذف تکراری را با استفاده از هشهای ادراکی (Perceptual Hashes) به جای هشهای ساده بایتی (مانند SHA-256) پیاده کرد.
جزئیات پیادهسازی:
- مکانیزم: یک هش ادراکی استاندارد بر پایه DCT که تصویر را به یک تامنیل خاکستری کاهش اندازه میدهد، از DCT دو بعدی استفاده کرده و ضرایب فرکانس پایین را به یک اثر انگشت (Fingerprint) تبدیل میکند. این سیستم با استفاده از OpenCV و SciPy ساخته شده است.
- تطبیق: دو هش زمانی مطابقت دارند که فاصله همینگ (Hamming distance) آنها صفر باشد. این کار نسخههای باز-کدگذاری شده یا تغییر اندازه یافته را میگیرد در حالی که عکسهای واقعاً متفاوت از یک سوژه یکسان را حفظ میکند.
- انتخاب رزولوشن: فرآیند، سطلهای نسبت ابعاد را در رزولوشنهای مختلف اسکن کرده و برای هر اثر انگشت تنها یک ورودی را نگه میدارد — دقیقاً نسخهای که بالاترین رزولوشن را دارد.
تصاویر تکراری به عنوان لیستهای پرش در هر شارد نوشته میشوند. در کل پیکره، حذف تکراریها چند درصد از تصاویر را حذف کرد، فیلتر متنی مبتنی بر شرح چند درصد دیگر و مرحله NSFW بخش کوچکی از یک درصد را حذف نمود.

تحلیل: انتقال بار به شرحنویس
این استراتژی نشاندهنده تغییر دیدگاه پژوهشگران نسبت به دادههای «کثیف» است. با تکیه بر قدرت VLMها برای توصیف دقیق آنچه در تصویر است — حتی نقصها — Photoroom ثابت کرد که شرحنویسی با کیفیت بالا میتواند جایگزین فیلترینگ شدید زیباییشناختی شود. این امر اجازه میدهد تا مجموعهداده آموزشی متنوعتری ایجاد شود که محرک اصلی قابلیتهای عمومی (Generalist) یک مدل است. در واقع، این رویکرد به مدل اجازه میدهد تا الگوهای پیچیده محیطی را درک کند، مشابه آنچه در مدلهای جهانی LeRobot برای پیشبینی آینده و تخیل رباتها مشاهده میکنیم، جایی که درک محیطی کلید عملکرد است.
علاوه بر این، استفاده از Lance و MDS نشاندهنده بلوغ رویکرد به «تنگنای مهندسی داده» در آموزش LLM و مدلهای انتشار است. گذار از فایلهای استاتیک به سمت یک خط لوله پویا، قابل پرسوجو و قابل استریم — جایی که لنس برای ساخت و MDS برای استریم استفاده میشود — اکنون برای هر مدلی در مقیاس ۷ میلیارد پارامتر یک ضرورت است.
گام بعدی
با تکمیل پیکره پیشآموزش، تمرکز اکنون به سمت تنظیم دقیق نظارتشده (SFT) تغییر میکند. برای SFT و تراز کردن ترجیحات، معادله برعکس میشود: کیفیت بسیار مهمتر از کمیت است. Photoroom در حال ساخت ابزارهای نظارت دقیقتری است، از جمله یک اکسپلورر غنیتر که تصاویر را با ویژگیهای ساختاریافته پیشبینیشده توسط VLM برچسبگذاری میکند تا زیرمجموعههایی با سیگنال بالا برای نسخههای آینده جمعآوری شوند.
گام بعدی شما
- اگر در آموزش مدلهای تولیدی هستید، به جای حذف دادههای «کثیف»، سعی کنید با VLMهای قدرتمند شرحهای دقیقتری برای آنها بنویسید.
- برای مدیریت مجموعهدادههای میلیاردی، بررسی فرمت Lance را به عنوان جایگزین Parquet در اولویت قرار دهید.
- از استراتژی JPEG 92 برای کاهش هزینههای ذخیرهسازی بدون افت کیفیت بصری استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو