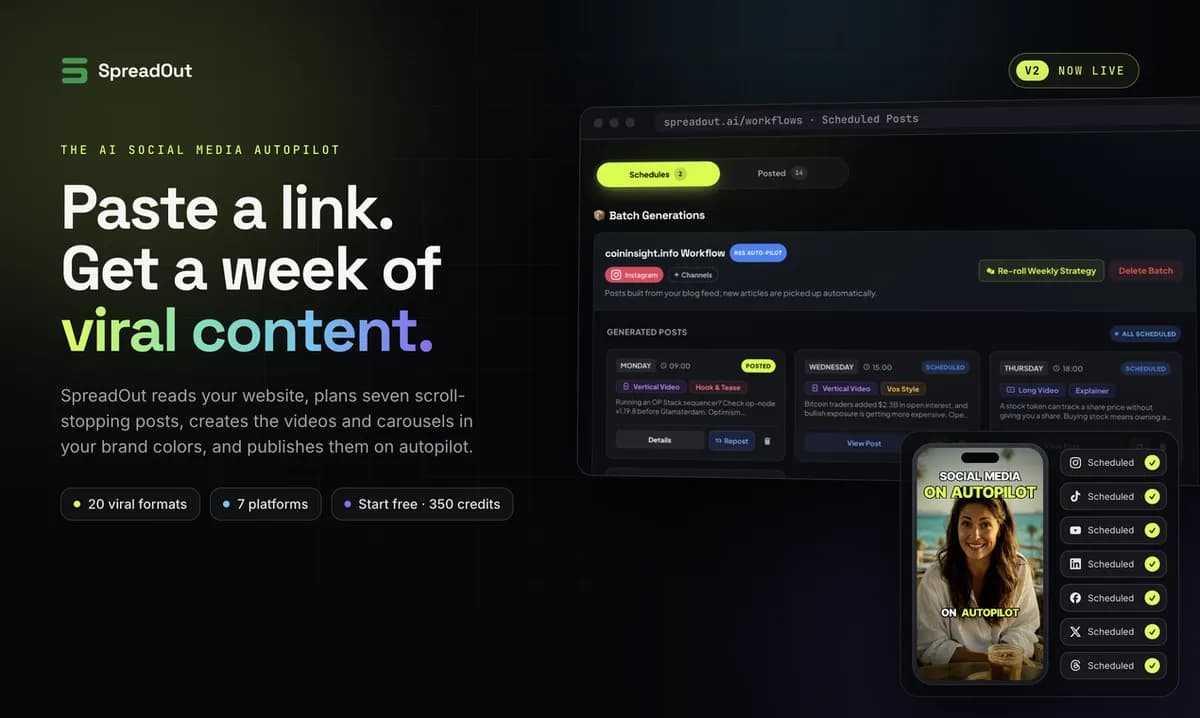
تصور کنید میخواهید یک لینک ساده را به یک هفته محتوای متنوع تبدیل کنید، اما هوش مصنوعی شما هر بار همان جملات تکراری را میگوید. در معماری Spread Out، پلتفرمی که URLها را به ویدیوهای کوتاه، کاروسلها و پادکستها تبدیل میکند، مشخص شد که چالش اصلی یک موتور تولید محتوای صنعتی، نه خودِ تولید و نه یک پرامپت هوشمندانه، بلکه «حافظه» از چیزهایی است که قبلاً ساخته شده است.
بسیاری از ابزارهای تولید محتوا حس «رباتگونه» دارند چون فاقد وضعیت (State) هستند. توسعهدهنده Spread Out دریافت که بدون یک سیستم حافظه اختصاصی، مدل مدام از قلابهای (Hooks) تکراری، جملات آغازین مشابه مثل «آیا میدانستید...» و تصاویر پسزمینه یکسان برای یک برند استفاده میکند و خروجی را مکانیکی میکند.
برای حل این مشکل، تیم یک لایه «مدیر خلاقیت» پیاده کرد. این سیستم از بین ۲۰ فرمت مختلف — مثل ویدیوهای UGC (محتوای تولید شده توسط کاربر) با چهره گوینده، شمارش معکوس، دموهای اپلیکیشن، کلیپهای پادکست و کاروسلها — انتخاب میکند و تاریخچه هر برند را نگه میدارد تا یک زاویه دید در یک هفته تکرار نشود. این رویکرد در واقع تکاملیافتهی ساختارهای خطی برای تبدیل ویدیوهای هوش مصنوعی به محتوای تماشایی است که بر تکرارپذیری و کیفیت متمرکز است. آنها همچنین کلیپهای b-roll، موسیقی پسزمینه و جملات آغازین را برای هر برند ردیابی میکنند. در نهایت، موضوعات را به یک «قلمرو» (Territory) خاص که از وبسایت استخراج شده متصل کردند تا مدل به سمت محتواهای انگیزشی کلی و خستهکننده منحرف نشود.
اصلاح لحن هوش مصنوعی
برای حذف ریتم قابل شناسایی مدل زبانی بزرگ (LLM) — مثل لیستهای سهتایی و طول جملات یکسان — این پلتفرم از یک فرآیند اصلاح دو مرحلهای استفاده میکند:
- ویرایش مخصوص گفتار: یک مرحله ویرایشی مجزا، متن را برای خواندن بازنویسی میکند؛ یعنی کلمات را به شکل محاورهای درمیآورد، طول جملات را نامتقارن میکند و برچسبهایی مثل «فکت ۲:» را که نباید بلند خوانده شوند، حذف میکند.
- تشخیص هوش مصنوعی: یک مدل تشخیصدهنده کوچک روی هر کپشن و اسکریپت اجرا میشود. اگر متن بیش از حد «ماشینی» تشخیص داده شود، برای بازنویسی بازگردانده میشود و به جای انتشار، دوباره به چرخه اصلاح میرود.
علاوه بر این، کارتهای متنی حاوی اعداد و فکتها با دقت میلیثانیهای به کلمات کپشن متصل شدهاند. این یعنی کارتها بر اساس یک ضربآهنگ ثابت ظاهر نمیشوند، بلکه دقیقاً لحظهای که گوینده کلمهای خاص را میگوید، کارت مربوطه ظاهر میشود.
زیرساخت فنی و میزبانی مدلها
طبق گزارش توسعهدهنده، Spread Out برای کنترل هزینهها و مدیریت دقیق انتخاب مدلها، از APIهای پرداختبه-ازای-هر-درخواست فاصله گرفت و به سمت سرورهای GPU شخصی با API Gradio رفت. این استک روی دو مدل اصلی متکی است:
- LTX-2.5: مسئول تولید ویدیو و گفتار بومی است. این مدل نیاز به یک لایه جداگانه تبدیل متن به گفتار (TTS) برای کلیپهای Talking-head را کاملاً حذف میکند.
- Qwen-Image: تصاویر ثابت مورد نیاز در گردش کار را تولید میکند.
همانطور که در تحلیلهای قبلی ما درباره بهینهسازی استنتاج اشاره کردیم، این تغییر باعث ایجاد یک گلوگاه در حافظه ویدیویی (VRAM) — شبیه به میزی کوچک که فقط جای یک کتاب بزرگ دارد و برای خواندن کتاب دوم باید اولی را کنار بگذارید — شد. این چالشهای زیرساختی یادآور هزینههای پنهان تولید ویدیو با AI است که در آن سرعت رندر لزوماً به معنای بهینگی نیست. چون این دو مدل همزمان در VRAM جا نمیشوند، سیستم باید مدل تصویر را به طور صریح تخلیه کند تا مدل ویدیو بارگذاری شود و از خطاهای Out-of-memory جلوگیری شود. تیم این مشکل را با ساخت یک صف پردازش (Job Queue) حل کرد که بر اساس تعداد GPUهای سالم و ظرفیت پیکربندی شده، وظایف را به صورت موازی توزیع میکند. هر سرور ردیابی میکند که در حال حاضر کدام مدل را بارگذاری کرده است تا درخواستها به سروری ارسال شوند که وزنهای مدل مورد نظر از قبل در حافظه آن باشد.
برای جلوگیری از قطع اتصال مرورگر در درخواستهای طولانی (Idle Timeouts)، هر پردازشی که بیش از یک دقیقه زمان ببرد به صورت یک Job پسزمینه اجرا میشود و مرورگر از طریق Server-Sent Events وضعیت آن را دنبال میکند.
گرافیک متحرک و رندرینگ
این پلتفرم بهجای تولید فایلهای ویدیویی خام برای هر المان، از ترکیبات HTML/CSS متحرک شده با GSAP استفاده میکند که فریمبهفریم روی سرورهای GPU رندر میشوند. این روش به طراحان اجازه میدهد در مرورگر تغییرات را سریعاً ببینند و همان اجزا هم در کاروسلها و هم در لایههای روی ویدیو استفاده شوند.
نکته فنی اینجاست که رندرر به فریمهای دلخواه در خط زمانی میپرد (Seek). بنابراین، انیمیشنها باید «توابع خالص زمان» باشند. هر چیزی که وضعیت DOM را بخواند یا شفافیت (Opacity) را خارج از خط زمانی تغییر دهد، در مرورگر درست است اما هنگام رندر لرزش (Flicker) پیدا میکند.
باگ Happy Eyeballs
حتی با استک مدلهای پایدار، زیرساخت همچنان شکننده است. توسعهدهنده از یک قطعی API گزارش داد که در آن بررسیهای سلامت (Health Checks) با تأخیر مواجه شده و استخر پایگاهداده (Database Pool) پر شده بود. علت یک باگ در Node 20.0.0 مربوط به قابلیت autoSelectFamily یا همان «Happy Eyeballs» بود که از نسخه ۲۰ به صورت پیشفرض فعال است. این قابلیت زمانی که یک تلاش برای اتصال با تأخیر مواجه میشد، به یک خطای داخلی (Assertion) برخورد میکرد.
به دلیل استفاده از یک هندلر کلی برای خطاهای پیشبینینشده (uncaughtException)، پردازش زنده میماند اما سوکتها در وضعیت بدی قرار میگرفتند و سیستم بهجای کرش کردن سریع، بهتدریج منجمد میشد. راهکار موقت ریاستارت بود، اما راهکار دائمی اضافه کردن دستور net.setDefaultAutoSelectFamily(false); در ابتدای اجرا یا ارتقای نسخه Node بود.
پیچیدگیهای انتشار
انتشار محتوا در هفت پلتفرم — اینستاگرام، تیکتاک، یوتیوب، لینکدین، فیسبوک، X و تردز — خودش یک محصول جداگانه است. تیم مجبور شد توکنهای منقضیشده، حسابهای قطعشده و محدودیتهای هر پلتفرم (مثل محدودیت طول ویدیو یا نیاز به حساب تأییدشده برای آپلودهای طولانی) را مدیریت کند.
آنها برای حل این موضوع، وضعیت «تولید شده» و «منتشر شده» را به عنوان دو حالت مجزا تعریف کردند. سیستم قبل از پست کردن، دسترسی (Auth) حساب را چک میکند و خطاها را در رابط کاربری نمایش میدهد، بهجای اینکه در سکوت تلاش مجدد کند.
برای کسانی که در حال ساخت ابزارهای محتوای زمانبندیشده هستند، درس این است: زمان بیشتری را برای مدیریت وضعیت و پایداری زیرساخت بودجهبندی کنید تا مهندسی پرامپت. این سطح از سرعت در توسعه و پیادهسازی، مشابه تجربه ساخت اپلیکیشنهای چندنفره با AI در ۴.۵ روز است که نشان میدهد تمرکز بر زیرساخت کلید موفقیت است. در نسخه دوم (V2) پلتفرم Spread Out، قابلیتهایی مثل اتوماسیون RSS-to-social، پاسخهای هوش مصنوعی به کامنتها، تبدیل کلمات کلیدی اینستاگرام به DM و یک سرور MCP برای ادغام با Claude یا Cursor اضافه خواهد شد. همچنین امکان استفاده از کلیدهای شخصی (Bring-your-own keys) برای سرویسهای fal، Replicate و Higgsfield فراهم میشود.
گام بعدی شما
- اگر از مدلهای چندوجهی استفاده میکنید، استراتژی تخلیه و بارگذاری مدلها در VRAM را برای جلوگیری از خطاهای Out-of-Memory بررسی کنید.
- برای تولید محتوای سریالی، یک لایه تاریخچه (History) برای هر کاربر/برند بسازید تا از تکرار الگوهای زبانی مدل جلوگیری کنید.
- در پروژههای Node.js، تنظیمات شبکه و نسخههای رانتایم را با دقت بررسی کنید تا باگهای پنهانی مثل Happy Eyeballs باعث منجمد شدن سیستم نشوند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو