تصور کنید یک برنامهنویس بخواهد هزاران درخواست پشتیبانی را در هر ثانیه دستهبندی کند، اما مجبور باشد منتظر بماند تا یک مدل زبانی بزرگ جملات طولانی تولید کرده و سپس آنها را تحلیل کند. پروژه Jeff این بنبست را میشکند و تصمیمگیریهای هوشمند را به ۲۲ میلیثانیه کاهش میدهد. از طریق پروژه Jeff، توسعهدهندگان اکنون به مجموعهای از مدلهای کوچک و سریع دسترسی دارند که بهگونهای طراحی شدهاند تا مستقیماً در کد قرار گیرند و برای طبقهبندی صفر-شات (zero-shot classification) استفاده شوند. این امر سربار معمول تولید متن یا تجزیه و تحلیل آن را بهطور کامل حذف میکند.
بسیاری از توسعهدهندگان در حال حاضر از مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — استفاده میکنند که ابتدا متنی را تولید کرده و سپس باید توسط کدهای منظم (Regex) یا یک مدل دیگر تحلیل شود. این فرآیند طبق گزارش مستندات پروژه Jeff، نهتنها کند است، بلکه مستعد خطاهای قالببندی است. Jeff با بازگرداندن یک احتمال کالیبره شده برای هر گزینه در یک گذر واحد (single forward pass)، مانند «سیستم ۱» (تفکر سریع و غریزی) عمل میکند؛ یعنی یک طبقهبند است، نه یک برنامهریز. این رویکرد در واقع پیادهسازی عملی راهکار Jevlike برای جایگزینی تولید کلمه با امتیازدهی است که تأخیر را به شدت کاهش میدهد. این مدل برای تصمیمات آنی طراحی شده است، نه برای برنامهریزیهای پیچیده.
معماری مدل
همانطور که در تحلیلهای قبلی ما دربارهی مدلهای زبانی کوچک اشاره کردیم، گرایش صنعت به سمت تخصصگرایی در ابعاد کوچک است. Jeff در واقع یک مدل واحد نیست، بلکه مجموعهای از تنظیم دقیق (Fine-tuning) — شبیه وقتی به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — بر روی معماریهای وزنهای باز (Open Weights) است. نسخههای موجود عبارتاند از:
- Jeff-Qwen3.5-0.8B: سریعترین گزینه که برای انتخاب سریع گزینهها بهینه شده است. این مدل اغلب «نقطه بهینه» برای تصمیمگیریهای سریع محسوب میشود.
- Jeff-Qwen3.5-2B: نسخهای بزرگتر و محتاطتر با نمرات بنچمارک بالاتر، هرچند ممکن است در وظایف پویا بیش از حد ریسکگریز باشد.
- Jeff-Gemma4-E2B: مدلی با ۲ میلیارد پارامتر مؤثر (۴.۶ میلیارد پارامتر ذخیرهشده) که بر پایه معماری Gemma 4 ساخته شده است.
این مدلها از همان فرمت درخواست مدل Jev استفاده میکنند و به کاربران اجازه میدهند موقعیت را توصیف کرده و گزینهها را با کلمات ساده فهرست کنند. چون این مدلها صفر-شات هستند، دستهبندیها نیازی به وجود در دادههای آموزشی ندارند؛ مدل بر اساس توصیفات ارائه شده در لحظه تصمیم میگیرد. این ویژگی آنها را برای مدیریت صفهای پشتیبانی، تشخیص قصد کاربر، برچسبگذاری نظارت بر محتوا، دستورات صوتی یا حتی حرکات بازیهای ویدئویی ایدهآل میکند.
عملکرد و سختافزار
بر اساس مستندات فنی پروژه، تفاوت سرعت در سختافزارهای مختلف در مقایسه با مدلهای مبتنی بر API چشمگیر است. این مدلها بهگونهای طراحی شدهاند که روی ایستگاههای کاری محلی و لپتاپها اجرا شوند.
- NVIDIA RTX PRO 6000: مدل 0.8B بهطور متوسط ۲۲ میلیثانیه، مدل 2B حدود ۲۴ میلیثانیه و Gemma 4 E2B حدود ۲۹ میلیثانیه برای هر تصمیم زمان میبرند.
- Apple M4 Max (MLX): مدل 0.8B حدود ۲۸ میلیثانیه و مدل 2B حدود ۶۰ میلیثانیه زمان میبرند. (لازم به ذکر است که MLX در حال حاضر فقط مدلهای Qwen را اجرا میکند).
- CPU (۳۲ رشته/Thread): تأخیر به شدت افزایش مییابد؛ ۴۶۳ میلیثانیه برای مدل 0.8B، ۷۰۸ میلیثانیه برای مدل 2B و ۱ ثانیه برای Gemma 4 E2B.
برای مقایسه، پروژه اشاره میکند که اجرای مدل Jev در بازی Doom از طریق API بین ۱۱۴ تا ۲۱۲ میلیثانیه برای هر فراخوانی زمان میبرد. در حالی که مدل Jev هزینههای تصمیمگیری را به شدت کاهش داده است، اجرای محلی Jeff اکنون تأخیر شبکه و زمان تولید متن را بهطور کامل حذف میکند.
نتایج بنچمارک
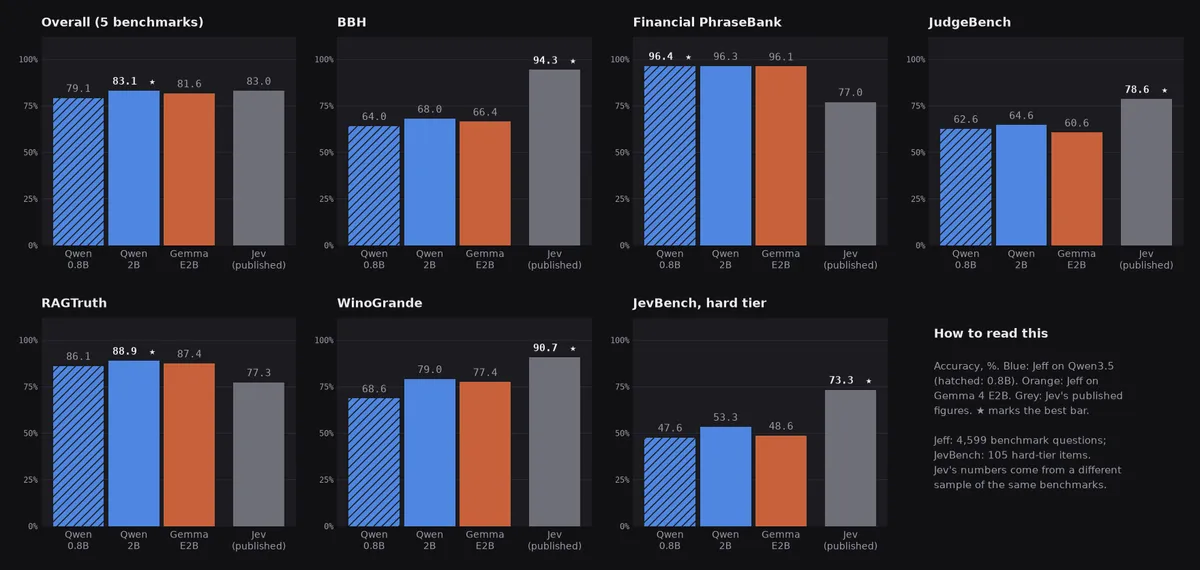
در بررسی صحت (Accuracy) بر روی ۴۵۹۹ پرسش از پنج محک عمومی و سطح سخت JevBench (۱۰۵ مورد)، مدلهای Jeff نتایجی رقابتی در برابر سیستمهای بزرگتر نشان دادند:
- دقت کلی: مدل Jeff-Qwen3.5-2B نمره ۸۳.۱٪ را کسب کرد که تقریباً با ۸۴.۹٪ مدل منتشر شده Jev برابری میکند.
- Financial PhraseBank: مدل کوچک 0.8B با ۹۶.۴٪ صحت، بهطور قابل توجهی مدل بزرگتر Jev (۷۷.۰٪) را شکست داد.
- RAGTruth: مدل Jeff-Qwen3.5-2B نمره ۸۸.۹٪ را گرفت و با مدل عظیم AutoJev-27B (۸۸.۹٪) برابر شد.
- WinoGrande: مدل Jeff-Qwen3.5-2B نمره ۷۹.۰٪ را کسب کرد، در حالی که Jev با ۹۰.۷٪ همچنان برتری دارد.
با این حال، توسعهدهندگان هشدار میدهند که این مدلهای کوچک در وظایف نیازمند استدلال عمیق (Reasoning-heavy) دچار مشکل میشوند. در بنچمارک BBH، مدل 0.8B تنها ۶۴.۰٪ صحت داشت، در حالی که Jev به ۹۴.۳٪ رسید. به همین ترتیب در JudgeBench، مدل 2B نمره ۶۴.۶٪ را در مقابل ۷۸.۶٪ مدل Jev به دست آورد. همانطور که از اندازه مدلها انتظار میرود، قدرت استدلال آنها با مدلهای بسیار بزرگتر قابل مقایسه نیست.
تستهای دنیای واقعی: آزمایشهای بازی
برای سنجش قابلیتهای صفر-شات خارج از بنچمارکهای ایستا، تیم سازنده Jeff را به بازیهای Doom، Frogger و Pac-Man فرستاد. وضعیت بازی و حرکات مجاز بهصورت متنی به مدل داده میشد و مدل باید بهترین اقدام را انتخاب میکرد. گزینهها پیامدهای هر حرکت را توصیف میکردند (مثلاً: «شما توسط یک ماشین زده میشوید») اما هرگز مستقیماً نمیگفتند کدام حرکت درست است.
- Pac-Man: مدل Jeff-Qwen3.5-0.8B توانست ۵۷.۰ pellet جمع کند که بسیار بیشتر از مدل آموزشندیده Qwen3.5-0.8B (۲۵.۸ pellet) بود. مدل آموزشندیده Gemma 4 E2B با ۳.۲ pellet بدترین عملکرد را داشت، هرچند آموزش آن را به ۵۳.۲ رساند.
- Frogger: مدل Jeff-Qwen3.5-0.8B به ۱۰.۳ عبور دست یافت، در حالی که نسخه آموزشندیده تنها ۱.۰ عبور داشت.
- Doom: مدل Jeff-Qwen3.5-0.8B توانست ۶.۵۵e kill ثبت کند که با رباتهای مبتنی بر قوانین (hand-coded rule bot) برابری میکند.
نکته جالب این است که مدل 0.8B اغلب بهتر از نسخه 2B بازی کرد. مدل Jeff-Qwen3.5-2B در بازی Doom (با منفی ۰.۹ kill) و Pac-Man (۴۱.۲ pellet) دچار مشکل شد که توسعهدهندگان آن را ناشی از «ریسکگریزی بیش از حد» میدانند. این نشان میدهد که نمرات بنچمارک همیشه پیشبینیکننده عملکرد در محیطهای پویا مانند بازیها نیستند.
آموزش و شخصیسازی
پروژه Jeff کاملاً روی سختافزار محلی و با استفاده از یک خط لوله دادههای مصنوعی (Synthetic Data Pipeline) ساخته شده است. آموزش روی یک GPU در ایستگاه کاری RTX PRO 6000 انجام شد. مدل 0.8B در حدود ۲ ساعت و مدل 2B در حدود ۳.۵ ساعت آموزش میبینند.
- تولید داده: تمام دادههای آموزشی مصنوعی توسط یک مدل باز (Qwen3.8-Flash-Next) روی دو دستگاه DGX Sparks نوشته شدهاند. هیچ GPU ابری یا خروجی از مدلهای بسته در دادههای آموزشی استفاده نشده است؛ مدلهای بسته تنها برای بررسی تصادفی (spot-check) نمونهای از دادههای مصنوعی به کار رفتند.
- دستورالعمل (Recipe): فرآیند شامل تنظیم دقیق تمام وزنها (full-weight fine-tuning) برای یک epoch با دستههای (batches) ۲۵۶ نفره بود. از تابع cross-entropy روی حروف گزینهها استفاده شد و سپس یک دمای (temperature) متناسب برای کالیبراسیون تنظیم گردید.
- اعتبارسنجی: نقاط بازرسی (Checkpoints) بر اساس یک مجموعه توسعه (development set) انتخاب شدند و هرگز روی پنل بنچمارک آزمایش نشدند. حداقل نیمی از هر خانواده آموزشی، قراردادهای چیدمان پنل را بدون آموزش روی موارد واقعی پنل دنبال کردند.
برای کاربرانی که دقت صفر-شات برایشان کافی نیست، پروژه از تنظیم دقیق سریع پشتیبانی میکند. در یک تست ناوبری صوتی با حدود ۱۱,۰۰۰ نمونه خاصِ اپلیکیشن، یک تنظیم سریع در کمتر از ۳۰ دقیقه روی یک GPU، دقت مدل را از ۳۱.۷٪ به ۹۵.۸٪ رساند. این منجر به سرعت تصمیمگیری حدود ۴۰ میلیثانیه در هر تصمیم روی M4 Max شد.
راهنمای پیادهسازی
توسعهدهندگان میتوانند Jeff را از طریق مدیریت بسته uv مستقر کنند. این سامانه از سه نوع پرسش پشتیبانی میکند:
- انتخاب (Choice): انتخاب یکی از حداکثر ۲۵۵ گزینه.
- Noul: یک احتمال بله/خیر.
- امتیاز (Score): یک نقطه روی یک مقیاس توصیف شده.
برای به حداکثر رساندن عملکرد، نویسندگان موارد زیر را پیشنهاد میکنند:
- عبارتبندی یکسان: در بازی Frogger، یکسان کردن عبارتبندی گزینه هدف با سایر گزینههای رو به جلو، تعداد عبورها را در یک اپیزود از ۱۵ به ۲۳ افزایش داد.
- کلیدهای کوتاه: به جای شناسههای (ID) طولانی که تأخیر را بدون افزودن ارزش افزایش میدهند، از کلیدهای کوتاه مثل
{"1": "Engagement letter"}استفاده کنید. - دستهبندی (Batching): پرسشهای مستقل را در یک درخواست واحد بپرسید تا بهطور همزمان پاسخ داده شوند.
- پرهیز از پیشبینی: Jeff نمیتواند وضعیتهای آینده را پیشبینی کند (مثلاً: «یک ماشین در ۲ نوبت آینده میرسد»)؛ او فقط بین گزینههای فعلی بر اساس پیامدهای توصیف شده تصمیم میگیرد.
تاریخچه پروژه و مجوزها
پروژه Jeff در ابتدا به عنوان یک فورک (Fork) از AutoJev توسط Denis Yarats (تحت مجوز MIT) آغاز شد؛ AutoJev یک دستورالعمل باز برای تنظیم دقیق Qwen3.8-27B بود. پروژه Jeff طراحی اصلی را حفظ کرد — یک گذر واحد برای هر تصمیم، یک readout پاسخ آموزشدیده و دمای تنظیم شده — اما آن را به مدلهای کوچکتر (دانشآموزان 0.8B، 2B و Gemma 4 E2B) منتقل کرد. این رویکرد در راستای پیادهسازی تصمیمات محدود در اکوسیستم Jev است که بر بهینهسازی عملیاتی تمرکز دارد.
این یک پروژه مستقل است و هیچ وابستگی یا تأییدی از سوی TypeSafe (سازندگان Jev) ندارد. پروژه تحت مجوزهای زیر منتشر شده است:
- کد: MIT (شامل کدهای AutoJev).
- وزنهای مدل: Apache 2.0.
- Doom Harness: اقتباس شده از jev-plays-doom (MIT).
این تغییر جهت به سمت مدلهای محلی «سیستم ۱» نشاندهنده آیندهای است که در آن LLMهای بزرگ برنامهریزیهای پیچیده (سیستم ۲) را مدیریت میکنند، در حالی که مدلهای کوچک و تخصصی مانند Jeff، اجرای با فرکانس بالا و مسیریابی (routing) را بر عهده میگیرند. اگر در حال ساخت یک عامل (Agent) محلی هستید، بررسی کنید که آیا یک طبقهبند 0.8B میتواند جایگزین منطق فعلی «پرامپت و تحلیل» شما شود تا تأخیر سیستم کاهش یابد.
گام بعدی شما
- اگر از منطق «پرامپت و تحلیل متن» برای طبقهبندی استفاده میکنید، مدل 0.8B را جایگزین کنید تا تأخیر سیستم را تا ۹۰٪ کاهش دهید.
- برای افزایش دقت، از عبارتبندیهای یکسان برای گزینههای مشابه در پرامپتها استفاده کنید.
- در صورت نیاز به دقت بالا در حوزههای تخصصی، از دادههای مصنوعی برای یک تنظیم سریع (Fine-tune) ۳۰ دقیقهای استفاده کنید.
اما این مدلها تنها بخشی از یک استراتژی بزرگتر هستند؛ برای درک اینکه چگونه مدلهای استدلالی پیچیده با این طبقهبندهای سریع ترکیب میشوند، تحلیل ما درباره معماری سیستمهای دوگانه را بخوانید.



گفتگو