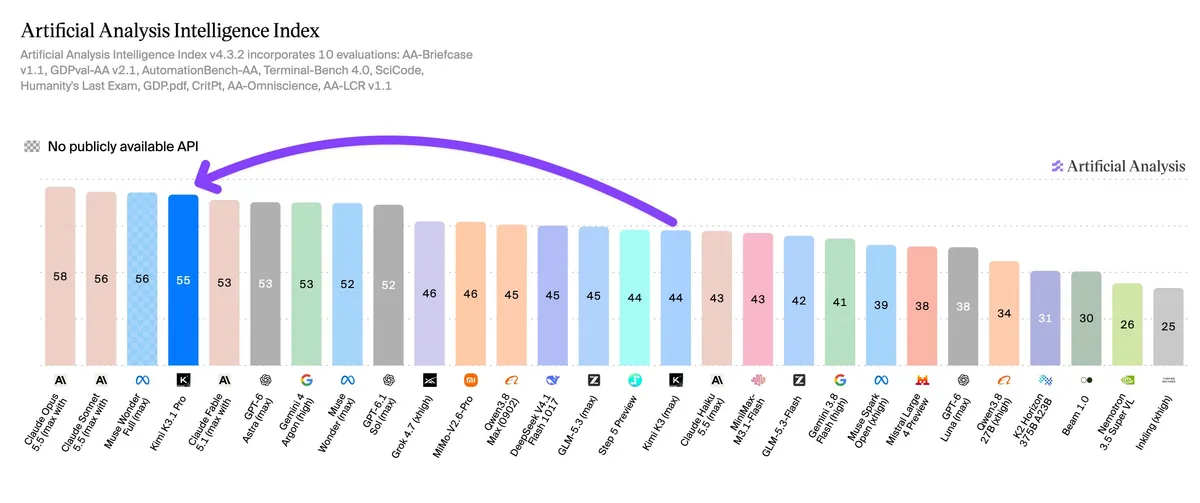
یک مدل چینی اکنون در آستانهی مدلهای مالکیتی برتر ایستاده است — Kimi K3.1 Pro با ۵۵ امتیاز در مؤشر هوش مصنوعی (Artificial Analysis Intelligence Index) رتبه چهارم جهان را گرفت. این نمره ۱۱ واحد بالاتر از نسل قبل است و فاصله با Claude Opus 5.5 را به تنها سه امتیاز میرساند.
همانطور که در تحلیل قبلی ما دربارهی تولید ۱۸۰ میلیون خط کد اثبات رسمی توسط Claude اشاره کردیم، بنچمارکهای استدلالی حالا میدان رقابت باز و مالکیتی شدهاند. Moonshot AI (Moonshot AI) برنامهریزی کرده تا وزنهای باز (Open Weights) مدل را در ۴ نوامبر منتشر کند — اگر محقق شود، K3.1 Pro پرامدترین مدل وزنباز تاریخ میشود و شکاف ۱۲ امتیازی با مدلهای مالکیتی به سه امتیاز میریزد. برای خریداران سازمانی، این نشانهی بلوغ جایگزینهای باز برای بارهای کاری تولیدی است که تا دیروز فقط با APIهای مالکیتی امکانپذیر بود.
مؤشر Artificial Analysis عملکرد را در استدلال، کدنویسی، وظایف عاملمحور (Agentic) و دانش سنجیده میکند. Kimi K3.1 Pro با ۵۵ امتیاز، ۲۵ درصد پیشرفت در برابر ۴۵ امتیاز مدل پایه K3 ثبت کرده. تنها سه مدل بالاترند: Claude Opus 5.5 با ۵۸، Claude Sonnet 5.5 با ۵۶ و Muse Wonder Full با ۵۶ امتیاز.
پیشرفت در وظایف عاملمحور موتور اصلی است
بهبودهای قویترین در بنچمارکهای عاملمحور (Agentic) دیده شده. در GDPval-AA مدل به ۱۸۴۶ إلوی (Elo) رسیده — فقط ۲۰ واحد از Opus 5.5 (۱۸۶۶) و ۱۱ واحد از Muse Wonder Full (۱۸۵۷) عقبمانده. مدل پایه K3 تنها ۱۵۳۴ إلوی داشت. در Terminal-Bench 4.0 نرخ موفقیت ۶۵.۷ درصد گزارش شده، در حالی که Opus 5.5 در ۶۶.۴ درصد و GPT-6 Astra در ۵۸.۲ درصد قرار دارد؛ K3 قبلاً فقط ۱۳ درصد را عبور میکرد.
نرخ توهم (Hallucination) در تست داخلی Kimi Hallu Bench Hard به شدت افت کرده. توهمهای سطح ادعا از ۲۳.۴ درصد در K3 به ۸.۳ درصد کاهش یافته. GPT-6 Astra همچنان با ۵.۵ درصد پیشی دارد، هرچند Moonshot تست خود را یک ارزیابی استرس (Stress Evaluation) مینامد، نه معیار عمومی خطا.
قابلیتهای کدنویسی و مدلسازی سهبعدی
در SWE Marathon v1.1 امتیاز ۵۱.۷ درصد در برابر ۴۶.۳ درصد Opus 5.5. در DeepSWE v1.1 ۷۵.۵ درصد در برابر ۷۴.۲ درصد. مدل مستقیماً با Unity، Unreal Engine و Godot کار میکند — از رفع باگهای سریع تا ساخت پروژه کامل. در BenchCAD با ابزارها ۹۲.۷ درصد (Opus 96.2، GPT-6 Astra 95.9). بدون ابزار ۷۲.۸ درصد، تقریباً همسطح Opus 73.0.
Moonshot اعلام کرده مدل در مدلسازی پارامتریک قطعات مکانیکی، معماری و محصولات قابل پیکربندی برتری دارد. میتواند اسکریپت برای Blender و نرمافزارهای CAD بنویسد و اجرا کند بدون نیاز به اتصال MCP (Model Context Protocol). ویژگی «3D Make» در Kimi.com برای پیشنمایش، ویرایش و خروجی مدلهای سهبعدی راهاندازی شده.
قیمتگذاری و کارایی
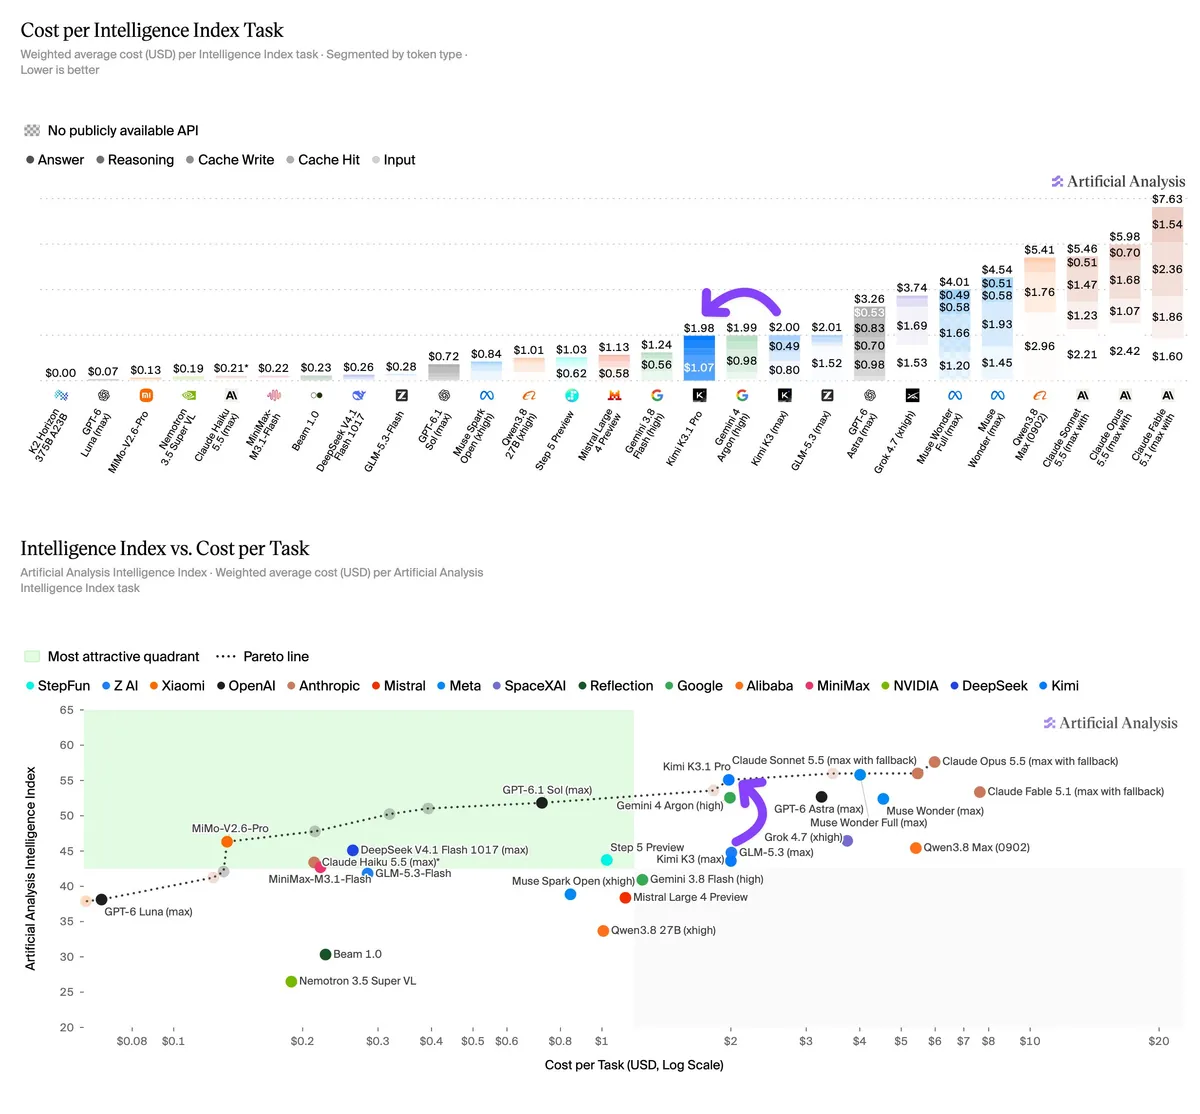
معماری K3.1 Pro همان K3 باقی مانده: ۲.۸ تریلیون پارامتر کل، ۱۰۴ میلیارد پارامتر فعال (Mixture-of-Experts) و پنجره متنی (Context Window) یک میلیون توکنی که هم متن و هم تصویر میپذیرد. قیمت ورودی از ۳ دلار به ۲ دلار در میلیون توکن، خروجی از ۱۵ به ۱۰ دلار و هیت کش (Cache Hit) از ۰.۳۰ به ۰.۲۰ دلار کاهش یافته — ۳۳ درصد ارزانتر در همه موارد. هر وظیفه مؤشر هوش ۱.۹۸ دلار هزینه دارد، تقریباً همسطح ۲.۰۰ دلار K3، چون مدل ۱۴ درصد توکن خروجی بیشتر تولید میکند. Artificial Analysis آن را در کمرهٔ پارِتو (Pareto Frontier) برای کلاس پارامتری خود قرار میدهد.
نسخه Highspeed دو تا سه برابر سرعت استنتاج (Inference) با قابلیتهای یکسان، قیمت ۴ دلار ورودی و ۲۰ دلار خروجی در میلیون توکن. هر دو مدل از طریق Kimi.ai، Kimi Work، Kimi Code و Kimi API در دسترساند.
امنیت سایبری و انتشار مسئولانه
Moonshot یک بخش فنی کامل به امنیت سایبری اختصاص داده. شرکت مشاهده کرده که قابلیت تحقیق آسیبپذیری با مقیاس پسآموزش (Post-training) رشد کرده، چون محتوای سایبری در کالپوس میانآموزش (Mid-training) و محیط RL وجود داشته. برای انتشار وزنباز، دادههای مرتبط با سایبری از هر دو فاز حذف شده. در بنچمارک داخلی xdev-bench-hard که آسیبپذیریهای اخیر کرنل لینوکس، Node.js و JavaScriptCore را بازتولید میکند، نسخه بدون پاکسازی ۹۰.۵ درصد وظایف را حل میکند. پس از پاکسازی K3.1 Pro ۸۱.۰ درصد. DeepSeek-V4.1-Flash در همان تست ۸۵.۷ درصد.
Moonshot استدلال میکند هیچ مدل وزنبازی نباید مرز پیشینِ قابلیتهای تهاجمی سایبری را به جلو ببرد، در حالی که مدلهای باز اهداف دفاعی نظیر حسابرسی سیستمهای قدیمی هم دارند. Anthropic پیشتر نشان داد حتی GLM-5.3 با ۴۵ امتیاز مؤشر AA میتواند اکسپلویت (Exploit) بنویسد در سطح نزدیک Claude Mythos.
مسیر بنچمارک نشان میدهد مدلهای وزنباز سریعتر از پیشبینیها به عملکرد مالکیتی هممحور میشوند. اگر انتشار ۴ نوامبر محقق شود، توسعهدهندگان مدلی ۵۵ امتیازی با کسری از هزینه APIهای مالکیتی خواهند داشت. این محاسبه ساخت-در-مقابل-خرید را برای گردشهای کاری عاملمحور، دستیارهای کدنویسی و خط لوله محتوای سهبعدی تغییر میدهد.
فشار قیمتگذاری بر آزمایشگاههای پیشرو تشدید میشود. کاهش ۳۳ درصدی قیمت در همان تعداد پارامتر، همراه با کارایی بهینه پارِتو، رقبا را وادار میکند لایههای پرمیوم را بر پایه قابلیتها نه دسترسی خام توجیه کنند. رویکرد پاکسازی امنیت سایبری نیز سابقهای میسازد: حفظ قابلیت با کاهش هدفمند ریسک ممکن است استاندارد انتشارهای باز شود.
گام بعدی شما
- انتشار وزنهای ۴ نوامبر را رصد کنید و بنچمارکهای مستقل عاملمحور را با نسخهی باز مقایسه کنید.
- برای پروژههای کدنویسی و سهبعدی، تست A/B بین K3.1 Pro و APIهای مالکیتی را در مقیاس کوچک آغاز کنید.
- رویکرد Moonshot در پاکسازی دادههای سایبری را به عنوان الگو برای ارزیابی ریسک مدلهای باز دیگر بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.

گفتگو