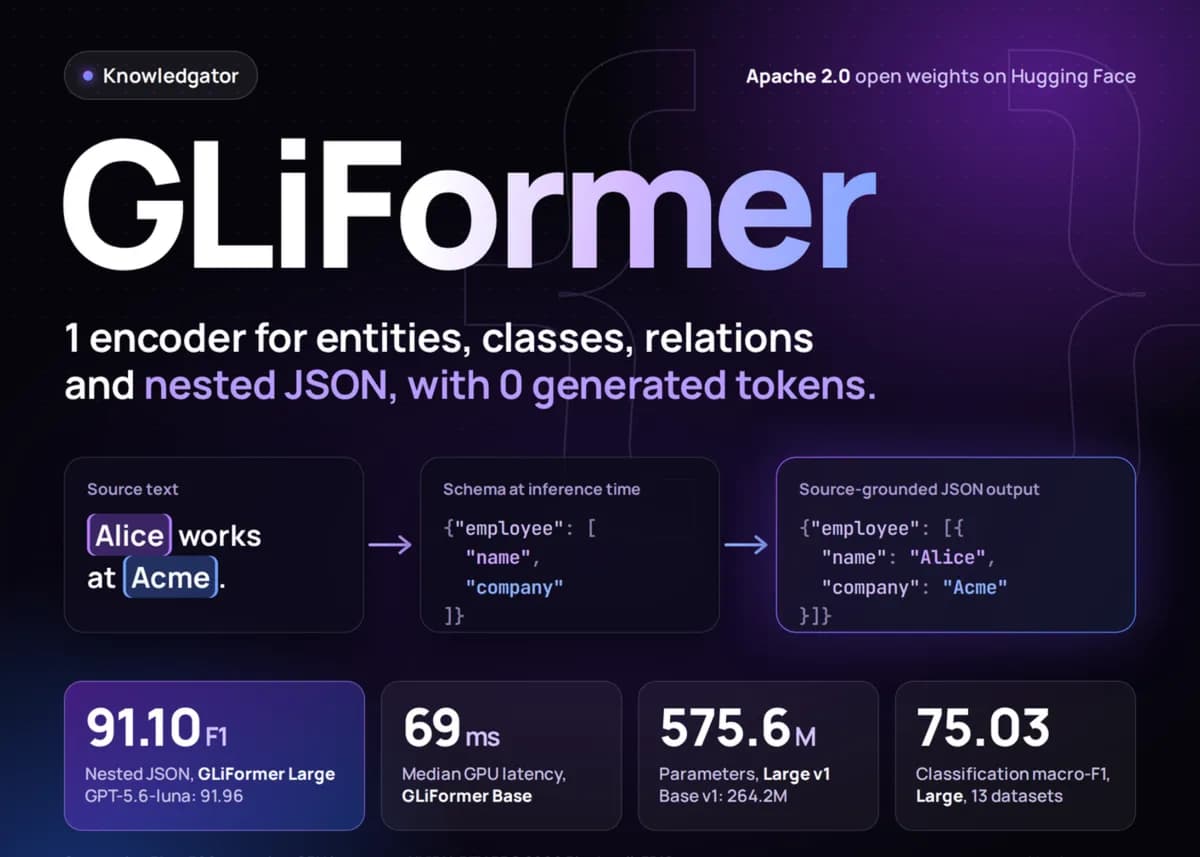
امتیاز ۹۱.۱۰ در معیار F1، استاندارد جدیدی برای استخراج JSONهای تو در تو است که توسط یک رمزگذار با ۵۷۵ میلیون پارامتر ثبت شد. این مدل بدون تولید حتی یک توکن خروجی، به دقت ساختاری مدلهای زبانی عظیم دست یافته است.
این دستاورد مدیون GLiFormer است؛ چارچوب جدیدی از شرکت Knowledgator Engineering که طبق مستندات این شرکت، طبقهبندی، بازشناسی موجودیتهای نامدار (NER) و استخراج JSONهای تو در تو را بهجای یک وظیفه مولد، به عنوان یک عملیات امتیازدهی سازگاری در نظر میگیرد.
بیشتر خطلولههای استخراج فعلی بر زنجیرهای از مدلهای مجزا تکیه دارند؛ یکی برای برچسبگذاری موجودیتها، دیگری برای طبقهبندی سند و سومی برای بازسازی رکوردها. جایگزین دیگر، استفاده از مدلهای زبانی بزرگ (LLM) برای تولید JSON است. اگرچه LLMها توانمند هستند، اما بهدلیل نیاز به تولید تکتک براکتها، کوتیشنها و نام فیلدها بهصورت توکن به توکن، از نظر محاسباتی گران هستند. GLiFormer با یک بار رمزگذاری متن منبع و امتیازدهی آن در برابر طرحوارههای (Schemas) درخواستی، این گلوگاه را حذف میکند.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی استنتاج در مدلهای کوچک اشاره کردیم، حذف لایههای تولیدی میتواند تأخیر را بهشدت کاهش دهد. به گزارش وبسایت marktechpost.com، این چارچوب در دو نسخه عرضه شده است: GLiFormer Base v1 با ۲۶۴.۲ میلیون پارامتر و GLiFormer Large v1 با ۵۷۵.۶ میلیون پارامتر. هر دو مدل تحت مجوز Apache 2.0 منتشر شدهاند و از طریق دستور pip install gliformer قابل استقرار روی CPU یا GPU هستند.
معماری فنی
مدل GLiFormer تطبیق برچسبها را از طریق یک سیستم «لنگر» (Anchor) تعمیم میدهد. لنگر در واقع شیئی است که برچسبهای زمان اجرا در برابر آن امتیازدهی میشوند؛ مثلاً یک بردار گروه برای طبقهبندی یا یک جایگاه رکورد برای ساختاربندی.
در بخش NER، مدل برای هر جفت توکن و برچسب، شواهدی برای شروع، پایان و داخل موجودیت امتیازدهی میکند. خروجیهای سیگموئید مستقل اجازه میدهند تا اشارههای تو در تو و مرزهای مشترک بهطور همزمان وجود داشته باشند. این مدل از نوع gliformer-layout با پنج سر (Head) شامل NER، طبقهبندی، روابط مشترک، ساختاربندی چندسطحی و بردار معنایی (Embedding) استفاده میکند. هر سر با حداکثر عرض بازه ۱۲ کلمه و ۱۰۰ لنگر رکورد پیکربندی شده است.
برای استخراج JSONهای تو در تو، مدل در چهار مرحله مجزا عمل میکند:
- مبنیسازی (Grounding): مقادیر فیلدها مستقیماً از بازههای متن منبع گرفته میشوند تا از اختراع دادههای نبوده در ورودی (توهم) جلوگیری شود.
- تخصیص (Assignment): بازهها با استفاده از تطبیق مجارستانی (Hungarian matching) به جایگاههای رکورد تخصیص مییابند.
- سلسلهمراتب (Hierarchy): مدل پیوندهای والد-فرزندی جهتدار را بر اساس طرحواره ارائهشده پیشبینی میکند.
- تجميع (Assembly): یک رمزگشای قطعی، JSON نهایی را سرهم میکند.
مشخصات مدل و آموزش
دو نسخه مدل از نظر مقیاس تفاوت چشمگیری دارند. نسخه Base دارای ۱۲ لایه رمزگذار و بُعد بردار معنایی ۷۶۸ با حداکثر طول ۱۶,۳۸۴ است. نسخه Large به ۲۴ لایه رمزگذار، بُعد ۱۰۲۴ و حداکثر طول ۸,۱۹۲ ارتقا یافته است.
مدل GLiFormer-base از یک بدنه DeBERTa شروع شده و روی ۱۰۰ میلیارد توکن پیشآموزش (Pretraining) دیده است. فرآیند آموزش شامل ۱,۳۵۷,۶۷۱ نمونه برای آموزش چندوظیفهای گسترده و ۳۷۲,۰۹۰ نمونه برای پسآموزش متمرکز بر وظیفه بوده است.
محکهای عملکرد
در آزمونهای JSON تو در تو با ۵۰۰ نمونه، GLiFormer Large به امتیاز ۹۱.۱۰ F1 رسید که تقریباً با نمره ۹۱.۹۶ مدل GPT-5.6-luna برابری میکند. مدل Base با ۸۷.۲۰ F1 در رتبه بعدی قرار گرفت. این معیار بهجای تطابق دقیق JSON، نسبت به مرزها منعطف و بدون وابستگی به ترتیب است.
در وظایف طبقهبندی در ۱۳ مجموعه داده، مدل Large به میانگین macro-F1 ۷۵.۰۳ رسید و از GLiNER2.5 (۶۴.۸۹) پیشی گرفت، هرچند GPT-5-mini با ۷۹.۷۹ پیشتاز بود. در آزمون CrossNER، مدل Base میانگین ۶۵.۱۰ F1 را ثبت کرد. همچنین گزارش شده است که مدل Large در مجموع NER و طبقهبندی، مدل Gemma-4-E4B را شکست داده، در حالی که تقریباً ۱۴ برابر پارامتر کمتری دارد.
در استخراج روابط در ۴ محک مختلف، مدل همچنان عقبتر است و GLiNER-Relex با ۲۵.۶ micro-F1 در برابر ۲۱.۳۳ مدل Large و ۱۸.۹۴ مدل Base پیشتاز است.
تأخیر و بهرهوری
سرعت، مزیت اصلی این رویکرد غیرمولد است. بر اساس دادههای فنی، در یک GPU مدل NVIDIA RTX PRO 6000 Blackwell با دقت FP16، مدل Base برای ۴۰ سند ساختاری با اندازه دسته ۱، میانگین تأخیر ۶۹ میلیثانیه را نشان داد. در یک CPU مدل AMD EPYC 9B45 هشترشتهای با دقت FP32، این تأخیر ۵۴۷ میلیثانیه بود.
تحلیلهای Knowledgator حاکی از آن است که این مدل میتواند تا ۹۵.۸ برابر سریعتر از LLMهای مولد باشد. این تخمین با فرض پیشپُرکردن (Prefill) ۲۰۰۰ توکن در ثانیه و تولید ۶۰ توکن در ثانیه محاسبه شده و تأخیرهای شبکه و صف را شامل نمیشود.
این چرخش در معماری، این فرض را به چالش میکشد که ساختاربندی پیچیده لزوماً به قابلیتهای مولد نیاز دارد. GLiFormer ثابت کرد که با تبدیل استخراج به مسئلهای از «انتخاب بازه و پیونددهی»، میتوان به خروجی JSON با دقت بالا و با کسری از پارامترها و تأخیر یک LLM دست یافت.
توسعهدهندگان اکنون میتوانند با استفاده از طرحوارههای Pydantic برای رکوردهای چندسطحی یا فراخوانی متد model.structure برای نگاشت ساده موجودیت به رکورد، این مدل را پیادهسازی کنند. برای روابط، کاربران باید از joint_relations استفاده کنند زیرا نقاط بازرسی (Checkpoints) نسخه ۱ فاقد سر روابط باز هستند. وزنهای مدل در حال حاضر در Hugging Face برای میزبانی شخصی روی CPU یا GPU در دسترس است.
گام بعدی شما
- اگر در حال استقرار سیستمهای استخراج داده هستید، مدل GLiFormer را جایگزین زنجیرههای پیچیده LLM کنید تا هزینه استنتاج را کاهش دهید.
- برای رکوردهای تو در تو، از طرحوارههای Pydantic برای تعریف دقیق ساختار خروجی استفاده کنید.
- عملکرد مدل را در محیطهای CPU-only تست کنید تا میزان کاهش وابستگی به GPUهای گرانقیمت را بسنجید.
اما تأثیر این رویکرد بر کاهش هزینههای عملیاتی در مقیاس صنعتی حتی چشمگیرتر است — به تحلیل ما دربارهی بهینهسازیهای لایه استنتاج مراجعه کنید.



گفتگو