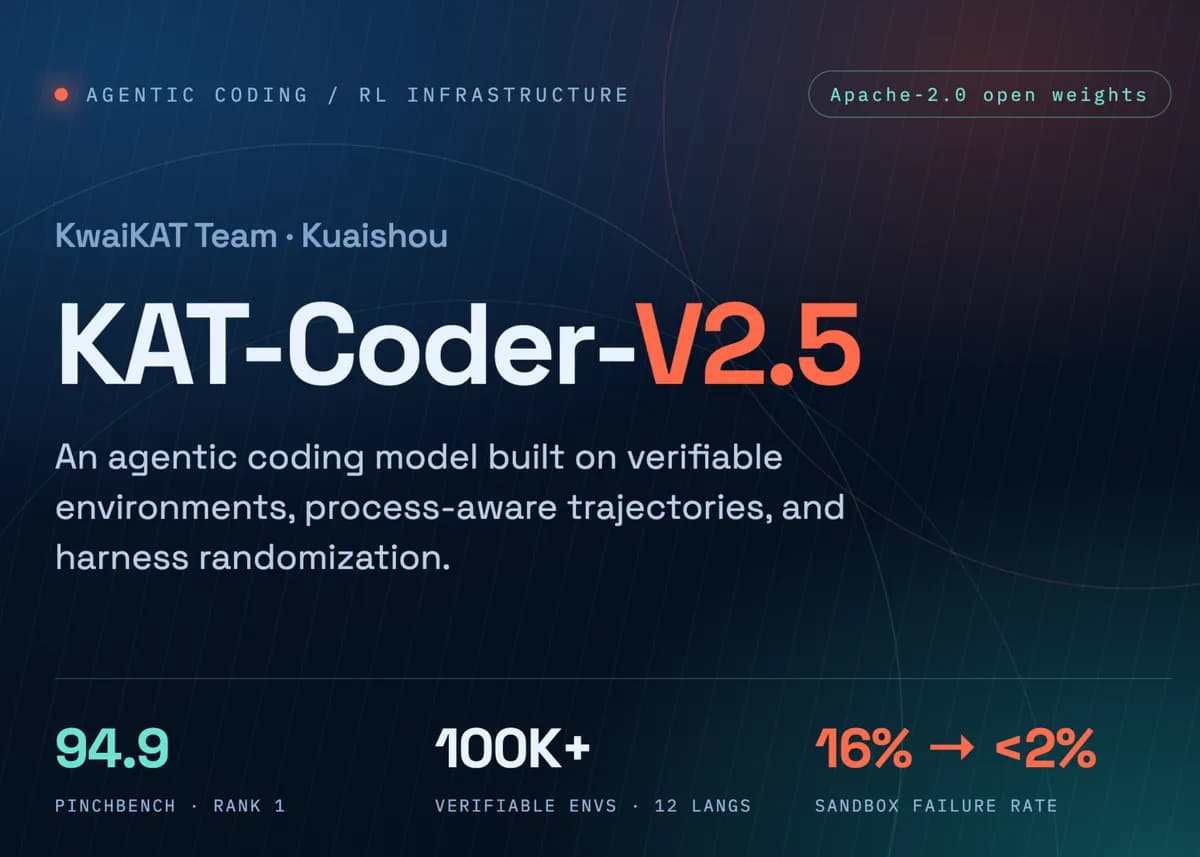
اگر فکر میکنید مدلهای کدنویسی فعلی فقط با خواندن میلیاردها خط کد یاد میگیرند، باید بدانید که بازی در حال تغییر است و اکنون نبرد اصلی بر سر «تأییدپذیری» در محیط واقعی است. در دنیای جدید، خروجی مدل دیگر یک تکه کد زیبا نیست، بلکه راهکاری است که باید در یک محیط ایزوله اجرا شود و تمام تستها را پاس کند.
تیم KwaiKAT در شرکت Kuaishou به جای تمرکز صرف بر مقیاسبندی دادهها، چالش کدنویسی را یک مسئله زیرساختی دید و مدل KAT-Coder-V2.5 را توسعه داد. این مدل از تولید تکههای کد تکمرحلهای فراتر رفته و بهطور کامل درون مخازن (Repositories) اجرایی واقعی عمل میکند. این رویکرد در واقع گامی است به سوی تحقق چشماندازی که در آن عاملهای کدنویسی هوش مصنوعی بهطور مستقیم کدهای عملیاتی را در محیط تولید ارسال میکنند و نیاز به نظارت دستی را کاهش میدهند. طبق اعلام این تیم، مدل نهایی از طریق StreamLake در دسترس است.
بسیاری از مدلهای فعلی دچار توهم (Hallucination) میشوند؛ یعنی کدی مینویسند که در ظاهر درست است اما هنگام اجرا شکست میخورد. تیم KwaiKAT برای حل این مشکل، هر تکلیف آموزشی را به صورت یک «سهگانه» تعریف کرده است: یک توصیف دقیق از مسئله، یک محیط اجرایی و مجموعهای از تستهای اعتبارسنجی. بر اساس تحلیل فنی وبسایت marktechpost.com، یک اصلاحیه تنها زمانی درست تلقی میشود که تکتک این تستها در یک محیط Sandbox (سندباکس) زنده پاس کند.
تثبیت زمینه و ساخت دادهها
برای ساخت این مجموعه داده، تکالیف از Pull Requestها و Commitهای واقعی استخراج شدهاند که از lineage یا نسل SWE-bench پیروی میکنند. تیم توسعهدهنده در این فرآیند از تغییرات کد ادغامشده (Merged code change) به عنوان «اصلاحیه طلایی» (Golden patch) و از تغییرات تستهای همراه آن به عنوان «اصلاحیه تست» (Test patch) استفاده میکند.
برای جلوگیری از نویز، متنهای خام مربوط به Issueها به عنوان مشخصات فنی دور ریخته شدهاند. در عوض، توصیفات مسئله در سه بخش مشخص بازسازی میشوند:
- بیان مسئله که بر اساس «اصلاحیه طلایی» استوار است.
- الزامات فنی که از «اصلاحیه تست» استخراج شدهاند.
- محدودیتهای رابط کاربری (Interface constraints) که از هر دو منبع استنباط میشوند.
در نهایت، یک بررسی شفافیت (Clarity check) انجام میشود و هر توصیفی که مبهم، ناقص، دارای مشخصات ناکافی یا دارای تناقضات داخلی باشد، حذف میگردد. همچنین برای اینکه عاملها (Agents) نتوانند پاسخ نهایی را صرفاً با خواندن راهکار مرجع از داخل مخزن پیدا کنند، تمامی تاریخچه گیت (Git history)، متادیتای کامیتها و سایر ردپاهای قابل بهرهبرداری بهطور کامل پاک شدهاند.
جزئیات AutoBuilder و محیطهای اجرایی
برای مقیاسبندی این فرآیند، سیستمی به نام AutoBuilder طراحی شد که ساخت محیطها را خودکار میکند. این سیستم از دو عامل اصلی بهره میبرد:
- عامل ساخت (Build Agent): مخزن را تحلیل کرده و یک اسکریپت پیکربندی مینویسد که پیشنیازها را نصب کرده و تستها را از یک نسخه پاک (Clean checkout) اجرا میکند.
- عامل تأیید (Verification Agent): این اسکریپت را در یک محیط سندباکس ایزوله اجرا میکند.
فرآیند تأیید به کدهای خروج ساده (Exit codes) یا جستجوی الگوهای متنی (Grep) در لاگها تکیه نمیکند. در عوض، خروجی ساختاریافتهی چارچوبهای تست (Test-framework) را تجزیه میکند. یک محیط تنها زمانی پذیرفته میشود که بیش از ۹۰٪ از تستهای مورد انتظار جمعآوری شده باشند و نتایج پاس یا شکست در اجراهای مختلف تکرار شوند. شکستها به صورت اطلاعات ساختاریافته به مدل بازگردانده میشوند تا تعمیرات تکراری (Iterative repair) صورت گیرد.
با ترکیب یک محیط پایه از پیش پیکربندی شده، قالبهای سیستم ساخت (Build-system templates) و یک کتابخانه قابل بازیابی از دستورالعملهای ساخت تقطیر شده، AutoBuilder توانست نرخ موفقیت در ساخت محیطها را از ۱۶.۵٪ به ۵۷.۲٪ برساند. این فرآیند منجر به ایجاد بیش از ۱۰۰,۰۰۰ محیط تأییدپذیر در ۱۲ زبان برنامهنویسی مختلف شد.
دقت فنی در آموزش
در لایه آموزش، یک «چرخدنده مقیاسبندی دادهها» (Data Scaling Flywheel) پیاده شد تا مدل از میانبر زدن یا سختکد کردن (Hard-coding) برای پاس کردن تستها خودداری کند. این لایه شامل سه فیلتر مجزا است:
- راهنماییهای سطح فرآیند (Process-level hints): برای شکستهای «نزدیک به هدف»، سرنخهای هدفمندی داده میشود که بدون فاش کردن راهکار، نشان دهد مدل چه چیزی را باید بازرسی یا تأیید کند. این اقدام به تنهایی نرخ پاس شدن تکالیفی که قبلاً صفر درصد بود را به حدود ۲۰٪ رساند. پس از تأیید، یک مسیر (Trajectory) بدون راهنما از زمینه اصلی بازسازی میشود تا نشت راهنماییها (Hint leakage) اتفاق نیفتد.
- درگاههای قانونمحور (Rule-based gates): این درگاهها مسیرهای ناپایدار یا استراتژیهای متقلبانه مدل را حذف میکنند. یک مرحله امتیازدهی، معیارهایی چون اکتشاف، مکانیابی، استدلال پیش از ویرایش، وفاداری به مشخصات، قراردادهای مخزن، مینیمال بودن اصلاحیه، کیفیت تأیید، رفتار در بازیابی و صداقت مدل را ارزیابی میکند.
- تصادفیسازی تجهیزات (Harness randomization): برای جلوگیری از بیش-برازش (Overfitting) روی محیط تست، نام ابزارها، قراردادهای آرگومانها، فرمتهای خروجی و قالبهای پرامپت بهطور تصادفی تغییر میکنند. همچنین اختلالات واقعگرایانه از جمله نبود پیشنیازها، شکستهای گذرا در دستورات، خروجیهای ناقص و لاگهای نویزی تزریق میشوند.
حل شکاف زیرساختی در RL
یکی از یافتههای حیاتی در توسعه KAT-Coder-V2 این بود که محدودیتهای الگوریتمی نه، بلکه شکستهای زیرساختی باعث کاهش پاداش در یادگیری تقویتی (RL) میشدند. بررسیهای داخلی نشان داد حدود ۱۶٪ از مسیرهای RL به دلیل مشکلات سندباکس شکست میخورند (مثلاً عدم تراز مرزها که باعث میشد مشاهدات برای حدود ۴۰ گام خالی بمانند) و این موضوع ارتباطی به سیاست (Policy) مدل نداشت.
تیم KwaiKAT برای حل این مشکل سه بهروزرسانی خاص را اعمال کرد:
- سیاست تخلیه ایمیج (Image Eviction Policy): میزان استفاده از دیسک را از ۹۵٪ به ۶۰٪ کاهش دادند که باعث شد ریزشهای نامعتبر ناشی از Time-out از ۶-۷٪ به زیر ۱٪ برسد.
- اصلاح متغیرهای محیطی: متغیرها در هنگام مقداردهی اولیه سندباکس از راه دور اصلاح شدند تا از بازنویسیهای سیستمی که در ۶-۷٪ نمونهها باعث تغییر جهت پاداشها میشد، جلوگیری شود.
- سرور Gateway: برای جلوگیری از دریفت توکنها (Token drift) که در مقیاس ۲۰۰ دور به دلیل توکنایز کردن مجدد باعث ۴۰٪ خطا در نقاط انتهایی چت میشد، ارتباطات را مستقیماً به
/generateمنتقل کردند.
این اقدامات در مجموع نرخ خطای بازخورد سندباکس را از ۱۶٪ به زیر ۲٪ رساند و نرخ فروپاشیهای آموزشی (Training collapses) را تا یک مرتبه بزرگی (Order of magnitude) کاهش داد.
مکانیزمهای PPO و پاداش
تیم توسعهدهنده به دلیل اینکه تجهیزات عملیاتی، نشستها را به نمونههای ساختاری متمایز تقسیم میکنند، PPO با GAE را به روشهای بدون Critic ترجیح دادند. آنها از یک ساختار نامتقارن Actor-Critic استفاده کردند که در آن Critic به زمینههای ممتاز (Privileged context) شامل پاداشها، تستها، پوشش کد، اصلاحیهها، متادیتا و گامهای آینده دسترسی دارد؛ اطلاعاتی که در زمان استنتاج (Inference) حذف میشوند.
پاداشها به سه سطح تقسیم شدهاند:
- امتیازات هسته اصلی: نیازمند پاس شدن تمام تستهای fail_to_pass و pass_to_pass است.
- محدودیتهای رفتاری استاندارد: جریمه برای تکرار کد، فراخوانیهای نادرست ابزار و باقیماندههای کد دیباگ.
- انگیزههای مسیر شکست: امتیازدهی به بازیابی فایلها از طریق F2 و اعطای اعتبار جزئی برای تستهای پاس شده.
در نهایت، پنج متخصص از طریق روش Multi-Teacher On-Policy Distillation با استفاده از KL معکوس و کوتاهسازی آگاه از دریفت (Prune-OPD) با یکدیگر ادغام شدند.
بنچمارکها و وزنهای باز
در ارزیابیهای رودررو با استفاده از چارچوب یکپارچه Claude Code، مدل KAT-Coder-V2.5 در بنچمارک PinchBench با امتیاز ۹۴.۹، مدل Claude 3.5 Opus (با ۹۳.۵) را شکست داد. این مدل همچنین در SWE-Bench Pro با امتیاز ۶۵.۲ رتبه دوم را کسب کرد، هرچند از Opus 4.8 (با ۶۹.۲) عقب است. در بنچمارک داخلی KAT Code Bench نیز با امتیاز ۵۳.۱ رتبه دوم را کسب کرد (در مقابل ۵۷.۳). در SciCode نیز با امتیاز ۵۰.۳ با GLM-5.2 برابر شد.
اما در Terminal-Bench 2.1، این مدل با امتیاز ۶۰.۷ در جایگاه آخر قرار گرفت و از GLM-5.1 (با ۶۱.۸) و Opus 4.8 (با ۸۴.۶) عقب ماند.
بهطور جداگانه، نسخه KAT-Coder-V2.5-Dev بهعنوان یک مدل با وزنهای باز (Open Weights) تحت لایسنس Apache-2.0 در Hugging Face منتشر شد. این مدل یک ساختار ترکیب خبرهها (MoE) با ۳۵ میلیارد پارامتر کل و ۳ میلیارد پارامتر فعال است که بر پایه Qwen3.6-35B-A3B و با استفاده از ۱۲۷ هزار نمونه SFT و یادگیری تقویتی بعدی توسعه یافته است. نتایج این نسخه بر اساس پروتکل داخلی ارزیابی شده و با جدول اصلی پرچمدار قابل مقایسه نیست.
چرخش به سمت «محیطهای تأییدپذیر» نشان میدهد که مرز بعدی در کدنویسی هوش مصنوعی نه دادههای بیشتر، بلکه حلقههای بازخورد با دقت بالاتر است. با تضمین اینکه مدل نمیتواند از طریق میانبر زدن «تقلب» کند، KwaiKAT مدل را مجبور میکند تا واقعاً محدودیتهای سیستمیک مخزن کد را درک کند.
گام بعدی شما
- اگر توسعهدهنده هستید، نسخه Dev را در Hugging Face تست کنید تا قدرت مدلهای MoE کوچکتر را ببینید.
- بررسی کنید که آیا گردش کارهای CI/CD شما میتواند برای آموزش مدلها به محیطهای تأییدپذیر تبدیل شود یا خیر.
- متدهای حذف متادیتای گیت را برای جلوگیری از نشت داده در مجموعههای آموزشی خود پیاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو