تصور کنید یک پژوهشگر هوش مصنوعی ساعتها در صف انتظار بماند، در حالی که چندین GPU در خوشه (Cluster) — شبیه به پارکینگهای بزرگی که ماشینهای خاموش در آنها جا گرفتهاند — بدون هیچ استفادهای رزرو شدهاند. ظرفیت GPU اغلب زمانی هدر میرود که کارهای کوچک عیبیابی (Debugging)، کل شتابدهندهها را اشغال میکنند و پژوهشگران را پشت حافظههای رزرو شده اما بیکار متوقف میکنند. لامبدا (Lambda) برای حل این بنبست، زمانبند متنباز Run:ai را به عنوان یک گزینه مدیریتشده درجهیک در سرویس Lambda Kubernetes Service (LKS) معرفی کرد.
طبق اعلام این شرکت در پست وبلاگی مورخ ۱۳ اکتبر ۲۰۲۶، هدف از این ادغام، تسهیل پذیرش و بهرهبرداری از قابلیتهای Run:ai از طریق LKS است تا تیمها کنترل بیشتری روی نحوه تخصیص و اشتراکگذاری ظرفیت واحد پردازش گرافیکی (GPU) داشته باشند. لامبدا اشاره کرد که از سال ۲۰۲۲ از Run:ai در زیرساختهای خود استفاده میکرد، اما اکنون آن را به صورت یک سرویس یکپارچه ارائه میدهد تا پیچیدگیهای عملیاتی کاهش یابد.
زمینه و چالشهای workloads هوش مصنوعی
توسعه هوش مصنوعی نیازهای متفاوتی دارد. جلسات عیبیابی شاید فقط به بخشی از یک GPU نیاز داشته باشند، در حالی که مراحل ارزیابی (Evaluation) میتوانند به تعداد زیادی از کارهای مستقل تقسیم شوند. در مقابل، آموزشهای توزیعشده (Distributed Training) به تعداد زیادی GPU نیاز دارند که در یک لحظه بهطور متراکم به هم متصل باشند.
این نیازها با حرکت پروژه از ایدههای اولیه و آزمایشها به سمت تولید (Production)، تغییر میکنند. وقتی کارهای کوچک کل یک GPU را اشغال میکنند، ظرفیتهای رزرو شده بلااستفاده میمانند و سایر پژوهشگران متوقف میشوند. تیمها اغلب متوجه میشوند که آزمایشهایشان پشت GPUهای رزرو شده اما بیکارِ گروه دیگری گیر کرده است.
همانطور که در تحلیلهای قبلی ما درباره بهینهسازی هزینههای محاسباتی اشاره کردیم، مدیریت خوشههای سطح بالا بهدلیل نرخ خطای سختافزاری در مقیاس بزرگ، بسیار دشوار است. این چالشها در محیطهای بهینهشدهای مانند پلتفرم DSX انویدیا که توان عملیاتی توکنها را افزایش داده است نیز با استراتژیهای مدیریت منابع پیشرفته دنبال میشوند. تصور کنید زمانبندی همچنان کارهای حساس آموزشی را به گرهی (Node) بفرستد که دارای خطای حافظه یا لینک PCIe تضعیف شده است؛ در این حالت، کارهای پردازشی بهسادگی ناپدید میشوند. این همان شکافی است که لامبدا قصد دارد با ترکیب زمانبندی پیشرفته و بررسیهای خودکار سلامت سختافزار پر کند.
به نقل از لامبدا، این یکپارچگی بر اساس تصمیم انویدیا برای متنباز کردن KAI Scheduler تحت لایسنس Apache 2.0 در ۱ آوریل ۲۰۲۵ صورت گرفته است. KAI Scheduler یک راهکار بومی کوبرنتیز است که در اصل در داخل پلتفرم Run:ai توسعه یافته بود. با تبدیل Run:ai به یک کتابخانه مدیریتشده، کاربران دیگر نیازی به اسمبل کردن دستی اجزا از طریق Helm charts ندارند.
ارکستراسیون پیشرفته GPU
زمانبند Run:ai دو مکانیزم کلیدی را معرفی میکند که فراتر از قابلیتهای پیشفرض کوبرنتیز است:
- اشتراکگذاری GPU (GPU Sharing): این قابلیت اجازه میدهد چندین workload روی یک GPU اجرا شوند. این کار با تقسیم حافظه GPU به تکههای کوچکتر یا «GPUهای منطقی» انجام میشود. هر پاد (Pod) فضای حافظه مجازی مجزای خود را دارد و اندازه حافظه درخواست شده به شدت اعمال میشود تا نتواند به حافظه workload دیگری تجاوز کند. بهطور پیشفرض، این بخشها از قابلیت time-slicing انویدیا برای اشتراک در محاسبات استفاده میکنند. برای مثال، مدلی که از ۸ GPU استفاده میکند و به ۴۰ گیگابایت حافظه در هر GPU نیاز دارد، میتواند به جای اشغال کل حافظه هر کارت، مقدار ۸×۴۰ گیگابایت تخصیص یابد؛ در نتیجه ۴۰ گیگابایت دیگر روی هر GPU برای سایر workloadها در آن گره آزاد میماند. لازم به ذکر است که تقسیمبندی GPU و حالت Multi-Instance GPU (MIG) نمیتوانند بهطور همزمان روی یک گره استفاده شوند.
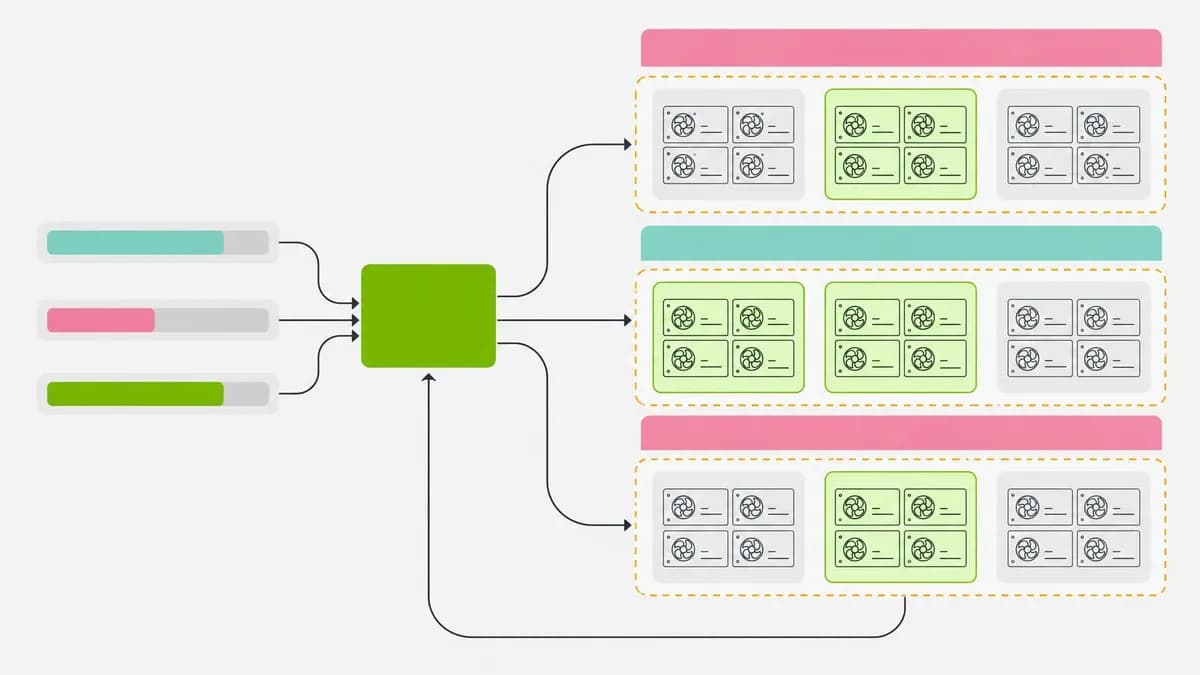
- زمانبندی مبتنی بر سهمیه (Quota-Based Scheduling): تیمها تخصیصهای تضمینشدهای دریافت میکنند اما میتوانند ظرفیتهای بلااستفاده گروههای دیگر را «قرض» بگیرند. زمانبند با استفاده از مقدار fair-share، منابع را در لحظه بازتعادل میکند و در صورت نیاز، workloadهایی که از سهمیه خود فراتر رفتهاند را پیشدستی (Preempt) میکند.
مکانیزمها و منطق زمانبندی
زمانبند انویدیا از یک چرخه مشخص برای مدیریت منابع استفاده میکند. این سیستم ابتدا یک snapshot از خوشه کوبرنتیز میگیرد و سهم عادلانه هر صف را از طریق فازهای «سهمیه استحقاقی» (deserved-quota) و «فراتر از سهمیه» (over-quota) محاسبه میکند. سپس عملیات تخصیص (allocate)، تجمیع (consolidation)، بازپسگیری (reclaim) و پیشدستی (preempt) را برای همسو کردن تخصیصهای فعلی با وضعیت محاسبه شده اجرا میکند.
- زمانبندی گروهی (Gang Scheduling): هر پاد جدید به یک گروه پاد اختصاص مییابد. Gang Scheduling تضمین میکند که یک workload متشکل از چندین پاد، یا بهطور کامل زمانبندی شود یا بهطور کامل در حالت انتظار (Pending) بماند.
- صفبندی سلسلهمراتبی (Hierarchical Queuing): صفهای زمانبندی برای هر پروژه و دپارتمان در هر node pool ایجاد میشوند. سهمیههای استحقاقی، workloadهای غیرقابل پیشدستی را محدود میکنند، در حالی که منابع فراتر از سهمیه فقط برای workloadهای قابل پیشدستی در دسترس هستند.
- یکپارچگی: یک podgrouper داخلی بهطور خودکار workloadها را به فریمورکهایی مانند Ray، Kubeflow، Argo و Training Operator متصل میکند.
- استراتژیهای جایگذاری: مدیران میتوانند استراتژیهای جایگذاری spread (پراکنده) یا bin-pack (متراکم) را برای هر node pool تنظیم کنند.
خود-اصلاحی سختافزاری (Hardware Auto-Remediation)
لامبدا اشاره کرد که زمانبندی تنها زمانی موثر است که سختافزار زیربنایی سالم باشد. در مقیاس بزرگ، شتابدهندهها خطاهای XID میدهند، ردیفهای حافظه بازنگری (Remap) میشوند، لینکهای NVLink و PCIe تضعیف شده و پورتهای InfiniBand به نرخهای پایینتر از حد انتظار میرسند. چون یک زمانبند استاندارد نمیتواند تفاوت بین یک GPU سالم و یکی در حال خرابی را تشخیص دهد، ممکن است همچنان کارهای پردازشی را به گرهی بفرستد که آنها را حذف میکند.
سرویس LKS اکنون با قابلیت «خود-اصلاحی» عرضه میشود که این خطاها را رصد میکند. این سرویس هر خطا را به عنوان یک وضعیت استاندارد گره کوبرنتیز (Node Condition) نمایش میدهد. وقتی یک وضعیت خطا فعال میشود، LKS بهطور خودکار گره را قرنطینه (Cordon) میکند تا از ورود کارهای جدید جلوگیری کرده و کارهای موجود را تخلیه (Drain) کند. این خطا یا بهطور خودکار اصلاح میشود و یا به بخش تعمیرات سختافزاری ارجاع میگردد. گره تنها پس از اعتبارسنجی مجدد به سرویس بازمیگردد.
LKS به عنوان یک محیط Cluster تک-کلیکی (1-Click) توصیف شده است که از GPU و InfiniBand (RDMA) پشتیبانی میکند و دارای حافظه دائمی مشترک (Shared Persistent Storage) در تمام گرهها است. این سرویس همراه با NVIDIA Network Operator و NVIDIA GPU Operator پیشنصب شده است و اعتبارسنجیهای مداوم را برای تایید عملکرد صحیح حافظه، شبکه و GPUها اجرا میکند.
نقشه راه کتابخانه مدیریتشده
لامبدا در حال تبدیل LKS به یک «کتابخانه نرمافزاری هوش مصنوعی» است. به جای ارائه دستورالعملهای نصب و یکپارچگی، لامبدا زمانبندهایی مانند Slurm و Run:ai را به عنوان اجزای تاییدشده، بستهبندی، تست و نگهداری میکند.
این رویکرد تضمین میکند که لایه ارکستراسیون کاملاً برای سختافزار خاصی که لامبدا ارائه میدهد، بهینه شده باشد. این شرکت بیان کرد که ماهیت متنباز Run:ai است که آنها را قادر میسازد مالکیت کامل بستهبندی و عملیات جاری را بر عهده بگیرند. لامبدا که خود پژوهشهای باز تولید میکند، اشاره کرد که توانایی بازرسی، تطبیق و بهبود ابزارهایی که به آنها وابسته است را ارزشمند میداند. در همین راسته، انویدیا برای پاسخ به نیازهای پردازشی محلی و عاملهای هوشمند، نسخه ۶۴ گیگابایتی DGX Spark را برای اجرای Agentهای محلی معرفی کرد تا انعطافپذیری سختافزاری را در سطوح مختلف فراهم کند.
برای یک مدیر کسبوکار، این تغییر یعنی زمان کمتر برای کارهای زیرساختی (Plumbing) و زمان بیشتر برای توسعه مدل. خوشه GPU از مجموعهای شکننده از سرورها به یک ابزار مشترک و تابآور تبدیل میشود که محاسبات را بر اساس نیاز تخصیص میدهد، نه رزروهای سختگیرانه.
گام بعدی شما
- اگر از خوشههای کوبرنتیز برای مدلهای زاینده استفاده میکنید، بررسی کنید که آیا مدل تخصیص منابع شما باعث ایجاد «جزایر حافظه بلااستفاده» شده است یا خیر.
- مستندات KAI Scheduler را برای پیادهسازی استراتژیهای Bin-pack در محیطهای غیر-لامبدا مطالعه کنید.
- وضعیت سلامت سختافزاری (Node Condition) را در مانیتورینگ خود به عنوان یک Trigger برای جابجایی خودکار workloadها تعریف کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو