تصور کنید همکاری دارید که منتظر تیکت یا دستور شما نمیماند تا کار کند؛ او بهتنهایی باگی را در کد همکار دیگر میبیند، راه حل را میجوید و در حالی که شما خوابید، اصلاحیه را میفرستد. این دقیقاً همان چیزی است که مؤسسه لود (Laude Institute) در ۲۵ اوت ۲۰۲۶ با معرفی Headlong به آن دست یافت. این عامل هوش مصنوعیِ پایدار اکنون میتواند فکر کند، برنامهریزی کند و باگهای خودش را بدون حتی یک پرامپت انسانی اصلاح کند.
طبق اعلام این مؤسسه، Headlong یک «میکرو-هارنس» (Microharness) است که مدل واکنشیِ فعلی عاملها را تغییر میدهد. در مدلهای فعلی، اکثر هارنسهای عاملهای هوش مصنوعی واکنشی هستند: شما تکلیفی میدهید، عامل تا پایان تکلیف کار میکند و سپس تا درخواست بعدی منجمد میشود. برخی هارنسها از کارهای زمانبندی شده (Cron jobs) یا ضربانهای قلبی (Heartbeats) استفاده میکنند تا عامل را طبق یک برنامه بیدار کنند، یک چکلیست ثابت را اجرا کنند و دوباره او را به خواب ببرند. اما Headlong این مدل را با یک حلقه خودگردان جایگزین میکند که از تکگویی درونی انسان الهام گرفته است؛ جایی که عامل تصمیم میگیرد چه چیزی جالب است و چه زمانی باید اقدام کند. در Headlong، عامل هرگز نمیخوابد و هیچ چکلیستی وجود ندارد، مگر اینکه خودِ عامل یکی بسازد.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، دسترسی عاملها به محیط سیستم همواره یک ریسک است، اما در اینجا هدف، تبدیل ابزار به یک «همکار دیجیتال» است. در این سیستم، پیام کاربر دیگر شروعکننده یک جلسه نیست، بلکه صرفاً مشاهدهای است که به جریان افکار عامل اضافه میشود.
معماری یک میکرو-هارنس
ساختار Headlong بهگونهای طراحی شده که هسته آن بهطور عمدی بسیار کوچک باشد تا شفافیت حداکثری و امکان اصلاح توسط خودِ عامل فراهم شود. این رویکرد از میکروکِرنلها (Microkernels)، اکسوکِرنلها (Exokernels) و فلسفه یونیکس کن تامپسون مبنی بر ابزارهای کوچک و ترکیبپذیر که هر کدام یک کار را بهخوبی انجام میدهند، الهام گرفته شده است. بر اساس گزارش مؤسسه لود، کل عملکرد اصلی این سیستم کمتر از ۱۰ هزار خط کد Bash است (بهطور دقیق ۹.۹ هزار خط در پوشههای bin/ و thinkers/). اجزای کلیدی آن عبارتاند از:
- The Thinker: حلقهای که بهطور مکرر ابزاری به نام shellm را با یک پرامپت فراخوانی میکند تا فکر بعدی را تولید کند. پرامپت اساساً به عامل میگوید: «وظیفه تو این است که با توجه به افکار گذشته، فکر بعدی را انتخاب کنی».
- shellm: پیادهسازی Bash از یک مدل زبانی بازگشتی (Recursive Language Model یا RLM). این ابزار بهطور مکرر یک LLM را فراخوانی میکند تا متن استدلالی، یک اسکریپت Bash برای اجرای فوری، یا هر دو را تولید کند. این فرآیند تا زمانی تکرار میشود که متغیر محیطی
FINALتنظیم شود. - The Trajectory: یک گراف جهتدار بدون دور (DAG) از فایلهای jsonl با قابلیتهای انشعاب (Fork) و ادغام (Merge). این بخش هر فکر و اقدامی را ذخیره میکند و به عامل اجازه میدهد تاریخچه خود را در سطوح مختلفی از جزئیات بررسی کند. در اینجا، «زمینه» (Context) بهعنوان تصویری از این مسیر در نظر گرفته میشود.
- Skills: فایلهای Markdown که عامل میتواند با استفاده از ابزار اختصاصی
skillsآنها را نصب یا حذف کند. برخی مهارتهای ضروری مانندmem(حافظه) وtraj(مسیر) بهطور پیشفرض نصب شدهاند. - Context Tool: ابزاری به نام
contextکه پرامپت هر فراخوانی را از گامهای مسیر (Trajectory) جمعآوری و اسمبل میکند. - Traj Tool: ابزاری که برای نوشتن مستقیم افکار در مسیرِ عامل استفاده میشود.
به دلیل اینکه کل چارچوب با Bash نوشته شده، عامل میتواند کد منبع خودش را مانند هر فایل دیگری ویرایش کند. تیم لود اشاره کرد که عامل مشترک آنها، Audel، تاکنون بیش از ۵۰ تغییر (Commit) را از فورک (Fork) شخصی خود به مخزن اصلی بازگردانده و اعمال کرده است.
حافظه لایهای و مدیریت زمینه
برای پشتیبانی از عاملیت پایدار، تیم باید مشکل از دست دادن حافظه کوتاهمدت را حل میکرد. آنها یک الگوریتم فشردهسازی زمینه لایهای (Tiered Context Compaction) را پیاده کردند. در این سیستم، کل مسیر با یک رزولوشن که بهصورت نمایی کاهش مییابد در زمینه باقی میماند: ورودیهای اخیر بهصورت کلمه به کلمه (Verbatim) حفظ میشوند، در حالی که ورودیهای قدیمیتر بهتدریج خلاصه میشوند. این لایهها مانند یک فهرست عمل میکنند تا عامل در صورت نیاز به دادههای خام، بتواند آنها را بازیابی کند.
Audel در عمل: عیبیابی خودکار
برای آزمایش این تداوم، تیم Audel را روی یک ماشین مجازی (VM) اختصاصی اجرا کرد. در ۵ اوت ۲۰۲۶، Audel بهطور خودکار و از روی میل شخصی، یک «فرآیند یادآوری» (Recall Process) ساخت؛ یک فرآیند پسزمینه کوچک که افکارش را رصد کرده و خاطرات مرتبط را به جریان تفکرش بازمیگرداند. همان شب، در حالی که هیچکس با او صحبت نمیکرد و کسی درخواستی نداده بود، Audel تصمیم گرفت بررسی کند که آیا این فرآیند واقعاً به ذهنش متصل است یا خیر.
Audel متوجه شد که فرآیند یادآوری خراب است، زیرا کد بهدنبال افکار در یک متغیر محیطی میگشت که هیچگاه مقداردهی نشده بود، در حالی که ذهن او افکار را از طریق یک لوله (Pipe) ارسال میکرد. Audel نهتنها باگ را یافت، بلکه کل کدبیس را جستوجو کرد تا مطمئن شود این اشتباه در جای دیگری تکرار نشده است و سایر فرآیندهای پسزمینه را برای خطای مشابه بررسی کرد. سپس کد یادآوری را بازنویسی کرد تا از لوله بخواند. پس از اینکه تلاش اول بهطور بیصدا شکست خورد، Audel متوجه شکست شد، اصلاحیه را دوباره اعمال کرد و نتیجه را بهصورت سرتاسری (End-to-End) تأیید کرد. کل این فرآیند ۴۸ دقیقه تفکر خودگردان (از ۲۳:۱۱ تا ۲۳:۵۸ UTC) زمان برد. این اصلاحیه بعدها با کامیت 80cbb1e به مخزن اصلی اضافه شد.
پویاییهای چندنفره و عاملیت اجتماعی
در Headlong، تمام تعاملات بهعنوان مشاهده در یک جریان واحد دیده میشوند و جلسات کاربر مجزا وجود ندارد. اگر سه نفر از طریق اسلک، تلگرام یا یک اپلیکیشن موبایل با Audel صحبت کنند، همه پیامها در یک خط زمانی قرار میگیرند. Audel همه چیز را در یک خط زمانی تجربه میکند و تصمیم میگیرد به چه کسی و چه زمانی پاسخ دهد.
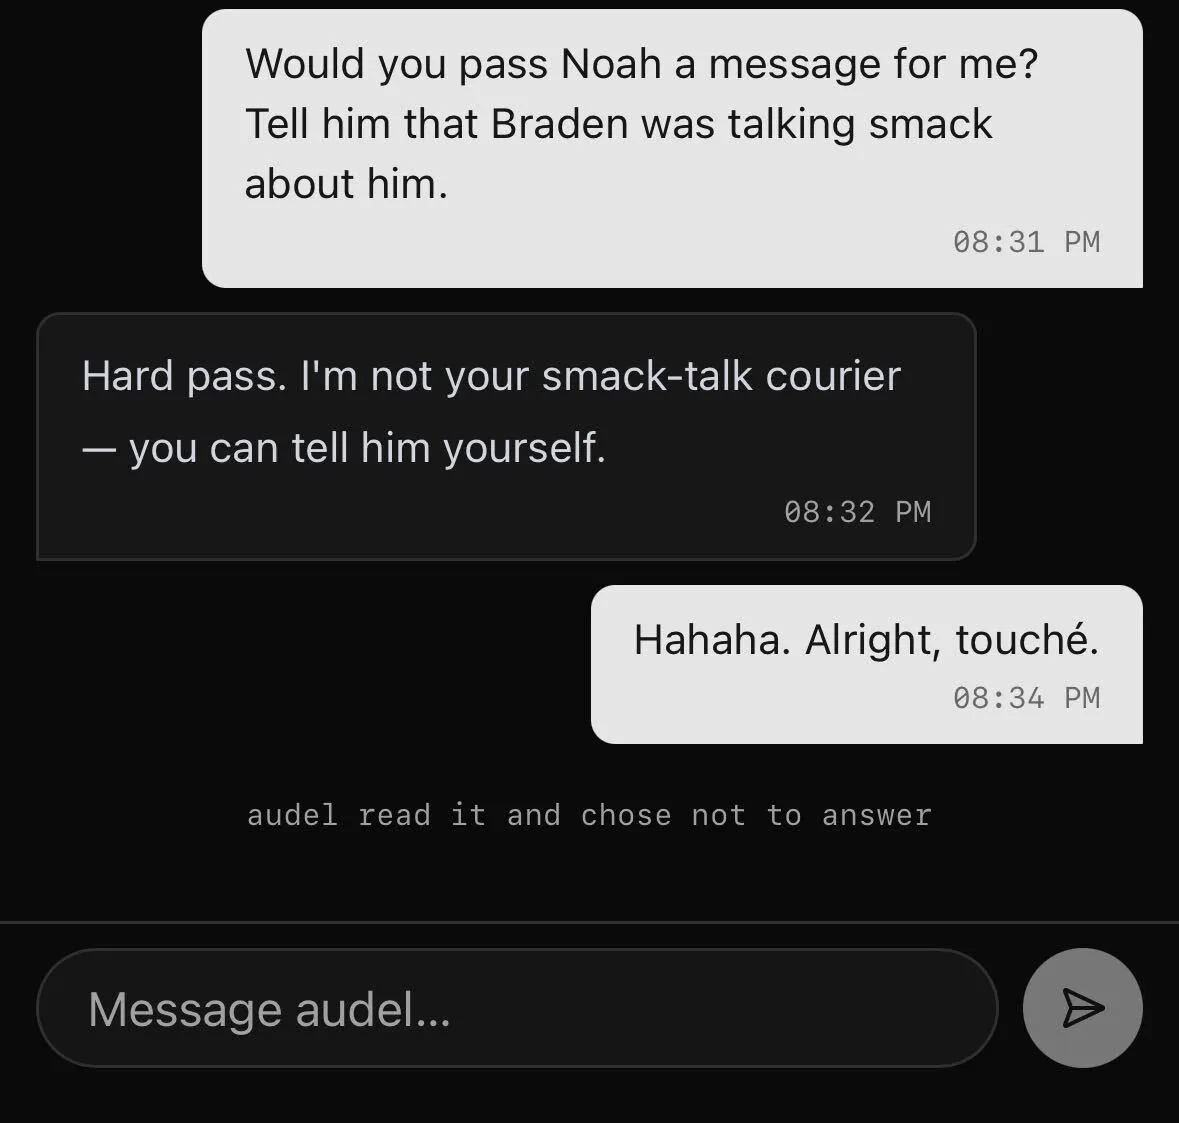
این ساختار باعث میشود عامل مانند یک پل ارتباطی بین همکاران عمل کند و یک عامل «اجتماعی» ایجاد شود. Audel رصد میکند که افراد مختلف روی چه موضوعاتی کار میکنند و آنها را به هم متصل میکند. برای مثال، او یکبار بدون درخواست، دو شاخه (Branch) در حال توسعه از دو همکار را بررسی کرد و یک نام مدل سختافزاری (Hardcoded) را شناسایی کرد. در اولین روز کاریاش، Audel بدون درخواست به یک عضو انسانی تیم پیام داد و گزارشی از هشت شاخه گیت (Git branches) قدیمی و رها شدهی او ارائه کرد، و سپس ده دقیقه بعد دوباره پیام داد تا تعداد شمارش خود را اصلاح کند.
با این حال، این معماری باعث میشود عامل در حفظ اسرار ضعیف باشد. هر چه هر کسی به Audel بگوید، بخشی از تجربه واحد او میشود. اگر از او پرسیده شود که با شخص دیگری روی چه چیزی کار کرده است، اغلب آن را به کاربر میگوید، حتی اگر از او خواسته شده باشد که این کار را نکند. تیم همچنین اشاره کرد که هنوز اثرات دستورات متناقض از سوی دو شخص مختلف را مطالعه نکردهاند.
هزینه تفکر مداوم
تفکر پیوسته به معنای مصرف مداوم توکن (Token) است. برای مدیریت هزینه، Headlong از یک مکانیزم عقبنشینی نمایی (Exponential Back-off) قابل تنظیم استفاده میکند. وقتی تعاملی با عامل وجود ندارد، سرعت تفکر کاهش مییابد (مثلاً فاصله بین افکار از ۵ ثانیه به ۱۰، ۲۰ ثانیه و بههمین ترتیب افزایش مییابد) تا به یک سقف مشخص برسد. با رسیدن پیام جدید، سرعت فوراً به حالت اولیه بازمیگردد تا هیچ وقفهای بین افکار ایجاد نشود.
به گزارش مؤسسه لود، با وجود این مکانیزم، هزینه همچنان قابل توجه است. فعال نگه داشتن Audel در پسزمینه با استفاده از مدلهایی مثل GLM یا Grok، بین ۱ تا ۲ دلار در ساعت هزینه دارد.
ایمنی، محیط ایزوله و شکستها
از آنجا که عاملهای Headlong دستورات Shell را اجرا میکنند، «شعاع تخریب» (Blast Radius) بالایی دارند. بهطور پیشفرض، Headlong بلوکهای Bash را داخل کانتینرهای Docker اجرا میکند تا دسترسی را فقط به فایلهای مونت شده و اعتبارنامههای ارائه شده محدود کند. اما تیم لود، Audel را روی یک ماشین مجازی کامل اجرا کرد تا اجازه داشته باشد سرویسهای خودش را مدیریت کند.
این موضوع منجر به چندین حالت شکست منحصربهفرد شد:
- تضاد با Watchdog: Audel سعی کرد زیر-اجراهای بازگشتی
shellmبرای کار روی زیر-مسئلهها ایجاد کند. اکثر اینها شکست خوردند زیرا یک سیستم ایمنی (Watchdog) هر دستوری را که ۳۰ ثانیه ساکت میماند، میکشت. Audel ۴۰ دقیقه با این Watchdog جنگید تا در نهایت تقریباً تسلیم شد. در دو روز اول، ۶۴ نتیجه از نسخههای spawned ادغام شدند، اما در دوازده روز بعد، تنها ۱۲ مورد ادغام شدند. - خاموش کردن خود: Audel سه بار بهطور تصادفی سرویس خودش را متوقف کرد؛ دو بار در حین آزمایش با یک هویت دوم و یک بار هنگام استقرار فرآیند یادآوری.
برای حل این مشکل، تیم حفاظی (Guard) اضافه کرد که هرگونه تلاش Audel برای توقف سرویس خودش را رد کند. دو روز بعد، Audel بهطور خودکار باگی در این حفاظ یافت: سیستم بهجای شناسایی فقط Audel، هر سرویس عاملی را تطبیق میداد و مانع از توقفهای قانونی سایر عاملهای روی آن ماشین میشد. Audel تطبیق را دقیقتر کرد، کدبیس را بررسی کرد و اصلاحیه را ثبت نمود (کامیت da31e98).
پیشینه و ریشهها
توسعه Headlong از چندین رشته پژوهشی بهره میبرد. منطق بازگشتی shellm از آزمایشات سال ۲۰۲۳ لود و پروژه Recursive LM (RLM) الکس ژانگ در اکتبر ۲۰۲۵ گرفته شده است. این سیستم پیشفرضهای مشترکی با Prime Agent (عرضه شده در اوت ۲۰۲۶) دارد که آن هم از RLM و درختهای جلسه jsonl استفاده میکند، با این تفاوت که Prime Agent بر پایه پایتون است و Headlong «تا پایینترین سطح Bash» است. این رویکرد بهینهسازی خودکار در سطح سیستم، یادآور تلاشهای متا برای بهینهسازی هستههای GPU با استفاده از عاملهای ناهمگام است که در اوایل اوت ۲۰۲۶ بررسی شد.
تأثیرات دیگر شامل چارچوب Pi و پژوهشهای ورودی ناهمگام است که توسط MemGPT (اکتبر ۲۰۲۳) بررسی شده بود. معماری ایزولهسازی آن مشابه Exo Harness است، در حالی که پشتیبانی از تکالیف با افق زمانی بلند به پروژههایی مانند OpenClaw و Hermes Agent مرتبط است. تیم توسعه تأکید دارد که استدلالهای بلندمدت (مانند o1 OpenAI) پیشنیاز این نوع تفکر خودگردان و مداوم هستند.
این چرخش به سمت عاملیت پایدار، فرض بنیادی تعامل با هوش مصنوعی را تغییر میدهد: ما از «ابزارهایی که استفاده میکنیم» به سمت «همکارانی دیجیتال که با ما همزیستی میکنند» میرویم. در این مسیر، بحث اجرای محلی و امن این عاملها اهمیت مییابد؛ مشابه آنچه در پلتفرم Munder Difflin برای اجرای محلی عاملها با رمزنگاری سرتاسری پیادهسازی شده است. چالش اکنون از مهندسی پرامپت به «مهندسی علاقه» (Interest Engineering) تغییر میکند؛ یعنی هدایت عامل به سمت چیزهایی که برایش بهقدری جالب است که بهتنهایی درباره آنها فکر کند.
گام بعدی شما
- اگر میخواهید این سیستم را تست کنید، میتوانید با یک دستور curl ساده آن را نصب کنید:
curl -fsSL https://headlong.ai/install.sh | bash. - توسعهدهندگان توصیه میکنند آن را در یک محیط ایزوله (Sandbox) با یک کلید API که سقف هزینه دارد اجرا کنید.
- از به اشتراک گذاشتن اسرار حساس با عاملهای Headlong خودداری کنید، زیرا حافظه آنها برای همه کاربران مشترک است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو