تصور کنید یک مدل هوش مصنوعی کوچک را دارید که در بازی تتریس هیچ ایدهای ندارد و فقط یک خط را پاک میکند، اما با یک تغییر مهندسی ساده، ناگهان به سطح حرفهایها میرسد. این دقیقاً همان اتفاقی است که در آزمایش جدید مدل Laya رخ داد تا ثابت کند مدلهای کوچک و تخصصی میتوانند در محیطهای با محدودیت زمانی شدید، مدلهای عمومی را شکست دهند. این نتیجه نشان میدهد که تخصصیسازی محلی، مسیری عملی برای منطق برنامههای بلادرنگ است؛ جایی که انتظار برای پاسخ یک مدل زبانی بزرگ (LLM) در ابر اصلاً یک گزینه نیست.
بسیاری از ادغامهای فعلی هوش مصنوعی بر مدلهای عظیم و عمومی متکی هستند که برای تولید متن طراحی شدهاند. اما در بازی تتریس، هدف گفتگو نیست؛ بلکه انتخاب یک حرکت درست از بین چند گزینه ممکن است. در این پروژه، از مدل Laya — یک مدل با وزنهای باز (Open Weights) — استفاده شد تا بررسی شود آیا رویکرد «سیستم یک» (System One) که در آن مدل فقط یک وضعیت را میگیرد و پاسخی ساختاریافته میدهد، میتواند با الگوریتمهای سنتی رقابت کند یا خیر.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی مدلهای محلی اشاره کردیم، کاهش وابستگی به ابر برای کاربردهای بلادرنگ یک ضرورت است. این رویکرد با فلسفهی پروژههایی مانند TouchGrass AI همسو است که برای بازگرداندن کاربران به دنیای واقعی، بر قدرت مدلهای محلی تأکید دارد. برای پیادهسازی این ایده، از کتابخانه llamadart برای اتصال مدل هوش مصنوعی به موتور بازی Dart/Flutter استفاده شده است. هدف این بود که ببینیم آیا مدل میتواند بدون نیاز به سختافزارهای عظیم، رفتار یک الگوریتم خبره را تقلید کند. این پروژه بخشی از یک سری پنجگانه درباره هوش مصنوعی محلی چندپلتفرمی برای Dart و Flutter است که در آن تصمیمگیریها، بردارها (Embeddings)، گفتار، تصاویر و نحوه ادغام آنها بررسی میشود.
معماری تصمیمگیری
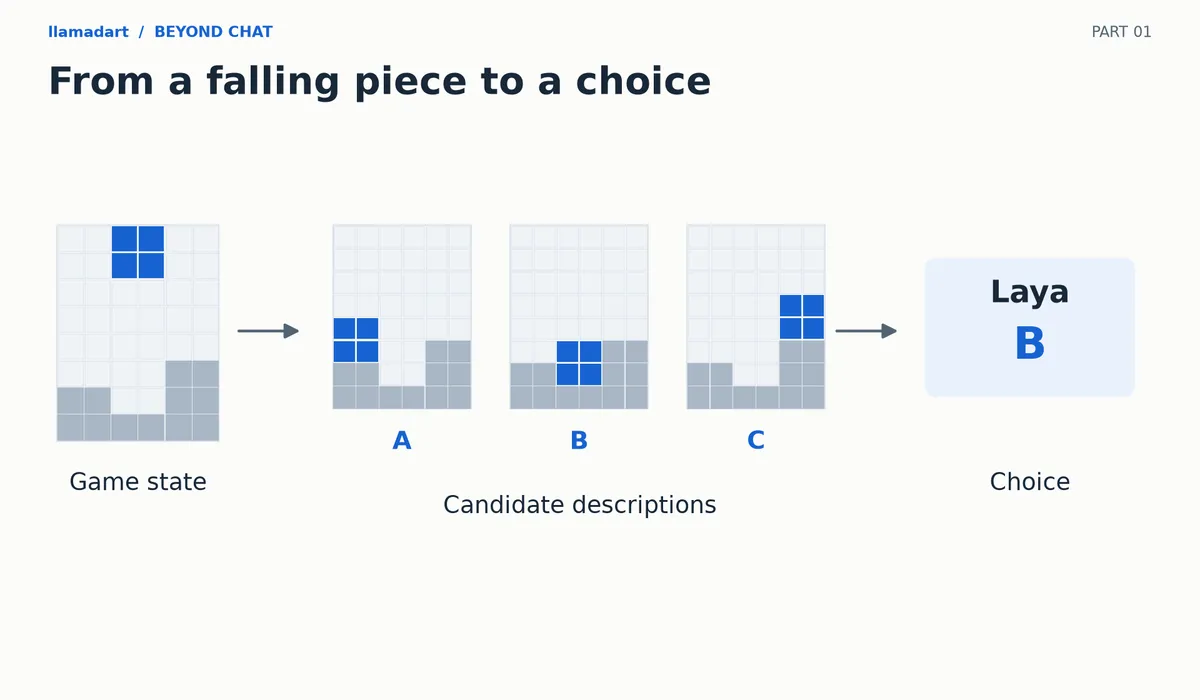
طبق مستندات این پروژه، سیستم از هوش مصنوعی نمیخواهد که بازی را از صفر مدیریت کند. در عوض، یک برنامهریز غیر-هوش مصنوعی ابتدا تمام حرکات قانونی، چرخشها و جابهجاییها را شناسایی میکند. این برنامهریز چرخشها، جابهجاییهای افقی و سقوط سریع (Hard Drop) را امتحان کرده و هر مسیری که مسدود باشد را رد میکند.
سپس هر گزینه به عنوان یک حرکت (Move) تعریف میشود که شامل موارد زیر است:
- یک موقعیت فرود قابل دسترس.
- توالی کلیدهای مورد نیاز برای رسیدن به آن موقعیت.
- اندازهگیریهای تخته پس از فرود.
اگر چندین توالی منجر به یک موقعیت فرود یکسان شوند، سیستم کوتاهترین توالی کشفشده را نگه میدارد. بازی هر فرود را شبیهسازی میکند تا تعداد خطوط پاکشده، تعداد حفرهها، ارتفاع ستونها و میزان «ناهمواری» (Bumpiness) را بشمارد. این پیامدها توسط تابع describeCompact() پردازش شده و دادهها را به متنی تبدیل میکند که برای مدل Laya ارسال میشود. مدل به جای تولید کلیدها، صرفاً از بین توصیفات موجود، بهترین گزینه را انتخاب میکند.
خط لوله فنی
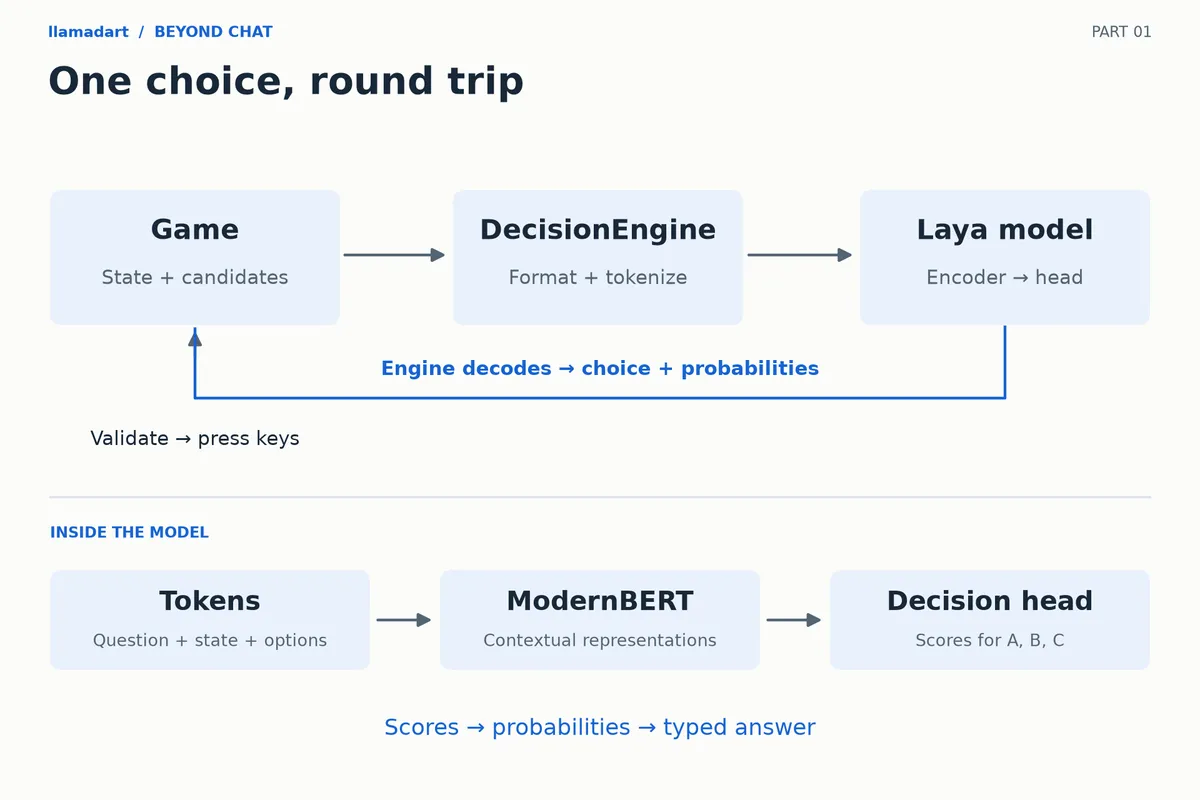
این سیستم از یک رمزگذار ModernBERT استفاده میکند که از طریق llama.cpp اجرا میشود. فرآیند به دو بخش تقسیم شده است: یک رمزگذار منجمد و یک لایه تصمیمگیرنده قابل آموزش.
- رمزگذار (Encoder): سوال، گزینهها و وضعیت بازی را با هم میخواند. این بخش ورودی را بدون تولید هیچ متنی پردازش میکند.
- لایه تصمیمگیرنده (Decision Head): به موقعیتهایی که هر گزینه را مشخص میکنند امتیاز میدهد؛ سپس رمزگشا (Decoder) این امتیازها را به احتمالات تبدیل میکند.
- اجرا: موتور بازی انتخاب را تأیید میکند. چون جاذبه در حین استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه به خودِ آشپزی و نه دورهی آموزش آشپز — فعال است، سیستم باید سریعاً برنامهریز را دوباره اجرا کند تا مسیری برای رسیدن به موقعیت انتخابشده از وضعیت فعلی قطعه پیدا کند. اگر قطعه قبلاً قفل شده باشد یا مسیر فرود مسدود شده باشد، حرکت به عنوان شکست ثبت شده و بازی قطعه را سریعاً پایین میاندازد (Hard-drop).
واژگان سیستم یک و Jev
پلتفرم Jev از شرکت TypeSafe، چارچوب مفهومی این رویکرد را فراهم کرده است. Jev «سیستم یک» را به معنای ارائه وضعیت و پرسشهای تایپشده برای دریافت پاسخهای ساختاریافته مستقیماً در کد تعریف میکند. Laya یک مدل مجزای با وزنهای باز است که دارای رابط سازگار با Jev است.
در این آزمایش، DecisionEngine توکنها را آماده کرده و امتیازات مدل را رمزگشایی میکند. نتایج بهدستآمده بهطور خاص عملکرد Laya و لایه تنظیمشدهی آن برای تتریس را میسنجد، نه خودِ Jev را. این ساختار اجازه میدهد تا بازی در حین انتظار برای پاسخ از خط لوله محلی، به اجرای خود ادامه دهد.
مقایسه مدل پایه در برابر مدل تنظیمشده
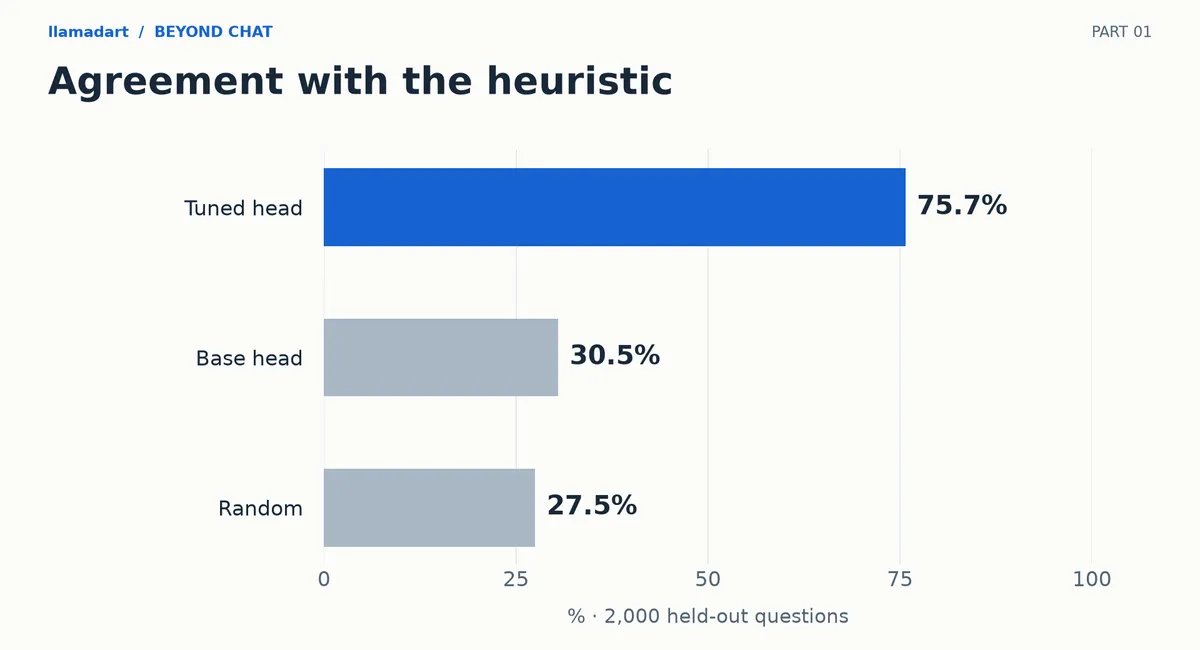
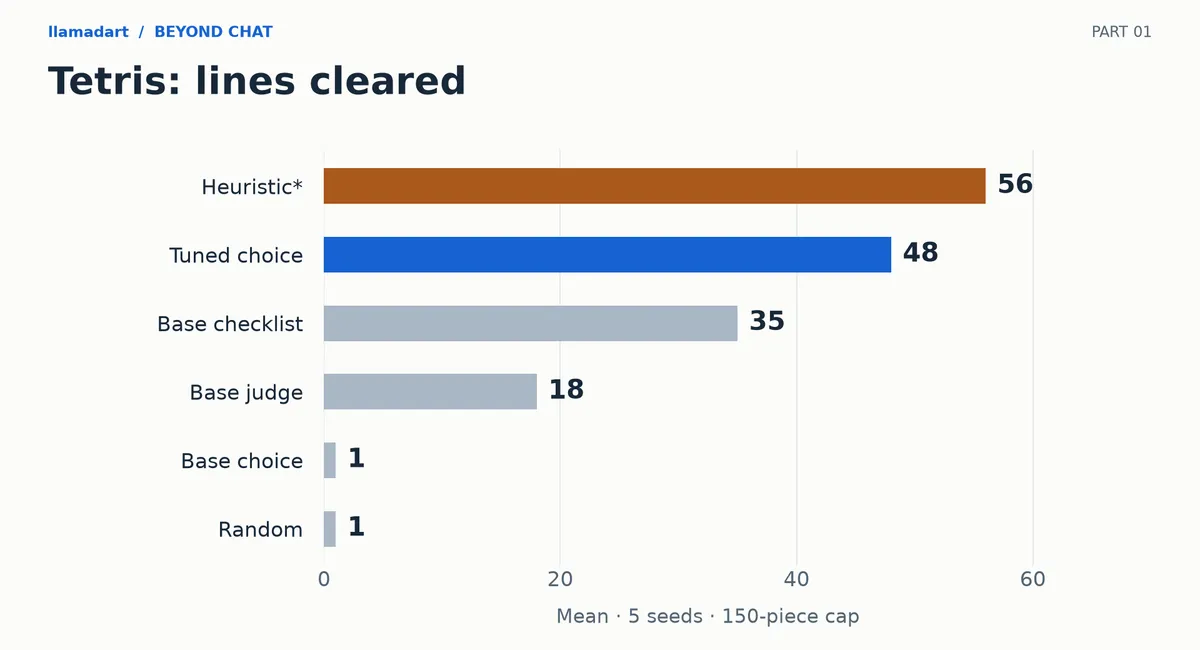
تفاوت عملکرد مدل خام و مدل تنظیم دقیق (Fine-tuning) — مثل وقتی به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — تکاندهنده است. وقتی ۶ گزینه به مدل داده شد، لایه پایه Laya بهطور متوسط تنها ۱ خط را پاک میکرد که عملاً با حدس تصادفی برابر بود.
برای بهبود این وضعیت، از یک بازیکن الگوریتمی (Heuristic) به عنوان «معلم» استفاده شد. تیمی از توسعهدهندگان مجموعهای از ۱۶,۰۰۰ سوال آموزشی و ۲,۰۰۰ سوال اعتبارسنجی از بازیهای مختلف تولید کردند. برچسبها (Labels) از روی الگوریتم خبره استخراج شدند و در مواردی که چندین حرکت بهترین بودند، احتمال هدف بین آنها تقسیم شد. این رویکرد یادگیری از محیطهای شبیهسازی شده، یادآور تحقیقاتی است که بررسی میکند چگونه دادههای بازیهای ویدئویی میتوانند برای آموزش هوش مصنوعی در دنیای فیزیکی و خودروهای خودران به کار روند.
با ثابت نگه داشتن رمزگذار و آموزش تنها لایه تصمیمگیرنده، صحت تقلید مدل از الگوریتم خبره از ۳۰.۵٪ (در حالی که حدس تصادفی ۲۷.۵٪ بود) به ۷۵.۷٪ جهش کرد. در هشت اجرای ثبتشده با ۱۲ دوره (Epoch)، نتایج بین ۷۵.۵٪ تا ۷۸.۵٪ متغیر بود. این آموزش با استفاده از MPS انجام شد، هرچند نتایج آن بیت-به-بیت تکرارپذیر نبود.
نتایج واقعی بازی
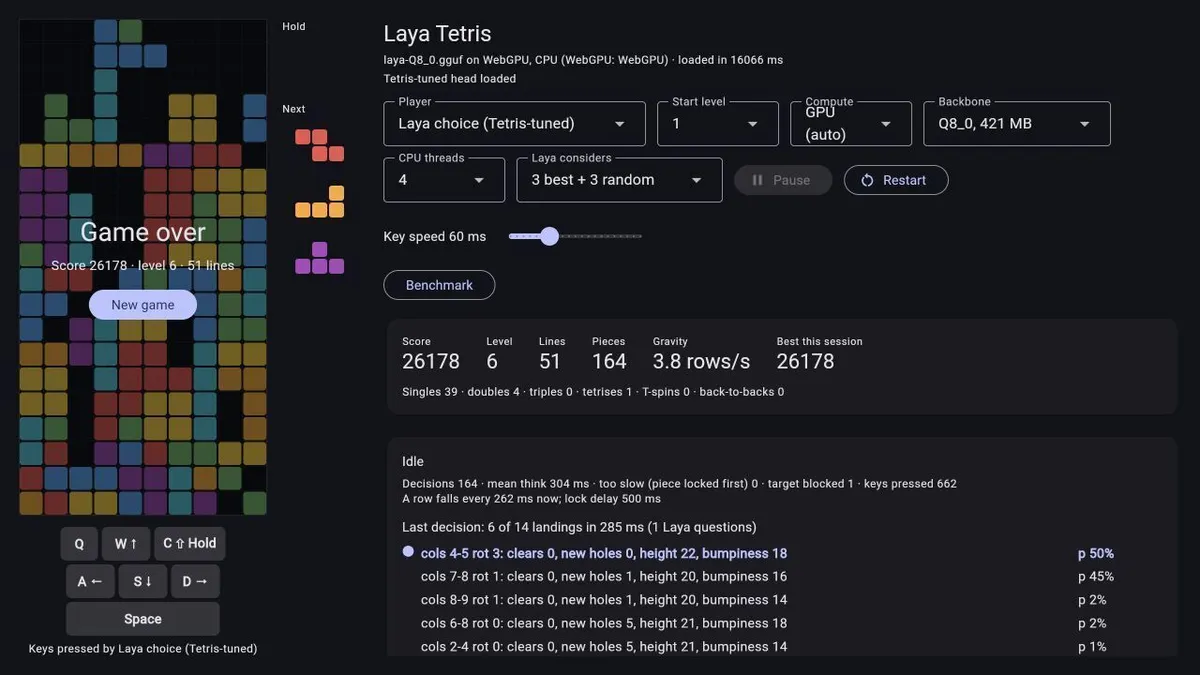
در تستهای محدود، بازیکن تنظیمشده ۴۸ خط را پاک کرد که به میانگین ۵۶ خطِ الگوریتم خالص نزدیک بود. در اجراهای زنده مرورگر با استفاده از WebGPU، کوانتایزیشن Q8_0 و ترکیب گزینهها، این عدد به ۵۱ خط رسید.
محدودیت تأخیر
در تتریس، پاسخی که بعد از قفل شدن قطعه برسد، بیفایده است. بر اساس اندازهگیریها روی تراشه M4 Max با استفاده از Metal، پردازش یک سوال ۱۷۵ توکنی با ۶ گزینه، تقریباً ۲۰ میلیثانیه زمان برد.
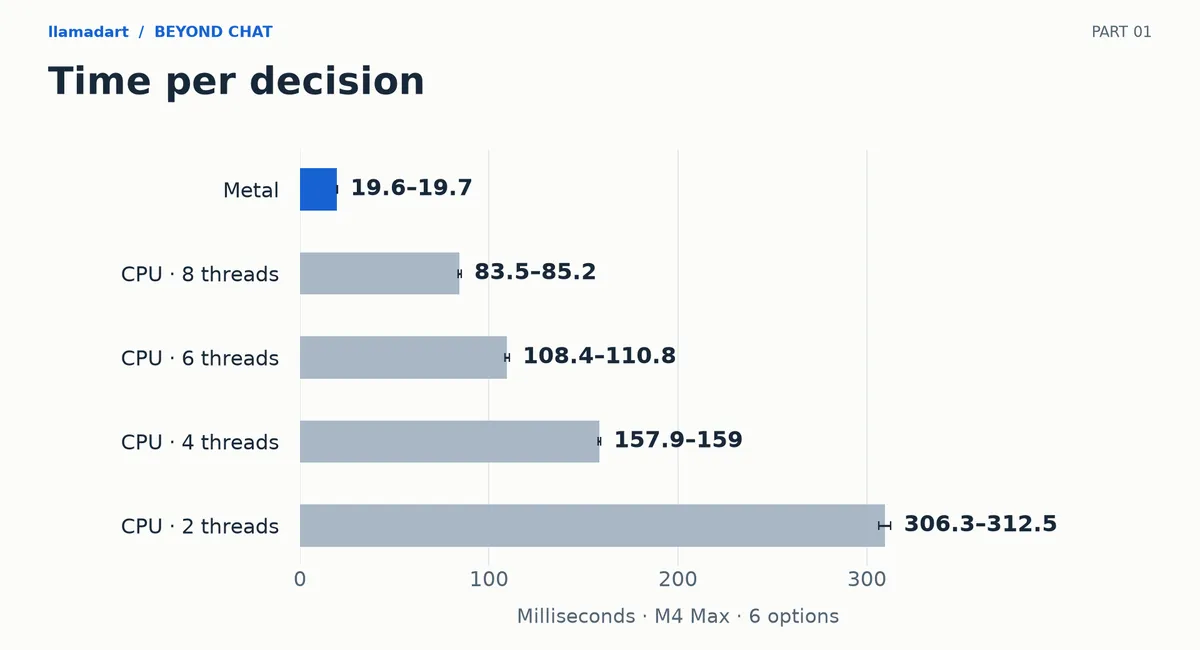
این سرعت حیاتی است؛ زیرا اجرای محلی، نوسانات شبکه در APIهای ابری را حذف میکند. در ۴۰ بازی بلادرنگ ثبتشده، مدل تنظیمشده بهطور متوسط ۵۲.۳ خط را با لیست کوتاه ترکیبی و ۵۱.۵ خط را با تمام گزینهها پاک کرد. تمام پاسخها پیش از قفل شدن قطعه رسیدند.
جزئیات پیادهسازی و API
توسعهدهندگان میتوانند این الگو را با دستور dart pub add llamadart پیاده کنند. یک نمونه مستقل برای اجرا، نیازمند دانلود یک رمزگذار حدود ۴۲۱ مگابایتی و یک لایه تصمیمگیرنده ۱۰۶ مگابایتی است.
این API از سه نوع پرسش پشتیبانی میکند:
- انتخاب (Choice): انتخاب بهترین گزینه از یک لیست (مثلاً «کدام موقعیت فرود را استفاده کنیم؟»). یک
ChoiceAnswerشامل برچسب انتخابشده و نقشه احتمالات برمیگرداند. - امتیاز (Score): یک مقدار مورد انتظار در سطوح مرتبشده (مثلاً «این درخواست چقدر فوری است؟»).
- بله/خیر (Noul): احتمال درستی یک گزاره (مثلاً «آیا این حرکت یک خط را پاک میکند؟»).
تنظیمات بازیکن و گزینهها
این آزمایش نحوه انتخاب حرکات را از حرکاتی که بررسی میشوند جدا میکند:
- گزینههای بازیکن: انسانی، الگوریتمی (Heuristic)، تصادفی، داور Laya، چکلیست، انتخاب پایه یا انتخاب تنظیمشده.
- گزینههای کاندید: ۳ مورد برتر + ۳ مورد تصادفی (لیست کوتاه ترکیبی)، ۶ مورد برتر، ۶ مورد تصادفی، یا تمام حرکات قانونی تولید شده.
در حالی که بازیکن الگوریتمی تمام حرکات قانونی را بررسی میکند، بازیکن انتخاب پایه حداکثر ۶ مورد را میپذیرد. بازیکن تنظیمشده میتواند مجموعههای بزرگتر را از طریق دورهای حذفی مدیریت کند.
بهبود مدل پایه
فراتر از انتخاب ساده، تیم توسعه رویکرد «چکلیست» را نیز آزمایش کرد. با پرسیدن سوال «آیا این یک حرکت خوب است؟» برای هر گزینه، میانگین پاکسازی به ۱۸ خط رسید. در یک چکلیست محدودتر — که میپرسید آیا حرکت خطی را پاک میکند و آیا حفره ایجاد میکند و سپس احتمال دوم را از اول کم میکرد — این عدد به ۳۵ خط رسید. این کار توانایی Laya در تفسیر حقایق از متن را میسنجد، هرچند بازی این مقادیر را بهطور محاسباتی میداند.
آموزش و اعتبارسنجی
آموزش در یک نوتبوک پایتون انجام میشود در حالی که رمزگذار منجمد (Frozen) میماند. فرآیند شامل تولید مجموعه داده با دستور dart run bin/make_dataset.dart و اجرای laya_head_tuning.ipynb است. فایل نهایی laya-head-tetris.safetensors سپس در API دارت بارگذاری میشود.
برای اطمینان از قابلیت اطمینان، پیادهسازی با Laya 0.3.5 مقایسه شد. یک تست ۲۴ سوالی هیچ تغییری در تصمیمات نشان نداد. اما در یک مجموعه گستردهتر ۱۸۷ سوالی، مشخص شد که احتمالات بله/خیر در حالت Q8_0 روی CPU ممکن است تغییر کنند (مثلاً از ۰.۶۹۴ به ۰.۴۵۷) و احتمالاً از مرز ۰.۵ عبور کنند، در حالی که حالت F32 پایدار ماند.
تحلیل: چرخش به سمت تخصصیسازی محلی
این آزمایش این فرض را که برای تصمیمگیری بهتر به مدلهای بزرگتر نیاز داریم، تغییر میدهد. ثابت میکند که یک مدل محلی کوچک نیازی نیست یک نابغه عمومی باشد؛ بلکه فقط باید در بازه زمانی تعیینشده توسط برنامه، «به اندازه کافی خوب» باشد.
برای توسعهدهندگان، این بدان معناست که مسیر رسیدن به عاملهای هوش مصنوعی با کارایی بالا، شاید از طریق پنجرههای کانتکست بزرگتر یا پرامپتهای پیچیدهتر نباشد، بلکه از طریق آموزش «سرهای» (Heads) کوچک و متمرکز بر روی رمزگذارهای منجمد و باکیفیت باشد. این کار ردپای محاسباتی را کاهش و قابلیت اطمینان را به حداکثر میرساند. فرمت فعلی Laya دارای محدودیت توالی ۵۱۲ توکنی است، به این معنی که توصیفات بسیار طولانی ممکن است قطع شوند.
گام بعدی شما
- دموی مرورگری تتریس را امتحان کنید و بین بازیکن پایه و تنظیمشده جابهجا شوید تا تغییر احتمالات را در لحظه ببینید.
- اگر توسعهدهنده Flutter هستید، بسته
llamadartرا برای پیادهسازی تصمیمگیرندههای محلی بررسی کنید. - برای درک بهتر نحوه مدیریت دادهها در لبه، منتظر بخش بعدی این سری درباره بردار معنایی (Embedding) باشید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو