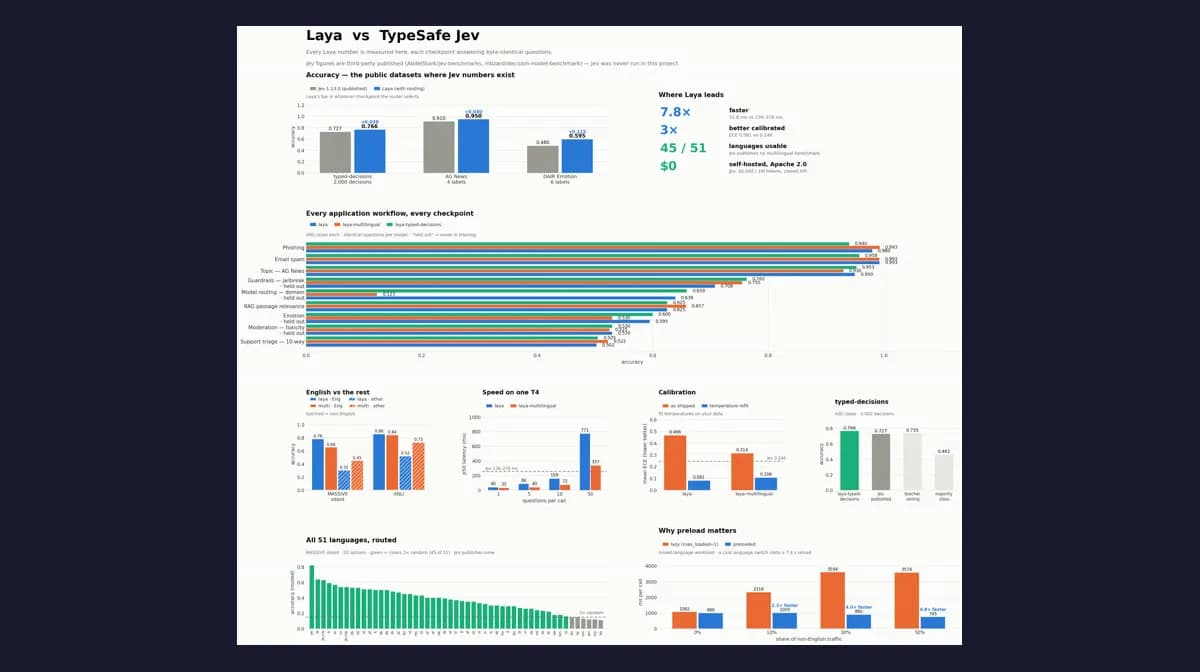
تصور کنید سیستمی دارید که بهجای تولید کلمه به کلمه، پاسخ نهایی را در یک چشمبهمزدن صادر میکند. مدل Laya با ۴۲۱ میلیون پارامتر، اکنون میتواند تصمیمات تایپشده را در ۳۲.۸ میلیثانیه روی یک GPU مدل T4 پردازش کند و عملاً گلوگاه تولید توکن را در طبقهبندیهای حجیم از بین ببرد. این معماری غیرخودبازگشتی (Non-autoregressive) اجازه میدهد مدل بهجای تولید جریانی از متن، تنها یک پاسخ ساختاریافته صادر کند، که باعث میشود نقض طرحواره (Schema violation) بهصورت ساختاری غیرممکن شود. زیرا هیچ چیزی توکن به توکن تولید نمیشود، مدل صرفاً یک انتخاب، یک امتیاز یا یک احتمال را خروجی میدهد و تمام پاسخ همان است.
این چرخش به سمت موتورهای «سیستم ۱» در حالی رخ میدهد که توسعهدهندگان با تأخیر و هزینه بالای مدلهای زبانی بزرگ (LLM) دستوپنجه نرم میکنند. نام این رویکرد از چارچوب دانیل کانمن وام گرفته شده است: تفکر سیستم ۱ سریع و غریزی است (مانند واکنشهای لحظهای یا تصمیمات شهودی)، در حالی که سیستم ۲ کند و تحلیلی است. همانطور که در تحلیل قبلی ما دربارهی شکست عاملهای هوش مصنوعی در وظایف پیچیده وب اشاره کردیم، صنعت اکنون در حال دوشاخگی است: استفاده از مدلهای کند و تحلیلی «سیستم ۲» برای برنامهریزی و مدلهای برقآسای «سیستم ۱» برای فیلترهای سریع و گیتهای بازرسی.
Laya و Jev (محصول شرکت TypeSafe AI) هر دو در سپتامبر ۲۰۲۶ و با فاصله شش روز از هم منتشر شدند و از حلقه آموزشی یادگیری تقویتی برای تصمیمات کالیبره شده (RLCD) بهره میبرند. تفاوت اصلی در لایسنس و نحوه ارائه است: Laya با لایسنس Apache 2.0 و بهصورت وزنهای باز (Checkpoints) منتشر شده تا روی سختافزار شخصی اجرا شود، اما Jev یک API مدیریتشده است که توسط دیوگو آلمیدا، یکی از مخترعان ChatGPT، تأسیس شده است. این دو مدل، یک کلاس جدید از مدلها را از دو سوی خط لایسنس تعریف میکنند. این رقابت میان مدلهای باز و بسته، یادآور ارزیابیهای فنی ماست که نشان داد مدلهای کوچک تنظیمشده میتوانند تا ۲۰ برابر سریعتر از APIهای تجاری عمل کنند.
زمینه و خاستگاه مدلها
به نقل از مستندات پروژه، Laya و Jev بیش از آنکه رقیب باشند، خواهرزادههای یک خانواده آموزشی هستند. با این حال، فلسفه محصول آنها متفاوت است. Jev بهعنوان یک سرویس مدیریتشده برای سازمانهایی جایگاهسازی شده است که ترجیح میدهند بهجای مدیریت زیرساخت، از توافقنامههای سطح خدمات (SLA) و خدمات پذیرش اختصاصی (Concierge onboarding) استفاده کنند. در مقابل، Laya برای جامعه متنباز طراحی شده و با ارائه وزنهای کامل، امکان استقرار در محیطهای ایزوله (Air-gapped) را فراهم میکند.
تأیید عملکرد این مدلها از طریق تطبیق مخزن گیتهاب Laya با تحلیلهای AI Model Report در مورد محک مشترک تصمیمات تایپشده صورت گرفته است. دادهها تأیید میکنند که تأخیر p50 روی GPU T4 برابر با ۳۲.۸ میلیثانیه و صحت تنظیمشده (Fine-tuned accuracy) آن ۰.۷۶۶ است. استقبال جامعه فنی فوری بود و مخزن Laya در عرض یک هفته پس از عمومی شدن، ۲۴.۵ هزار ستاره دریافت کرد.
فلسفه سیستم ۱
یک موتور تصمیمگیرنده سیستم ۱ بهطور خاص آموزش دیده تا برای یک پرسش تایپشده، تنها یک پاسخ ساختاریافته و کالیبره شده صادر کند. برخلاف مدلهای زبانی استاندارد، این مدل جریانی از توکنها را تولید نمیکند. همین تفاوت مکانیکی است که سرعت را ممکن میکند؛ مدل کل ورودی را میخواند و خروجی را در یک گذر (Single pass) مینویسد.
پست معرفی TypeSafe بر این کارایی تأکید دارد و ادعا میکند که تأخیر انتهای-به-انتهای Jev بین ۷۰ تا ۵۰۰ میلیثانیه است. Laya چهار روز بعد با استفاده از همان دستورالعمل RLCD اما با رویکرد وزنهای باز و یک مسیریاب برای تشخیص زبان معرفی شد. برخی تحلیلگران، از جمله تحلیلگران KDnuggets، استدلال میکنند که مسائلی که این مدلها حل میکنند آشنا هستند و نوآوری واقعی نه در خود وظایف، بلکه در معماری، کالیبراسیون و تجربه توسعهدهنده نهفته است.
معماری فنی و مؤلفهها
مدل Laya بر پایه رمزگذار ModernBERT-large ساخته شده است. این مدل دو نقطه بازرسی (Checkpoint) اصلی ارائه میدهد: نسخهای با ۴۲۱ میلیون پارامتر برای زبان انگلیسی و نسخهای با ۳۲۲ میلیون پارامتر بر پایه mmBERT-base برای بیش از ۱۰۰ زبان. یک مسیریاب داخلی بهطور خودکار اسکریپت ورودی را تشخیص داده تا درخواستها را بهدرستی هدایت کند.
پیکربندی و جزئیات فنی
- پنجره زمینه (Context Window): پیشفرض ۵۱۲ توکن برای انگلیسی و ۱,۰۲۴ برای ورودیهای چندزبانه است. این مقدار با استفاده از تنظیم
max_lenتا ۸,۱۹۲ توکن قابل گسترش است. در مقابل، Jev تا ۶۴,۰۰۰ توکن را پشتیبانی میکند. - پشتیبانی چندزبانه: ۴۵ زبان از ۵۱ زبان محکزده شده، از سد کاربردی (3x-random usability bar) عبور کردهاند. در مقابل، Jev هیچ محک منتشرشدهای برای زبانهای غیرانگلیسی ندارد.
- هدف آموزش: Laya از هدف RLCD استفاده میکند؛ به این معنا که مدل برای این پاداش داده میشود که وقتی در ۷۰٪ موارد درست میگوید، اعلام کند «۷۰٪ مطمئنم»، که منجر به ایجاد احتمالات کالیبره شده میشود.
- گزینههای استقرار: پروژه دارای بیلدهای Docker برای ARM64 و DGX Spark است و یک نوتبوک Kaggle برای تنظیم دقیق (Fine-tuning) طراحی شده برای سیستمهای 2xT4 ارائه داده است.
- سرعت توسعه: این مخزن شاهد تکرار سریع بوده و در هفته اول انتشار، ۴۱۳ کامیت و ۲۳ تگ ثبت کرده است.
ابزارهای تصمیمگیری اصلی
این مدل از سه ابزار (Primitive) اصلی برای تصمیمگیری در محیط تولید استفاده میکند:
- Choice (انتخاب): یک برچسب را از مجموعهای ارائه شده انتخاب میکند و طبقهبندی و تشخیص قصد را در یک فراخوانی ترکیب میکند.
- Score (امتیاز): یک جایگاه را در یک معیار رتبهای (Ordinal rubric) تعیین میکند، مانند سطوح شدت از ۱ تا ۵.
- Noul: یک مقدار بولی (Boolean) با احتمال کالیبره شده برمیگرداند که بهعنوان یک فیلتر سریع برای تصمیمات بله/خیر در حجم بالا عمل میکند.
محکهای عملکرد
بر اساس دادههای مخزن گیتهاب Laya و AI Model Report، تأخیر p50 مدل روی GPU T4 برابر با ۳۲.۸ میلیثانیه است. هنگام دستهای کردن (Batching) ۱۰ پرسش، میانگین تأخیر به ۷.۲ میلیثانیه برای هر پرسش کاهش مییابد و کل دسته در ۷۲.۳ میلیثانیه تکمیل میشود. پذیرش سریع مخزن با رسیدن به ۲۴.۵ هزار ستاره در هفته اول مشهود است.
در رویارویی مستقیم در یک محک مشترک با ۲,۰۰۰ تصمیم، Laya تنظیمشده به صحت ۰.۷۶۶ رسید، در حالی که Jev امتیاز ۰.۷۲۷ را کسب کرد. با این حال، AI Model Report اشاره کرد که Laya روی بخش آموزشِ همان محک تنظیم شده بود، در حالی که امتیاز Jev یک عدد Out-of-the-box (بدون تنظیم) بود. این عدم تقارن، جزئیاتی حیاتی برای توسعهدهندگانی است که این دو را مقایسه میکنند.
نقاط قوت Jev
با وجود سرعت Laya، مدل Jev در وظایف با تاکسونومی گسترده و استدلالهای با زمینه طولانی برتر است. در محک Banking77 که دارای ۷۷ برچسب قصد مختلف است، Jev امتیاز ۰.۸۷۰ را کسب کرد، در حالی که Laya با ۰.۴۲۵ به شدت متزلزل بود. Laya در انتخابهای محدود میدرخشد، اما Jev در تاکسونومیهای وسیع برنده است.
اندازه پنجره زمینه تفاوت بزرگ دیگر است. Jev تا ۶۴,۰۰۰ توکن را پشتیبانی میکند، به این معنی که تصمیمگیری روی اسناد کامل بدون تکهبندی (Chunking) از دسترس Laya خارج است. همچنین، عملکرد Zero-shot مدل Laya بهطور قابلتوجهی پایینتر است و برای رسیدن به نتایج مشابه Jev نیاز به تنظیم محلی دارد.
جدول مقایسهای رویارویی
| معیار | Laya | Jev 1.13.0 |
|---|---|---|
| لایسنس | Apache 2.0، میزبانی شخصی | API بسته، دسترسی با لیست انتظار |
| پارامترها | ۴۲۱ میلیون (انگلیسی) / ۳۲۲ میلیون (چندزبانه) | اعلام نشده |
| تأخیر (۱ پرسش) | ۳۲.۸ میلیثانیه p50 روی T4 | ۲۳۶ تا ۲۷۶ میلیثانیه (شخص ثالث) / ۷۰-۵۰۰ میلیثانیه (سازنده) |
| زمینه | ۵۱۲ تا ۱,۰۲۴ (تا ۸,۱۹۲) | تا ۶۴,۰۰۰ توکن |
| تصمیمات تایپشده | ۰.۷۶۶ (تنظیمشده) / ۰.۳۶۲ (Zero-shot) | ۰.۷۲۷ |
| Banking77 | ۰.۴۲۵ | ۰.۸۷۰ |
| زبانها | ۴۵ زبان کاربردی | فقط انگلیسی |
| هزینه | رایگان (فقط هزینه سختافزار) | ۰.۰۴۲ دلار به ازای هر میلیون توکن ورودی، خروجی رایگان |
محدودیتهای تولیدی Laya
تستهای مستقل توسط Flowtivity AI نشان میدهد که Laya یک موتور Zero-shot نیست. صحت Zero-shot آن در محک تصمیمات تایپشده تنها ۰.۳۶۲ است، به این معنی که استقرار در محیط تولید مستلزم یک مرحله تنظیم دقیق (Fine-tuning) محلی است. کارت مدل صراحتاً Laya را «پایهای سریع برای تخصصیسازی» مینامد، نه یک موتور تصمیمگیرنده Zero-shot.
الزامات سختافزاری نیز سختگیرانه است. در حالی که میزبانی Laya رایگان است، استنتاج روی CPU برای کارهای تعاملی عملاً غیرقابل استفاده است؛ تست روی یک VPS با ۴ هسته CPU، زمان پیشبینی گرم را ۴۹.۴ ثانیه نشان داد، در حالی که روی سختافزار GPU سالم این زمان بین ۱۹۳ تا ۴۶۴ میلیثانیه است. بنابراین، داشتن GPU برای محیط تولید یک الزام سخت است.
علاوه بر این، مدل در حالت پیشفرض بیش از حد مطمئن (Overconfident) است و با خطای کالیبراسیون مورد انتظار ۰.۴۶۶ عرضه میشود که تنها پس از تنظیم دما (Temperature refit) به ۰.۰۸۱ کاهش مییابد. مسائل دیگر شامل ابزار noul است که گاهی بهجای وضعیت زیربنایی، از برچسبهای گزینهها پیروی میکند (Issue #156 در گیتهاب) و امتیازدهی رتبهای که با ۰.۳۷۲ در SST-5 ضعیفترین ابزار است.
پیادهسازی در دنیای واقعی
برای تیمهای مهندسی، انتخاب به «شکل» وظیفه بستگی دارد. Laya برای موارد زیر ایدهآل است:
- فیلترهای ایمیل: دستیابی به صحت ۰.۹۹۳ در اسپمهای Enron و ۰.۹۸۰ در تشخیص فیشینگ.
- حفاظهای عامل (Guardrails): تشخیص جیلبریکها (Jailbreaks) و تزریق پرامپت (با امتیاز ۰.۷۵۵ تا ۰.۷۶۲) پیش از رسیدن ورودی به مدلهای بنیادی بزرگ.
- مسیریابی مدل: عمل بهعنوان اولین گیت ارزان برای ارسال پرسشهای ساده به مدل ۴۲۱ میلیونی و پرسشهای سخت به LLMهای بزرگتر.
- تریاژ پشتیبانی: مدیریت مجموعههای محدود از قصدها مانند استرداد وجه، قطعی سرویس و دسترسی به حساب.
در مقابل، Jev برای تصمیمات روی اسناد کامل یا تاکسونومیهای گسترده که هزینه یک تصمیم غلط بیشتر از هزینه یک ساعت GPU است، انتخاب امنتری است. Jev همچنین عملیات در سطح سازمانی ارائه میدهد: بدون نیاز به مدیریت GPU، همراه با SLA، محیط Sandbox و پذیرش اختصاصی.
چرخش اقتصادی و عملیاتی
این تفکیک معماری، مفروضات حوزه استنتاج را تغییر میدهد. با فاصله گرفتن از تولید خودبازگشتی برای تصمیمات ساده، توسعهدهندگان میتوانند هزینهها را بهشدت کاهش دهند. برای مثال، یک میلیارد توکن ورودی در Jev حدود ۴۲ دلار هزینه دارد، در حالی که هزینه Laya تنها به استهلاک سختافزار محدود میشود.
شواهد عملی در حال جمعآوری است. TechCrunch گزارش داد که مهندسان Vercel، مدل Jev را ۵ تا ۱۸ برابر سریعتر از GPT-5.6 Terra برای طبقهبندی ایمنی دستورات اندازهگیری کردهاند. همچنین مدیر فنی Bryo AI اشاره کرد که Gemini برای طبقهبندی ایمیل در همان سطح کیفی، ۱۰ تا ۲۰ برابر گرانتر است.
در حالی که جامعه در حال بررسی اجرای محلی است، یک دمو با استفاده از ONNX Runtime Web نشان میدهد Laya در تبهای مرورگر روی CPUهای دسکتاپ با سرعت ۰.۸ تا ۱.۳ ثانیه در هر فراخوانی اجرا میشود و دقت PyTorch را در ۱۴ پرسش تست حفظ میکند. برای کسانی که حریم خصوصی دادهها را اولویت میدانند، مسیر میزبانی شخصی امکان استقرار در محیطهای ایزوله و حذف دادههای حساس (Secret redaction) را فراهم میکند و ترافیک را از سرورهای خارجی دور نگه میدارد.
شکاف هوش و محکهای سطح سخت
در حالی که Laya در سرعت و هزینه پیروز است، شکاف هوشی در سناریوهای پیچیده آشکار میشود. یک پست وبلاگی در Hugging Face با استفاده از JevBench، «سطح سخت» تصمیمات را بررسی کرد. در این دسته، Jev امتیاز ۷۴.۱٪ را در برابر ۳۴.۱٪ Laya به دست آورد. امتیاز کلی هوش نیز بهشدت به نفع Jev بود (۸۵.۷ در برابر ۴۵.۸).
این شکاف دقیقاً جایی است که طول زمینه و تعداد گزینهها تعیینکننده میشوند. وقتی وظیفهای نیاز به تحلیل یک سند عظیم یا انتخاب از یک لیست طولانی از برچسبها دارد، Laya با ۴۲۱ میلیون پارامتر دچار مشکل میشود. معماری بسته Jev برای این محیطهای با پیچیدگی و زمینه بالا بهینه شده است.
نتیجهگیری
انتخاب نهایی به شکل وظیفه برمیگردد: کارهای محدود، با حجم بالا، ایزوله و چندزبانه به Laya میروند، در حالی که کارهای با زمینه طولانی، تاکسونومی گسترده و بدون نیاز به عملیات (Zero-ops) در Jev میمانند. همانطور که یک تحلیل بیان میکند: «Laya ارزانترین گیت اول در یک پشته تصمیمگیری است و Jev انتخابی امنتر است وقتی هزینه یک تصمیم غلط بیشتر از یک ساعت GPU باشد. اکثر تیمها در نهایت هر دو را اجرا میکنند: Laya برای ۹۰٪ حجم ترافیک ساده و Jev برای ۱۰٪ موارد پیچیده.»
چه API مدیریتشده Jev را انتخاب کنید و چه وزنهای باز Laya را، هدف یکی است: ماشینهایی که سریع پاسخ دهند و متوقف شوند. منتظر محکهای جامعه در سطح سخت JevBench باشید — جایی که Jev فعلاً با ۷۴.۱٪ در برابر ۳۴.۱٪ Laya پیشتاز است — تا ببینیم آیا تنظیم دقیق Laya میتواند شکاف استدلال در زمینههای طولانی را پر کند یا خیر.



گفتگو