اگر برای پیادهسازی هوش مصنوعی در سختافزارهای کوچک با تأخیر زیاد دستوپنجه نرم میکنید، مدلهای جدید Liquid AI قواعد بازی را تغییر میدهند. این مدلها ثابت کردند که برای تصمیمات سریع و دقیق، نیازی به غولهای چند ده میلیارد پارامتری نیست.
به نقل از گزارشهای منتشر شده، مدل d1-3B در محک Decision Index 0.2.1 امتیاز ۴۸.۵۷ را کسب کرد و از تمامی مدلهای ۴ و ۹ میلیارد پارامتری و حتی مدل Decider 35B-A3B با امتیاز ۴۷.۱۱ پیشی گرفت. این مدل که در سال ۲۰۲۶ عرضه شد، تمرکز را از تولید متن به تصمیمات ساختاریافته در یک گذر واحد تغییر داده است تا پاسخهای آنی روی سختافزارهای لبه (Edge Hardware) ممکن شود.
بیشتر مدلهای امروزی مولد هستند؛ یعنی مثل نویسندهای که کلمه به کلمه داستان میبافد و زمان و پردازش زیادی میبرد، توکن بعدی را پیشبینی میکنند. اما Liquid AI به دنبال نیاز متفاوتی است: طبقهبندی سریع و تصمیمگیری ساختاریافته. تصور کنید سیستمی که بهجای نوشتن یک پاراگراف درباره علت عصبانیت مشتری، فوراً تیکت را «فوری» برچسب میزند و به بخش «حسابداری» میفرستد.
زمینه و معماری
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی مدلهای کوچک اشاره کردیم، حذف لایههای اضافی تولید متن، راه را برای سرعت خیرهکننده باز میکند. طبق مستندات Liquid AI، این مدلها بر پایه مدلهای بنیادی لیکوئید (LFMs) ساخته شدهاند. برخلاف مدلهای زبانی بزرگ (LLM) — که شبیه کتابخانهداری است که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — مدلهای تصمیمگیرنده در یک گذر مستقیم (Single Forward Pass) و بدون تولید توکن، پاسخ میدهند.
این معماری منجر به کارایی فوقالعادهای شده است. خانواده d1 شامل دو نسخه با ساختارهای متفاوت است:
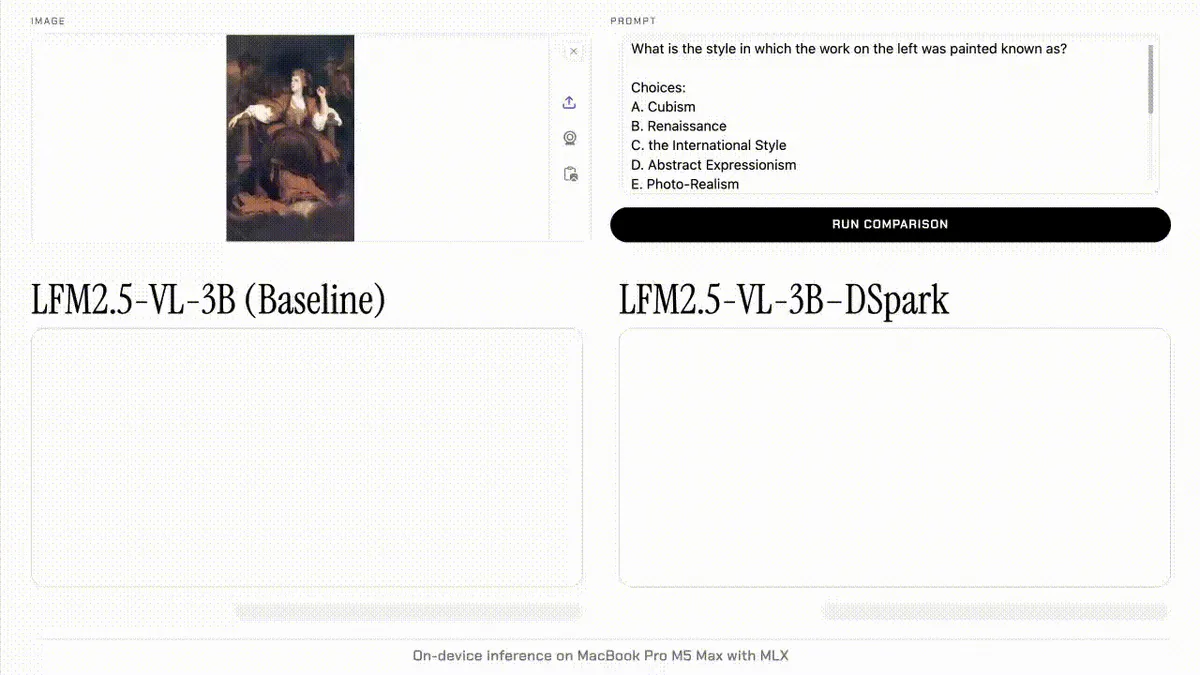
- d1-3B: یک مدل فقط-رمزگشا (Decoder-only) که از LFM2.5-VL-3B آموزش دیده است. LFM2.5-VL-3B جدیدترین مدل بینایی-زبانی (VLM) شرکت Liquid AI است. این مدل ورودیهای متنی و تصویری را میپذیرد. این پیشرفت در کنار بهینهسازیهای مدل DSpark برای افزایش سرعت تولید توکن در دستگاههای لبه، استقرار مدلهای چندوجهی را روی سختافزارهای محدود تسهیل میکند.
- d1-omni-600M: یک نسخه پژوهشی تجربی بر پایه LFM2.5-Encoder-350M است که یک رمزگشای دوطرفه (Bidirectional Encoder) محسوب میشود. این مدل با افزودن رمزگذارهای بینایی و صوتی، هر سه مودالیته را پشتیبانی میکند و میتواند ورودیهای «متن و تصویر» یا «متن و صوت» را بپذیرد.
جزئیات عملکرد و بنچمارکها
در بررسیهای متقابل روی هفت مجموعه داده عمومی — شامل درک مطلب، تشخیص سمّیت، طبقهبندی قصد (Intent Classification)، پرسشوپاسخ پزشکی و درک متنی چندزبانه — مدل d1-3B میانگین امتیاز ۸۲.۹ را به دست آورد و مدل Decider 4B را شکست داد. حتی مدل کوچکتر d1-omni-600M با امتیاز ۷۸.۴، مدل Decider 2B (با امتیاز ۷۷.۱) را پشت سر گذاشت، در حالی که تنها یکچهارم پارامترهای آن را دارد.
نتایج دقیق برای هر مجموعه داده به شرح زیر است:
- SQuAD 2.0: امتیاز ۸۳.۳ برای d1-3B در برابر ۷۶.۰ برای Decider 4B.
- BoolQ: امتیاز ۸۶.۳ برای d1-3B.
- PAWS-X: امتیاز ۷۶.۴ برای d1-3B، که بهطور قابلتوجهی بالاتر از امتیاز ۵۹.۵ مدل Decider 2B است.
- PubMedQA: امتیاز ۶۸.۳ برای d1-3B.
- Civil Comments: امتیاز ۹۵.۸ برای d1-omni-600M.
- XNLI: امتیاز ۸۵.۶ برای d1-3B.
- MASSIVE intent: امتیاز ۸۶.۹ برای d1-3B.
شرکت Liquid AI تأیید کرد که d1-3B قابلیتهای بینایی مدل پایه خود (LFM2.5-VL-3B) را حفظ کرده است. اگرچه d1-omni-600M هر سه مودالیته را مدیریت میکند، اما بنچمارکهای تصمیمگیری صوتی همچنان یک مسئله باز در این حوزه است و نسخه v0.3 از Decision Index در حال حاضر از یک بخش بینایی خصوصی استفاده میکند.
سرعت و استنتاج در لبه (Edge Inference)
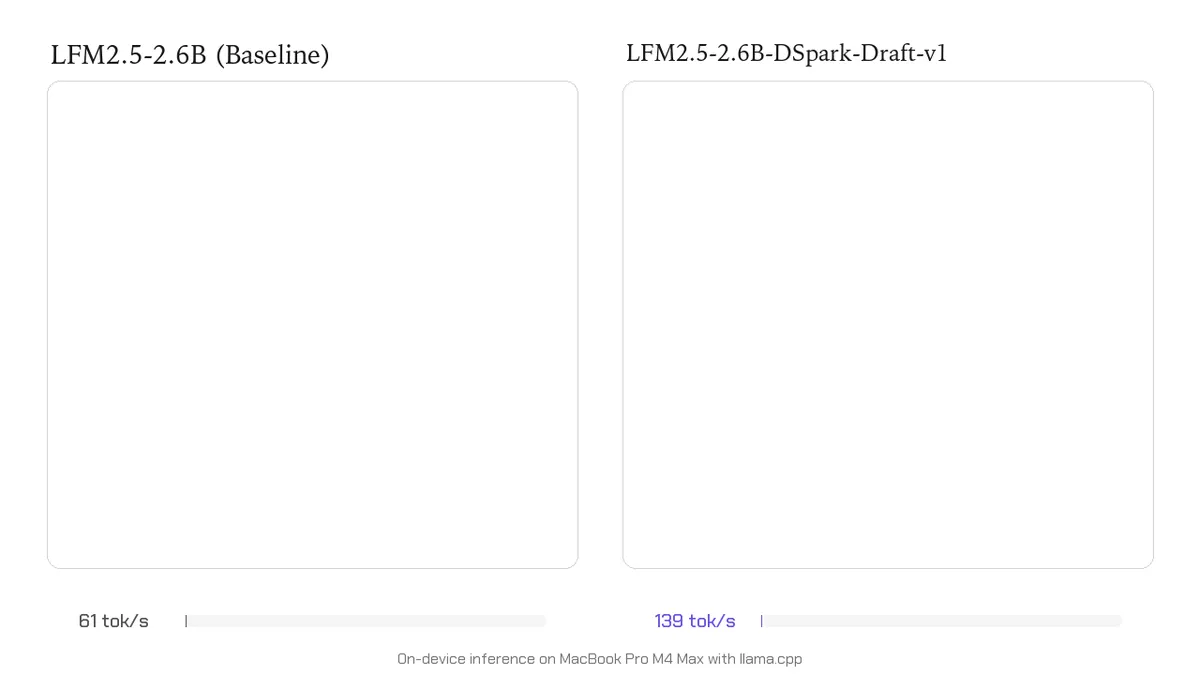
سرعت، مزیت اصلی برای استقرار در لبه است. در همکاری با NVIDIA، مدل d1-3B روی سختافزارهای مختلف تست شد و نتایج نشان میدهد که این مدل در هر دستگاه اندازهگیری شده، به یک سؤال در کمتر از ۵۰ میلیثانیه پاسخ میدهد:
- NVIDIA Jetson AGX Thor: ۱۶ میلیثانیه
- NVIDIA Jetson AGX Orin 64 GB: ۲۶ میلیثانیه
- NVIDIA Jetson Orin Nano: ۵۰ میلیثانیه
- Apple M5 Pro: ۳۰ میلیثانیه
روی پردازندههای گرافیکی ردهبالا، این اعداد حتی خیرهکنندهترند. در NVIDIA RTX 4090، پاسخ به یک سؤال تنها ۸ میلیثانیه و پردازش یک تصویر ۳۸۴ پیکسلی ۱۷ میلیثانیه زمان میبرد. در AMD MI325X، زمان پاسخدهی ۹ میلیثانیه و پردازش تصاویر ۱۸ میلیثانیه است.
این معماری در مقیاس بالا نیز بسیار بهینه است. برای مثال، پردازش سه سؤال روی AGX Thor تنها ۱.۳ برابر زمان پردازش یک سؤال را میگیرد (افزایش از ۱۶ به ۲۰ میلیثانیه). برای حالتهای بزرگتر، AGX Thor یک وضعیت با ۳.۴ هزار توکن را در ۲۲۰ میلیثانیه پردازش میکند و میتواند ۶۴ وضعیت بستهبندی شده را با نرخ ۲۶۲ مورد در ثانیه مدیریت کند.
این تغییر به سمت مدلهای «فقط-تصمیمگیرنده»، این فرض را که برای طبقهبندیهای ساده به ظرفیتهای عظیم مولد نیاز داریم، تغییر میدهد. Liquid AI با حذف لایه تولید توکن، ابزاری ساخته است که برای رباتیک در زمان واقعی (Real-time Robotics) و تریاژ روی دستگاه، جایی که تأخیر (Latency) یک عامل تعیینکننده است، کاملاً کاربردی است.
برای توسعهدهندگان، این به معنای امکان اجرای منطق تصمیمگیری چندوجهی — یعنی درک همزمان متن و تصویر — مستقیماً روی یک Jetson Nano بدون نیاز به APIهای ابری است. این تحول، «هوش» سیستم را از یک رابط گفتگوی کند به یک ماشه واکنشگرای سریع تبدیل کرده است.
کاربران اکنون میتوانند به وزنهای باز (Open Weights) هر دو مدل در Hugging Face دسترسی داشته باشند. برای پیادهسازی، توسعهدهندگان به نسخه transformers>=5.14 نیاز دارند و باید گزینه trust_remote_code=True را برای بارگذاری منطق سفارشی مدل فعال کنند. این مدلها از پرسوجوهای ساختاریافته پیچیده، مانند امتیازدهی به فوریت یا طبقهبندی مسائل فنی در مقابل مسائل حسابداری، در یک گذر واحد پشتیبانی میکنند.
گام بعدی شما
- اگر روی رباتیک یا سیستمهای تریاژ آنی کار میکنید، مدل d1-3B را جایگزین مدلهای مولد سنگین کنید.
- برای اجرا، کتابخانه
transformersرا به نسخه ۵.۱۴ یا بالاتر بهروزرسانی کرده وtrust_remote_code=Trueرا فعال کنید. - قابلیتهای طبقهبندی چندوجهی مدل را در محیطهای بدون دسترسی به اینترنت (Offline) تست کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو