اگر از مدلهای چندوجهی برای استنتاج محلی استفاده میکنید، احتمالاً با نتایجی مواجه شدهاید که گاهی بدون دلیل منطقی، نامفهوم یا متناقض هستند. این «ناپایداری» احتمالاً نتیجه یک خطای مهندسی در مدیریت حافظه است، نه ضعف در منطق مدل.
طبق گزارشهای فنی، یک نقص بحرانی در لاماسیپلاسپلاس (llama.cpp) شناسایی شده است که اجازه میدهد این کتابخانه هنگام پردازش بردار معنایی (Embedding) از نوع M-RoPE، فراتر از بافر موقعیت (position buffer) خود بخواند. این باگ باعث تخریب خاموش دادهها میشود؛ یعنی مدل بدون اینکه متوقف شود یا کرش کند، بر اساس بایتهای تصادفی موجود در حافظه (heap memory)، نتایجی متناقض تولید میکند.
این مشکل بهطور خاص مدلهایی را تحت تأثیر قرار میدهد که از رمزگذاری موقعیت چرخشی چندوجهی (M-RoPE) استفاده میکنند، از جمله Qwen2.5-VL و Qwen2.5-Omni. در دنیای استنتاج محلی، تراز حافظه (memory alignment) حیاتی است؛ وقتی یک کتابخانه خارج از مرزهای تخصیصشده میخواند، همیشه سیستم کرش نمیکند، بلکه دادههای مجاور را بهعنوان ورودی معتبر میپذیرد و همین موضوع باعث رفتارهای پیشبینیناپذیر مدل میشود. برای بهینهسازی این فرآیندها در محیطهای محلی، تنظیمات دقیق ابزارهایی مانند اولاما نقش مهمی در پایداری و سرعت استنتاج ایفا میکنند.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی حافظه در مدلهای بازمتن اشاره کردیم، هرگونه ناهماهنگی در لایههای پاییندستی C++ میتواند اثرات فاجعهباری بر لایههای بالای مدل داشته باشد.
شکاف در مستندات: ریشه خطا
به نقل از تحلیلهای منتشر شده در dev.to، ریشه این باگ در تضاد موجود در فایل include/llama.h است. این فایل حاوی دو دستورالعمل خاص است که توسعهدهندگان را به گمراهی میکشاند:
- خط ۲۴۸ بیان میکند: «آرایههای ارائهشده (مانند توکن، بردار معنایی و موقعیت) باید دارای اندازه n_tokens باشند».
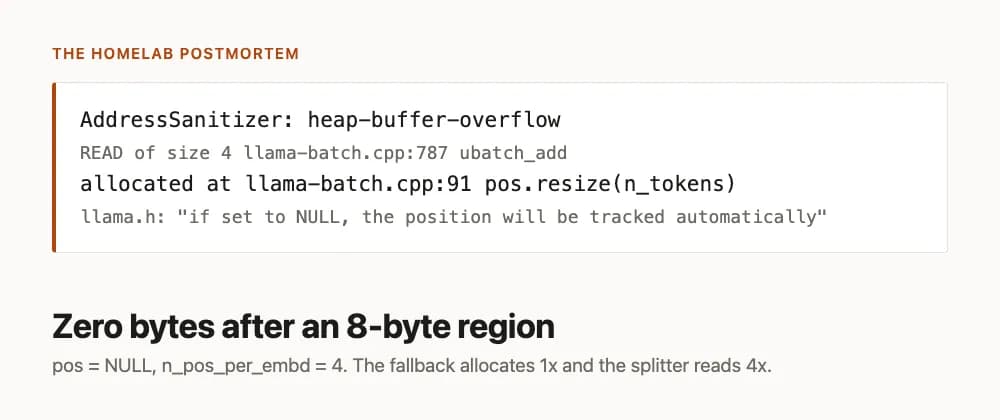
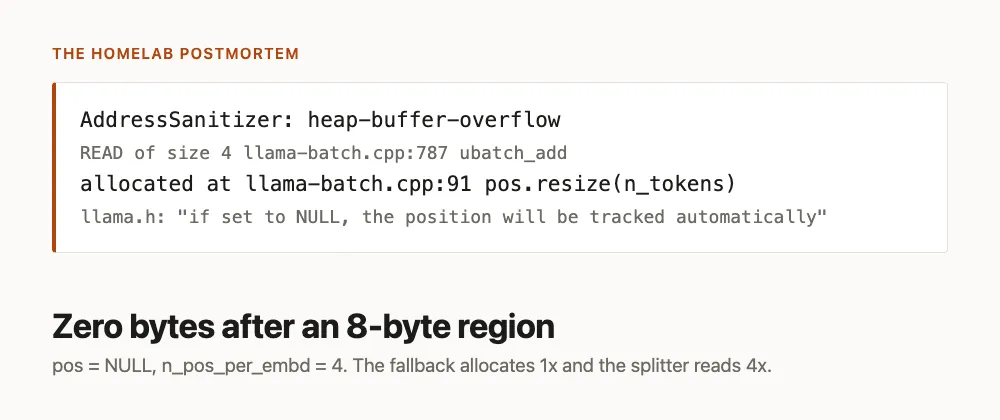
- خط ۲۵۳ اشاره میکند که اگر آرایه موقعیت (pos) برابر NULL باشد، «موقعیت توکن بهطور خودکار ردیابی میشود».
برای مدلهای استاندارد، این دستورات درست هستند. اما برای مدلهای M-RoPE، منطق داخلی سیستم به بافری بزرگتر از آنچه در هدر فایل ذکر شده نیاز دارد. این وضعیت یک تله ایجاد میکند: چه توسعهدهنده طبق مستندات عمل کرده و حافظه را به اندازه n_tokens تخصیص دهد و چه به مسیر خودکار NULL تکیه کند، در هر دو حالت خطای «بیشخوانی حافظه» (memory overread) فعال میشود.
سازوکار سرریز حافظه
طبق تحلیلهای فنی، این باگ از تضاد بین مستندات کتابخانه و پیادهسازی واقعی آن ناشی میشود. همانطور که ذکر شد، فایل include/llama.h تصریح میکند که آرایه موقعیت باید اندازه n_tokens داشته باشد.
با این حال، در مدلهای M-RoPE، سیستم برای هر بردار معنایی به چندین موقعیت نیاز دارد. بهطور مشخص، مقدار n_pos_per_embd برای این خانواده از مدلها برابر ۴ است. حلقه تقسیم دستهها (batch splitter loop) در فایل src/llama-batch.cpp (خطوط ۷۸۰ تا ۷۸۷) برای هر بخش RoPE، یک موقعیت را میخواند.
وقتی کد یک دسته از بردارهای معنایی را پردازش میکند (جایی که batch.token == NULL است)، حلقهای را اجرا میکند که مقادیر batch.pos[0 … 4 * n_tokens − 1] را میخواند. اما اگر از مسیر خودکار استفاده شده باشد، خط ۹۱ در فایل src/llama-batch.cpp تنها بردار را تا اندازه batch.n_tokens تغییر سایز داده است. در نتیجه، حلقه بسیار فراتر از انتهای بردار تخصیصیافته پیش میرود و دادههای نامرتبط را میخواند.
شواهد و شناسایی
این باگ بهدلیل اینکه در نسخههای نهایی (release builds) باعث کرش نمیشود، پنهان مانده بود، زیرا خواندنهای سرریز در heap-buffer معمولاً منجر به توقف فوری برنامه نمیشوند. شناسایی آن تنها از طریق دادههای میدانی و تستهای سختگیرانه ممکن شد:
- گزارش میدانی: کاربری که Qwen2.5-Omni را روی Metal اجرا میکرد، گزارش داد که برای یک پیشپُرکردن (prefill) صوتی با ۷۵۰ توکن، سیستم تنها ۳۰۰۰ بایت تخصیص یافته اما سعی در خواندن ۱۲۰۰۰ بایت داشته است.
- نشانه: خروجیها بهصورت متناوب نامفهوم بودند. نرخ خطا بسته به سایر پردازشهای فعال در سیستم تغییر میکرد؛ این یک نشانه کلاسیک از خواندن حافظه heap است، جایی که بایتهای اضافی به آنچه در حافظه مجاور قرار دارد بستگی دارد.
- تأیید: پژوهشگران با استفاده از ابزار AddressSanitizer (ASan)، یک خطای
heap-buffer-overflowدر حالت READ به اندازه ۴ بایت را در خط ۷۸۷ فایلllama-batch.cppبازتولید کردند.
در یک مورد آزمایشی با دسته دو توکنی (n_tokens = 2)، تخصیص حافظه تنها ۸ بایت بود. ردپای ASan نشان داد که سرریز در pos[2] رخ داده است که دقیقاً شروع دومین بخش M-RoPE است. این ردپا بهطور مشخص سرریز را به عنوان ۰ بایت بعد از یک ناحیه ۸ بایتی که در خط ۹۱ فایل llama-batch.cpp تخصیص یافته بود، شناسایی کرد.
اصلاحیه و پیامدهای API
یک درخواست تغییر (Pull Request #28910) برای رفع این مشکل ارسال شده است. راهکار شامل تغییر سایز بردار جایگزین به n_tokens * n_pos_per_embd و پخش موقعیتهای تولیدشده در بخشهای مورد نیاز است. این اصلاحیه با یک تست ۲۴ خطی در tests/test-batch-alloc.cpp با استفاده از یک واژگان (vocab) ساختگی با n_pos_per_embd = 4 روی مک مینی (Apple clang 21, master 4c9233c) تأیید شده است.
نکته قابل تأمل این است که این اصلاح بهطور کامل خودکار نیست. در حالی که مسیر داخلی NULL تعمیر شده، مستندات کتابخانه اکنون صرفاً به توسعهدهندگان هشدار میدهد که باید بهصورت دستی n_tokens * n_pos_per_embd موقعیت را برای مدلهای M-RoPE در بخشهای متوالی تخصیص دهند. این یعنی مسئولیت تخصیص صحیح حافظه اکنون بر عهده توسعهدهنده API است. تابع llama_batch_init() همچنان pos را بر اساس n_tokens تخصیص میدهد؛ بنابراین سرریز در سمت فراخوان (caller-side) از طریق بهروزرسانی مستندات بسته شده است، نه از طریق تغییر منطق تخصیص کتابخانه.
تحلیل فنی
این حادثه خطری تکرارشونده در محیطهای اجرای AI مبتنی بر C++ را برجسته میکند: شکاف بین انتظارات مستند شده در API و محدودههای واقعی حلقههای داخلی. چون این بیشخوانی منجر به خطای Segmentation Fault نشد، باگ از چرخههای تست استاندارد عبور کرد. در یک نسخه نهایی، چندین هزار بایت بعدی حافظه heap بهعنوان موقعیتهای RoPE در نظر گرفته شده و مدل محاسبات توجه (Attention) را بر اساس آنها انجام میدهد.
برای حوزه استنتاج محلی، این موضوع ضرورت ادغام ابزارهایی مانند ASan در خط لوله CI/CD را برای هر کتابخانهای که اشکال پیچیده تنسور (tensor shapes) را مدیریت میکند، دوچندان میکند. تکیه بر این فرض که «برنامه کرش نمیکند»، معیار ناکافی برای صحت عملکرد در معماریهای چندوجهی است که چیدمان حافظه در آنها غیرخطی است. این نوع خطاهای پنهان، نمونهای از چالشهای رایج مدلهای زبانی در محیط عملیاتی هستند که شناسایی آنها نیازمند ابزارهای مانیتورینگ پیشرفته است.
گام بعدی شما
اگر در حال حاضر بردارهای معنایی را از طریق API دستهای به یک مدل M-RoPE ارسال میکنید، باید اقدامات زیر را انجام دهید:
- تخصیص دستی: بههیچوجه به مسیر NULL یا اندازه
n_tokensتکیه نکنید. بافر موقعیت خود را بهصورت دستی به اندازهn_tokens * 4تخصیص دهید و چهار صفحه (plane) را پر کنید، مشابه پیادهسازی موجود درtools/mtmd/mtmd-helper-common.h. - تأیید: برای بررسی تأثیرپذیری نسخه خود، تکه کد تست PR را اعمال کرده،
test-batch-allocرا با فعال کردن-DLLAMA_SANITIZE_ADDRESS=ONبیلد کرده و اجرا کنید. این کار به مدل یا GPU نیاز ندارد و کمتر از یک دقیقه زمان میبرد. - عادت به بازبینی کد: هرگاه یک فایل هدر اندازه خاصی برای یک آرایه ذکر کرد، همیشه حلقهای را که آن آرایه را میخواند پیدا کرده و محدودهها را با همان عبارت تطبیق دهید. در این مورد، محدودهها در فایلهایی بودند که صدها خط با هم فاصله داشتند و همین موضوع باعث شد تضاد را بهراحتی نادیده بگیرند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو