اگر برای اتوماسیون سیستمهای خود به خروجیهای ساختاریافته (Structured Output) تکیه میکنید، احتمالاً در حال دریافت دادههایی هستید که هیچ تضمینی برای صحت ساختاریشان وجود ندارد. تحلیل فنی منتشر شده در ۱۱ سپتامبر ۲۰۲۶ نشان میدهد که فرمت مستند شدهی json_schema در llama-server در واقع خروجی هوش مصنوعی را محدود نمیکند. این تحلیل فاش میکند که سرور بهطور خاموش این ویژگی تبلیغشده را نادیده میگیرد و علیرغم عدم اعمال محدودیتهای گرامری، یک پاسخ استاندارد HTTP 200 برمیگرداند. این وضعیت باعث میشود توسعهدهندگان تصور کنند خروجیهای آنها ساختاریافته است، در حالی که در واقعیت در حال دریافت متن عادی (Raw Prose) هستند.
این نقص در زمانی رخ میدهد که خروجیهای ساختاریافته، ستون فقرات قابلیت اطمینان در عاملهای هوش مصنوعی (AI Agents) — سیستمهایی که مثل یک کارمند دیجیتال، وظایف پیچیده را بهصورت مرحلهبهمرحله اجرا میکنند — هستند. برای توسعهدهندگانی که خطوط لول تولیدی (Production Pipelines) میسازند، مدلی که گاهی یک جمله محاورهای یا یک ویرگول اضافی به انتهای یک شیء JSON اضافه کند، میتواند باعث کرش کردن سیستمهای پاییندستی شود. طبق گزارش dev.to، خطر اصلی در «نامرئی بودن» این شکست است؛ سرور هیچ خطایی نمیدهد و چون مدلهای قدرتمند معمولاً بهطور طبیعی متنی شبیه JSON تولید میکنند، این واقعیت که محدودیت سختگیرانه (Hard Constraint) غایب است، ماسک میشود و توسعهدهنده تصور میکند مدل در حال «حدس زدن» فرمت است. این مسئله یادآور چالشهای مشابهی است که در آن کدهای وضعیت HTTP 200 باعث کور شدن سامانههای نظارتی هوش مصنوعی میشوند و خطاهای سیستمی را پنهان میکنند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت و پایداری مدلهای بازمتن اشاره کردیم، تفاوت بین «به نظر رسیدن» و «تضمین شدن» در محیطهای عملیاتی حیاتی است.
سازوکار شکست
این باگ در تجزیکننده درخواستها (Request Parser) در فایل tools/server/server-common.cpp نهفته است. بر اساس مستندات فنی، این تجزیکننده با دو فرمت json_object و json_schema متفاوت برخورد میکند. در حالی که شاخه json_object بهدرستی طرحواره (Schema) را میخواند، شاخه json_schema بهطور خاص بهدنبال یک پوشش (Wrapper) تودرتو به نام json_schema میگردد.
در کد مربوط به بیلد b10868، منطق به این شکل تقسیم شده است:
- شاخه json_object: مستقیماً
response_format.schemaرا میخواند. - شاخه json_schema: فقط
response_format.json_schema.schemaرا میخواند و هیچ چیز دیگری را نمیپذیرد.
اگر کاربر طبق مثالهای موجود در README درخواست را به صورت {"type":"json_schema","schema":{...}} ارسال کند، تجزیکننده هیچ پوشش تودرتویی پیدا نمیکند. در این حالت، schema_wrapper به صورت پیشفرض به یک شیء خالی {} تبدیل میشود و متعاقباً json_schema نیز به {} تغییر مییابد. از آنجایی که نوع درخواست (Request Type) شناسایی شده است، سرور بدون اعمال هیچگونه گرامری به تولید متن ادامه میدهد و در عمل با درخواست مانند یک پرامپت متنی ساده برخورد میکند.
شواهد و آزمایشها
برای اثبات این شکست، آزمایشی روی بیلد b10868 (کامیت 304665fe، منتشر شده در ۹ سپتامبر ۲۰۲۶) در محیط دبیان ۱۳ با یک سیستم فقط CPU انجام شد. مدل مورد استفاده gemma-3-1b-it-Q4_K_M بود که بهدلیل اندازه کوچک، اجازه میداد کل آزمایش در حدود یک دقیقه اجرا شود.
در این آزمایش از یک پرامپت ثابت («2+2 چند میشود؟ استدلال خود را در چند جمله توضیح دهید.»)، دمای (Temperature) ۰ و سید (Seed) ۴۲ استفاده شد. این پرامپت بهطور خاص انتخاب شد تا اگر هیچ محدودیتی وجود نداشت، حتماً پاسخ متنی (Prose) تولید کند. طرحواره مورد استفاده نیز بسیار سختگیرانه بود: {"type":"object","properties":{"answer":{"type":"integer"}}, "required":["answer"],"additionalProperties":false}.
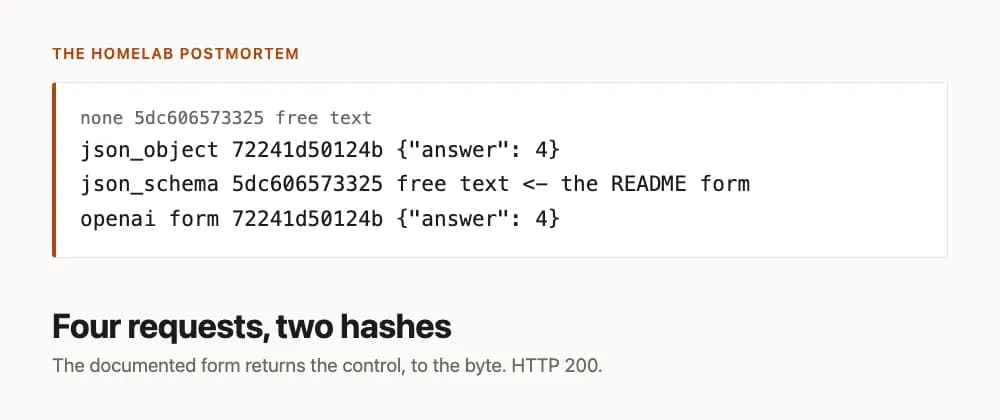
نتایج با مقایسه هشهای SHA-256 بهشدت تکاندهنده بود:
- بدون فرمت پاسخ (No response_format): متن عادی تولید کرد (هش: 5dc606573325). خروجی با این جمله شروع شد: «2 + 2 equals 4. This is a fundamental mathematical concept...»
- فرمت README (json_schema): دقیقاً همان متن عادی را تا آخرین بایت تولید کرد (هش: 5dc606573325).
- فرمت json_object: خروجی صحیح JSON تولید کرد:
{"answer": 4}(هش: 72241d50124b). - پوشش سبک OpenAI: خروجی صحیح JSON تولید کرد:
{"answer": 4}(هش: 72241d50124b).
تمام این درخواستها وضعیت HTTP 200 را برگرداندند. لاگهای سرور تنها سه تاییهای معمولی launch_slot_ ،print_timing و release را نشان میدادند. هیچ هشدار یا اخطاری مبنی بر خالی بودن طرحوارهها یا نبود گرامرها ثبت نشد.

تاریخچه «اصلاحات کاذب»
بسیاری از توسعهدهندگان به اصلاحیه مارس ۲۰۲۵ (شماره #12168) به عنوان راه حل مشکلات خروجی ساختاریافته اشاره میکردند. این اصلاحیه در پاسخ به ایشو #10732 در دسامبر ۲۰۲۴ بود که در آن کاربران گزارش داده بودند سرور برای json_object خروجی ساختاریافته میدهد اما برای json_schema خیر. وقتی #12168 ادغام شد، یک گزارشدهنده تأیید کرد که مشکل در بیلد b4820 برطرف شده است و بسیاری تصور کردند داستان به پایان رسیده است.
با این حال، بررسی دقیق تغییرات (Diff) نشان میدهد که اصلاحیه سال ۲۰۲۵ تنها یک متغیر سایهانداز (Shadowed Variable) را در منطق پوشش تودرتو برطرف کرده بود. کد اصلی خطی داشت به صورت json json_schema = json_value(...) در بلوکی که json_schema قبلاً در خارج از آن تعریف شده بود. اصلاحیه تنها این متغیر را از حالت سایه خارج کرد تا فرم تودرتو کار کند. این تغییر هرگز به فرم طرحواره سطح اول (Top-level) که در README نمایش داده شده بود، دست نزد.
در واقع، مثال مستند شده در README برای ۱۸ ماه گذشته خراب بوده است. در زمان ادغام #12168، خط ۱۰۷۶ فایل examples/server/README.md ادعا میکرد که فرم {"type": "json_schema", "schema": {...}} پشتیبانی میشود. همین جمله امروز در خط ۱۳۱۶ فایل tools/server/README.md باقی مانده است. این خطا به این دلیل زنده ماند که اکثر کتابخانههای کلاینت از شکل تودرتوی سازگار با OpenAI استفاده میکنند؛ به این معنی که تنها توسعهدهندگانی که درخواستها را بهصورت دستی و با دنبال کردن مستندات رسمی مینوشتند، با این دیوار برخورد میکردند. این نوع از خطاهای پنهان در پارسرها مشابه مواردی است که در پارسرهای اصلاحشده در برابر قراردادهای پیچیده برای جلوگیری از فساد داده بررسی شده بود.
روش تأیید در بیلد شما
توسعهدهندگان میتوانند با مقایسه هش SHA-256 یک درخواست تهی (Null Request) و یک درخواست با json_schema متوجه شوند که آیا بیلد فعلی آنها آسیب دیده است یا خیر. اگر هشها یکسان باشند، یعنی محدودیت اعمال نمیشود.
یک تست ساده پایتون را میتوان روی هر llama-server با استفاده از urllib.request و hashlib اجرا کرد. با ارسال یک پرامپت یکسان با و بدون response_format ،میتوانید ببینید آیا خروجی تغییر میکند یا خیر. اگر فرمی با طرحواره، همان هش درخواست تهی را داشته باشد، آن فرم در بیلد شما اجرا نمیشود.
یک اسکریپت تست شده و آماده اجرا برای این بررسی در ابزارهای نویسنده با نام check-llama-response-format.sh موجود است. این اسکریپت ابتدا کنترل (درخواست تهی) را بررسی میکند تا مطمئن شود مدلی که اتفاقی بدون دستور هم به صورت JSON پاسخ میدهد، نتواند یک «پاس» جعلی ایجاد کند.
راهکارهای پیشنهادی
تا زمانی که Pull Request شماره #28697 ادغام شود — که یک سیستم جایگزین (Fallback) به response_format.schema در صورت نبود پوشش اضافه میکند — کاربران باید از مثال json_schema در README دوری کنند. یک بیلد از شاخه این PR (کد 48f9bfd) تأیید میکند که فرم README در آن حالت بهدرستی به هش 72241d50124b تبدیل میشود.
به جای آن، از یکی از این دو فرمت تأیید شده استفاده کنید:
- طرحواره ساده:
{"type": "json_object", "schema": { ... }} - پوشش OpenAI:
{"type": "json_schema", "json_schema": {"name": "x", "schema": { ... }}}
عادت تعمیمپذیر
این شکست دو درس حیاتی برای زیرساختهای هوش مصنوعی دارد. اول، درس محدود: اصلاح یک فرم مشابه، به معنای اصلاح فرم شما نیست. وقتی یک ایشوی بسته شده به نظر میرسد مورد شما را پوشش میدهد، Diff آن را بخوانید. اگر شکل دقیق ورودی شما در Diff نیست، آن ایشو درباره چیز دیگری بوده که اتفاقاً عنوان مشابهی داشته است.
دوم، درس گستردهتر درباره این است که «کار کرد» واقعاً به چه معناست. یک پاسخ ساختاریافته از مدل میتواند به این معنا باشد که سرور خروجی را محدود کرده است، یا میتواند به این معنا باشد که مدل بهطور بدون محدودیت آن را تولید کرده چون شما محترمانه درخواست کردید. از بیرون، اینها بایتهای یکسانی هستند. تنها راه تشخیص آنها این است که پرامپت را ثابت نگه دارید و محدودیت را حذف کنید: اگر خروجی تغییر نکرد، هیچ محدودیتی وجود نداشته است.
این دقیقاً همان منطقی است که در مورد یک آداپتور (Adapter) که توسط سیستم پذیرفته شده اما روی صفر لایه اعمال شده است، صدق میکند؛ سیستم موفقیت را گزارش میدهد، خروجی درست به نظر میرسد، اما مکانیسم لازم هرگز فعال نشده است. برای کسانی که استکهای LLM محلی را مدیریت میکنند، این یادآوری است که «به نظر رسیدنِ درست» دلیلی بر وجود محدودیت نیست. تنها تضمین، یک محدودیت گرامری تأیید شده است که مدل را مجبور به پیروی میکند. این رویکرد برای تضمین پایداری در محیطهای عملیاتی مشابه معماریهای جدید انتقال داده برای جلوگیری از شکستهای غیرقطعی در استریمینگ JSON است.
گام بعدی شما
- از ارسال درخواستها با فرمت
json_schemaطبق مثال README خودداری کنید. - برای تضمین خروجی، از فرمت
{"type": "json_object", "schema": { ... }}استفاده کنید. - اگر از ساختار OpenAI استفاده میکنید، حتماً لایه
json_schemaرا به عنوان پوشش (Wrapper) اضافه کنید.
اما این نقص فنی تنها بخشی از چالشهای استقرار مدلهای محلی است؛ برای درک بهتر مدیریت حافظه در مقیاس بالا، تحلیل ما دربارهی KV Cache را بخوانید.



گفتگو