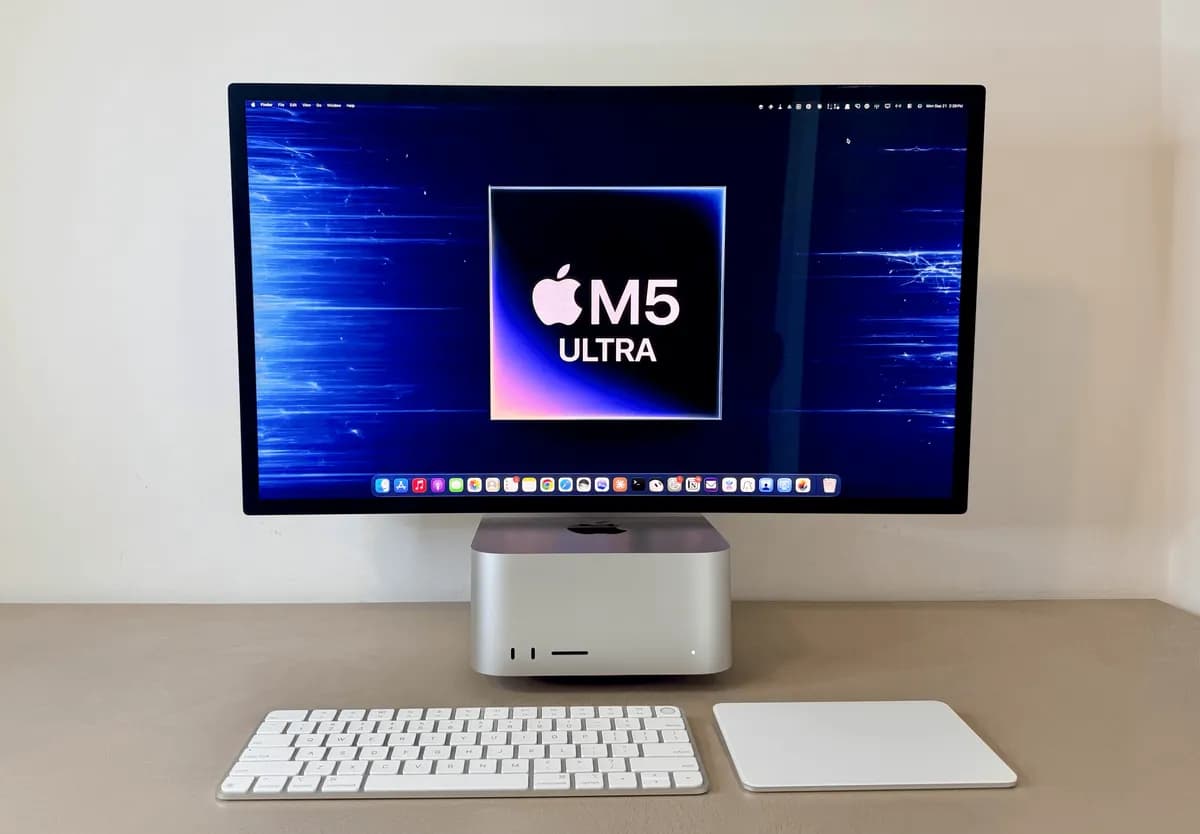
اگر امروز برای اجرای مدلهای زبانی هزینه اشتراک ماهانه میپردازید، سختافزار جدید اپل میتواند این صورتحساب را به صفر برساند. یک دستگاه مک استودیو M5 Ultra با ۲۵۶ گیگابایت رم، اکنون میتواند پرامپتهای هوش مصنوعی را ۱۵۰٪ سریعتر از نسل قبلی پردازش کند و عملاً زمان انتظار برای پاسخهای عاملهای محلی (Local Agents) را حذف کند. این تغییر به کاربران اجازه میدهد تا دستیارهای شخصی پیچیده را بهطور کامل روی دستگاه خود اجرا کنند و هزینههای ابری و نگرانیهای مربوط به حریم خصوصی را دور بزنند. برای نویسنده، این ماشین به یک «ماشین رؤیایی» برای عاملهای هوش مصنوعی محلی تبدیل شده است که اجرای دستیاران شخصی با عملکرد عالی و بدون هزینههای اضافی ابری را ممکن میسازد. اگر تا به حال در تست OpenClaw یا Hermes Agent با مدلهای محلی تردید داشتید، چون فکر میکردید هرگز به هوشمندی و سرعت مدلهای ابری نزدیک نمیشوند، این مک نظر شما را تغییر خواهد داد.
این جهش سختافزاری در حالی رخ میدهد که صنعت با هزینههای سرسامآور گردشهای کاری «همیشه روشن» (Always-on) دستوپنجه نرم میکند. در حالی که مدلهای پیشرو در ابر همچنان هوشمندتر هستند، فشار مالی ناشی از پردازشهای پسزمینه — مثل تحلیل ۲۴ ساعته اسناد — کاربران حرفهای را به سمت میزبانی شخصی (Self-hosting) سوق داده است. نویسنده که بیش از یک سال است با مدلهای محلی کار میکند، اشاره میکند که اگرچه برخی از هوش مصنوعی محلی برای حریم خصوصی یا صرفاً به دلیل «جالب بودن» استفاده میکنند، اما کاربرد عملی برای حجم بالای کار، محرک واقعی این تغییر است.
همانطور که در تحلیل قبلی ما دربارهی اینکه چگونه مسیریابهای شغلی (Job Routers) از نشت اسرار عاملهای محلی جلوگیری میکنند اشاره کردیم، تمرکز توسعهدهندگان اکنون از بحثهای امنیتی به سمت عملکرد خام جابهجا شده است. برای کاربر معمولی، این یعنی تفاوت بین ۱۰ ثانیه انتظار برای یک پاسخ و دریافت آن بهصورت آنی. تصور کنید یک دستیار پژوهشی که ۳۰۰ فایل PDF را میخواند و آنها را در لحظه سازماندهی میکند، بدون اینکه حتی یک بایت داده از دستگاه شما خارج شود و به سرورهای شرکتی ارسال گردد.
به نقل از گزارش MacStories در ۲۱ سپتامبر ۲۰۲۶، مدل M5 Ultra از یک معماری چهار-تراشهای (Quad-die) پیشگام استفاده میکند. این ساختار از طریق فناوری UltraFusion ایجاد شده که دو تراشه M5 Max را به هم متصل میکند تا برای نخستین بار در اکوسیستم اپل، یک معماری چهار-تراشهای شکل بگیرد. اگرچه ظاهر دستگاه با مدل M3 Ultra یکسان است، اما سیلیکون داخلی آن بنیاداً متفاوت است.
دو ارتقای سختافزاری کلیدی، موتور محرک این عملکرد هستند:
- محاسبات GPU: پردازنده گرافیکی ۸۰ هستهای نسل جدید در هر هسته خود دارای شتابدهندههای عصبی (Neural Accelerators) است که تا ۴.۵ برابر محاسبات هوش مصنوعی M3 Ultra را افزایش میدهد.
- پهنای باند حافظه: پهنای باند از ۸۱۹ گیگابایت بر ثانیه به ۱.۲ ترابایت بر ثانیه رسیده است؛ جهشی ۵۰ درصدی که مستقیماً سرعت تولید توکن (Token) — تکههای کوچکی از متن که مدل تکهتکه میخورد — را بالا میبرد. این بهبود در پهنای باند، همان عاملی است که در تحلیل مقایسهای عملکرد M5 Ultra در برابر انویدیا به عنوان نقطه قوت اصلی برای استنتاج مدلهای محلی مورد بررسی قرار گرفت.
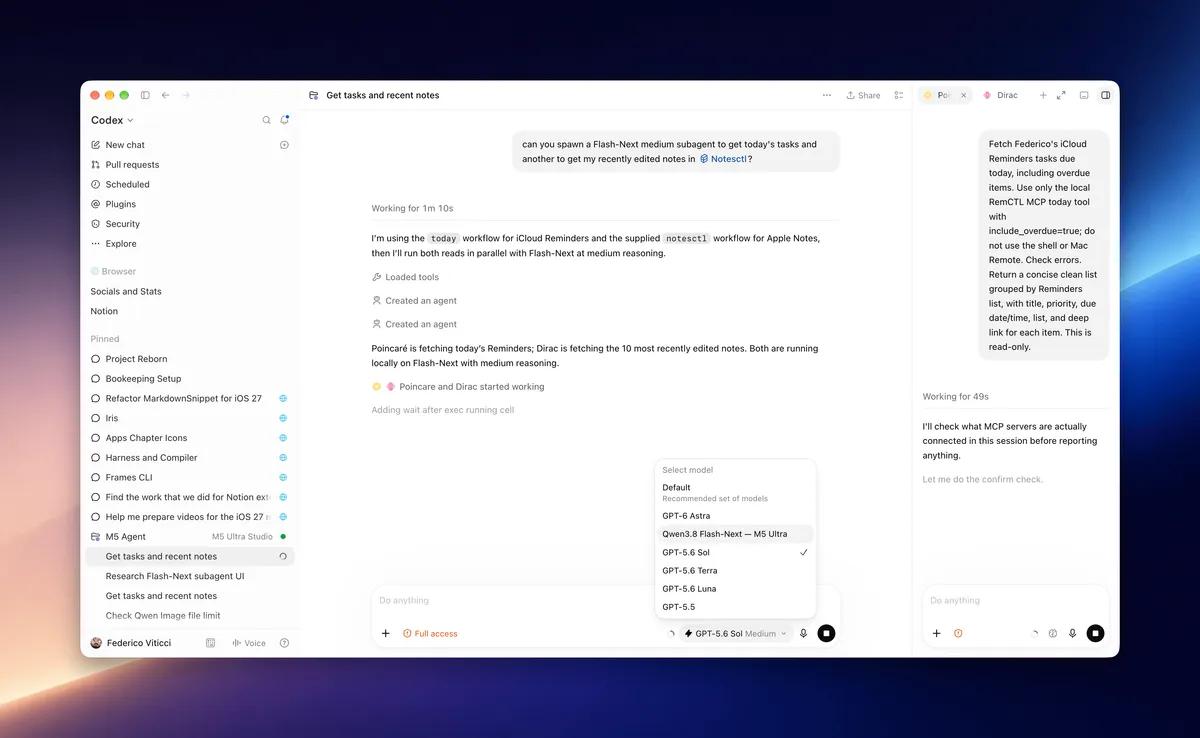
در تستهای عملی با مدل Qwen3.8-Flash-Next، مدل M5 Ultra بهطور متوسط ۷۰٪ سریعتر از M3 Ultra عمل کرد. در پرامپتهای کوتاه، سرعت مدل به ۱۰۰ توکن در ثانیه رسید. حتی با پنجرههای متنی (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد — بسیار بزرگ (۶۴ تا ۲۵۶ هزار توکن)، خروجی دستگاه بین ۶۰ تا ۸۵ توکن در ثانیه باقی ماند. این پایداری برای «حلقههای عاملمحور» (Agentic Loops) حیاتی است؛ جایی که مدل باید استدلال کند، ابزارها را فراخوانی کند و چندین بار تکرار کند تا تکلیف را به پایان برساند، بدون اینکه با رشد طول جلسه، سرعت آن به شدت افت کند.
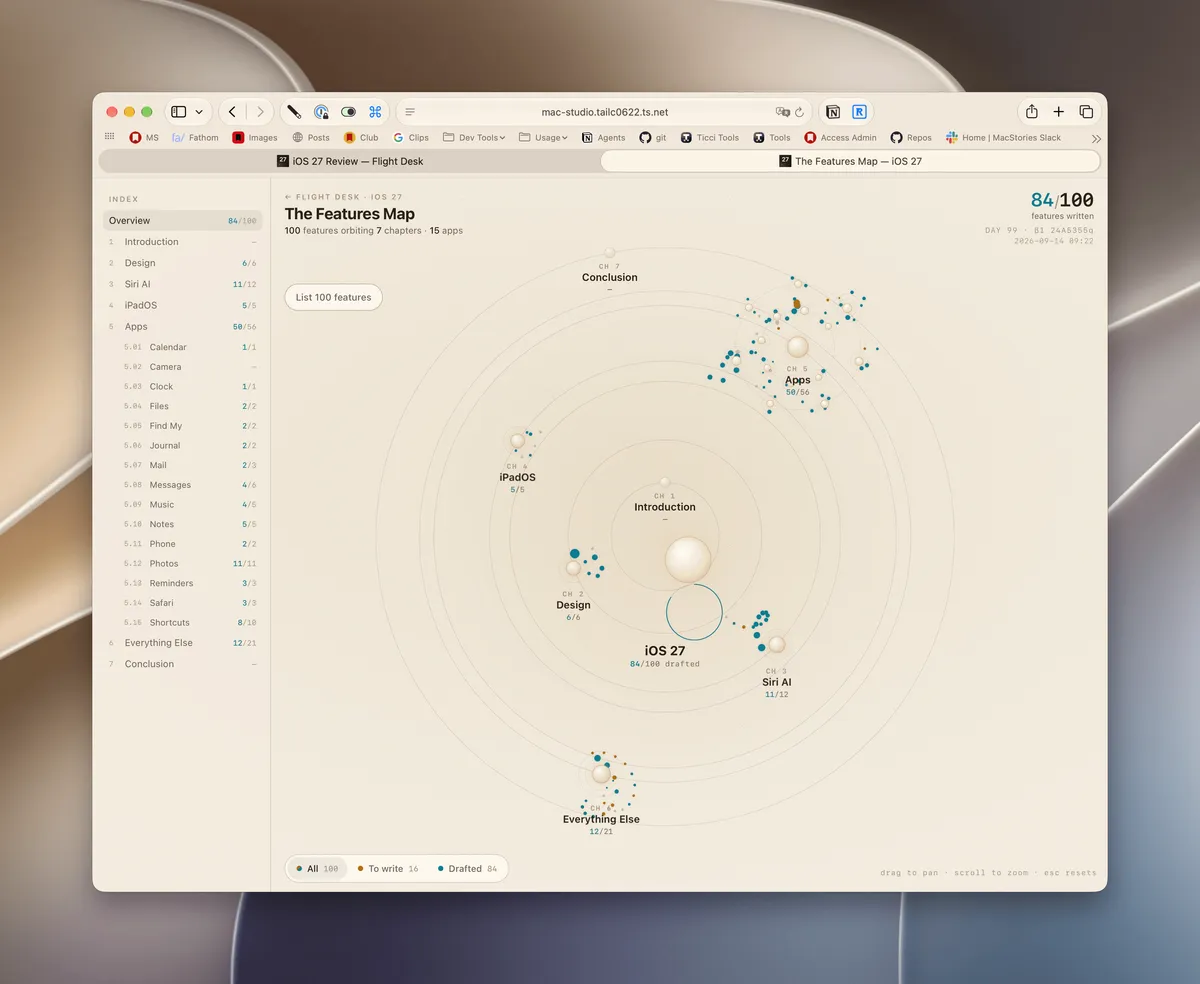
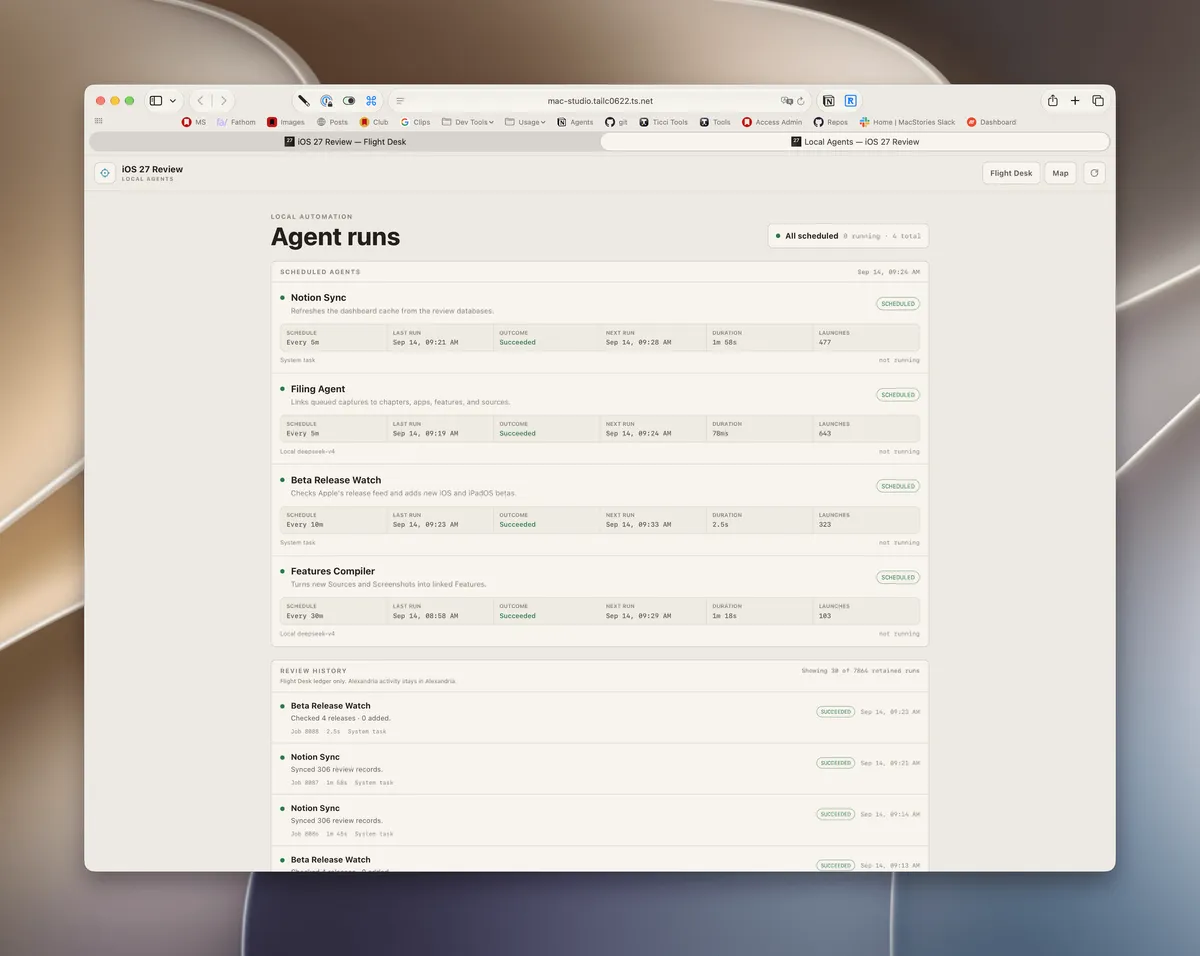
یک مورد استفاده واقعی، اپلیکیشن داخلی Desk بود. بین ژوئن و سپتامبر ۲۰۲۶، تیمی از عاملها بر پایه DeepSeek V4 Flash و olmOCR (برای نویسهخوانی نوری PDF) بهمدت ۹۹ روز بهصورت شبانهروزی فعال بودند. این ساختار برای تأمین پژوهشها و نوشتههای مربوط به بررسی iOS و iPadOS 27 استفاده شد. این پروژه شامل ۳۱۰ سند از جمله یادداشتها، جلسات، اسناد PDF و صفحات وب ذخیره شده بود.
این عاملها وظایف دقیقی را انجام دادند:
- پیادهسازی جلسات مورد علاقه WWDC با استفاده از ترکیب خلاصهسازی و پردازش مدل زبانی (LLM).
- استخراج ویژگیهای iOS و iPadOS 27 از صفحات وب، جلسات، راهنماهای PDF و یادداشتهای شخصی.
- تطبیق ویژگیها در منابع مختلف و ردیابی اینکه هر ویژگی به کدام فصل از بررسی تعلق دارد.
- استخراج ویژگیها و باگها از اسکرینشاتهای آپلود شده.
- تعامل با API نوتشن (Notion) برای سازماندهی دادهها در چندین پایگاه داده مختلف.
در مقایسه با یک PC مجهز به RTX 5090، مدل M5 Ultra توازن متفاوتی بین سرعت خام و ظرفیت ایجاد میکند. کارت گرافیک ۵۰۹۰ در دو مورد برتری دارد:
۱. پردازش پرامپت: پردازش پرامپت توسط قدرت محاسباتی تعیین میشود. مدل کل پرامپت را در یک ضرب ماتریسی عظیم میخواند، کاری که هستههای Tensor انویدیا برای آن ساخته شدهاند. در یک پرامپت ۶ هزار توکنی، ۵۰۹۰ به سرعت خیرهکننده حدود ۳۰۰۰ توکن در ثانیه رسید، در حالی که M5 Ultra حدود ۱۷۰۰ توکن در ثانیه ثبت کرد.
۲. تولید توکن: تولید توکن به پهنای باند بستگی دارد. مدل برای هر توکن، کل مدل را دوباره از حافظه فراخوانی میکند. با پهنای باند ۱.۷۹ ترابایت بر ثانیه در مقابل ۱.۲ ترابایت بر ثانیه در M5 Ultra، کارت ۵۰۹۰ در مدلهای کوچک حدود ۲۵٪ برتری در سرعت نوشتن دارد.
اما نقطه ضعف ۵۰۹۰، حافظه ۳۲ گیگابایتی VRAM آن است. در پنجرههای متنی ۲۵۶ هزار توکنی، ۵۰۹۰ فقط میتواند با یک حافظه موقت توجه (Attention Cache) ۸ بیتی کار را به پایان برساند. برای اجرای مدلهای بزرگتر یا کوانتایزیشنهای بالاتر، PC مجبور است دادهها را از طریق PCIe به رم سیستم که بسیار کندتر است منتقل کند، که نویسنده میگوید «این روشی برای زندگی نیست». در مقابل، حافظه یکپارچه M5 Ultra اجازه میدهد مدلهای بزرگتری مثل GLM-5.3-Flash با سرعت ثابت اجرا شوند.
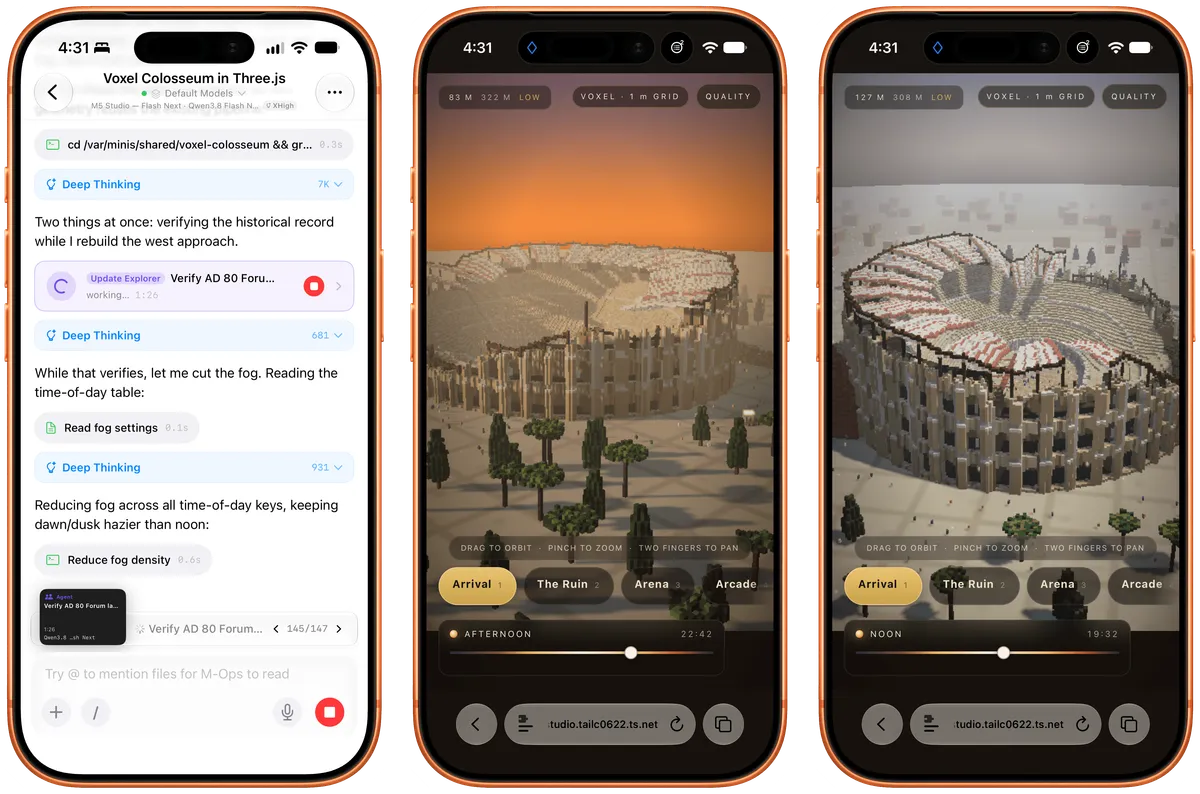
علاوه بر این، مک استودیو در سکوت کامل کار میکند. در حالی که PC گیمینگ (که در یک کیس کوچک Lian-Li A3 قرار داشت) در حین بنچمارکها گرمای زیادی تولید میکرد تا جایی که دمای اتاق را بهطور محسوسی بالا میبرد، مک استودیو خنک ماند. در استفاده روزمره با مدل Flash-Next oQ4e، صدای فن استودیو تقریباً غیرقابل شنیدن بود، مگر اینکه گوش را مستقیماً روی کامپیوتر بگذارید. نویسنده اشاره میکند که مک استودیو به دلیل اندازه، عملکرد حرارتی و سیستمعاملی که «افتضاح نیست»، انتخاب ترجیحی او نسبت به سیستم PC است.
کاربران اکنون از oMLX (نسخه 0.7.0.dev2) برای اجرای مدلهای محلی روی macOS Golden Gate 27.0 استفاده میکنند. این ساختار اجازه میدهد زیر-عاملهای محلی توسط یک مدل پیشرو مثل GPT-6 Astra مدیریت شوند. کوانتایزیشن (Quantization) — یعنی کاهش دقت اعداد برای اشغال فضای کمتر — در سطح ۵ بیت، نقطه تعادل ایدهآلی برای رم ۲۵۶ گیگابایتی ایجاد میکند و بین هوشمندی، عملکرد و حافظه تعادل برقرار میکند. در حالی که کوانتایزیشن ۵-بیت کاملاً در رم اجرا میشود، نسخههای ۶ و ۸-بیت میتوانند به لطف معماری جدید، جداول n-gram را به SSD منتقل کنند.
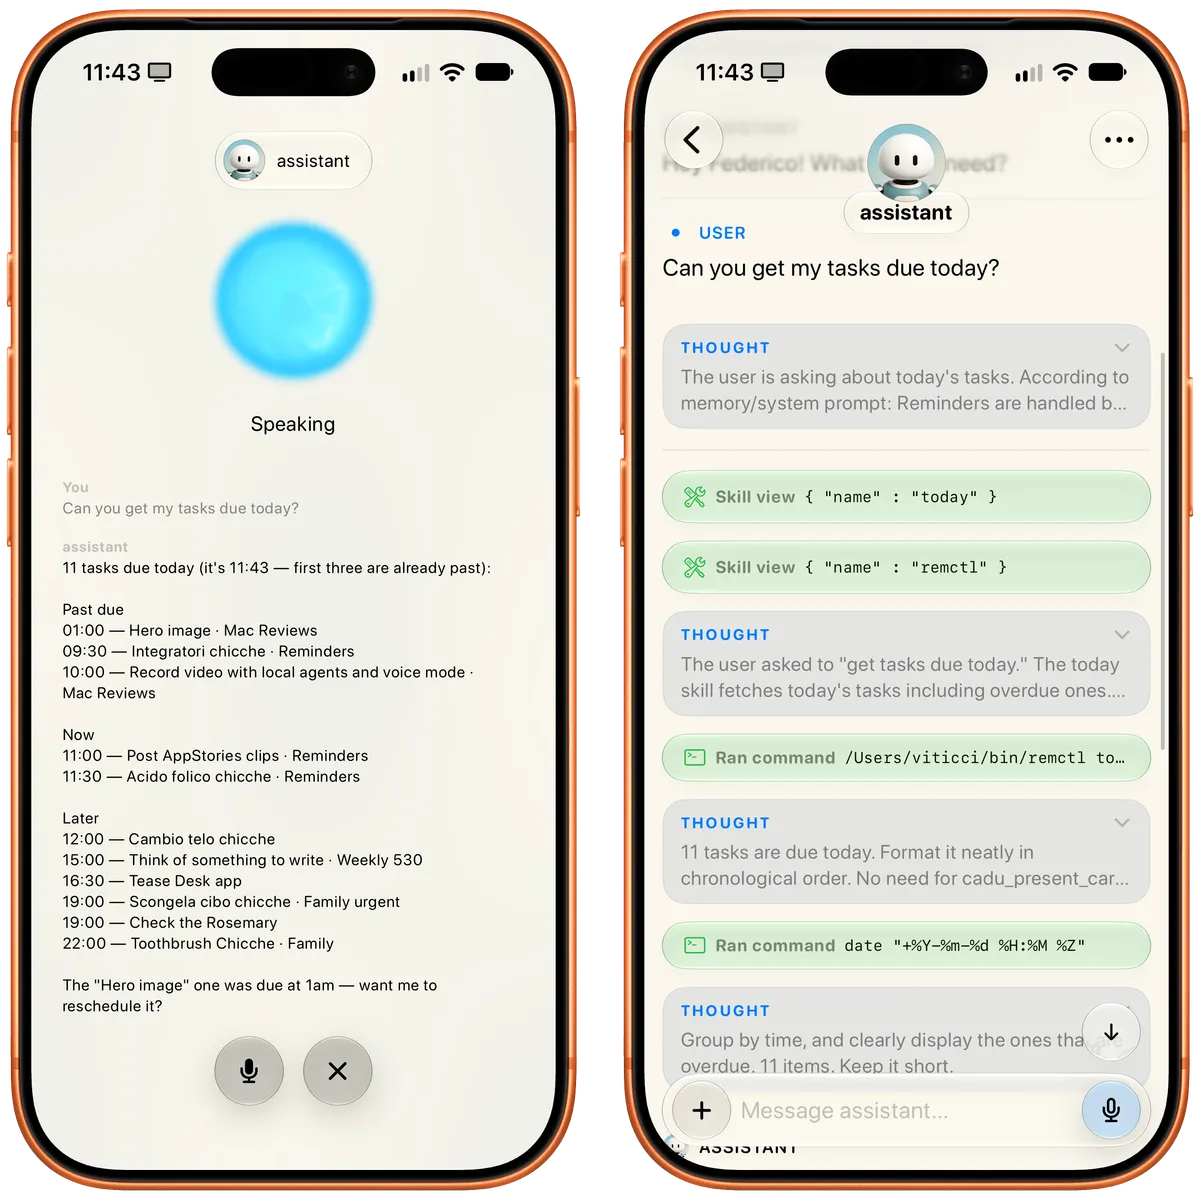
پیادهسازیهای عملی فعلی عبارتند از:
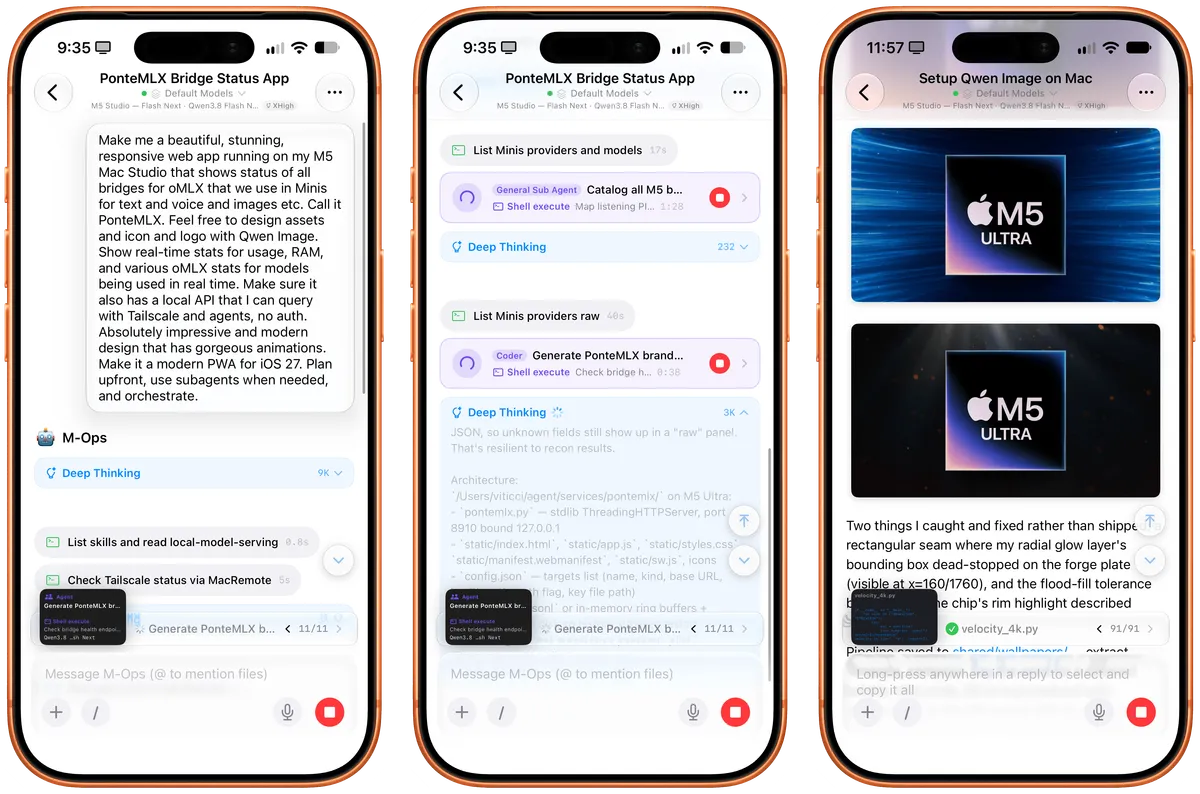
- Open Minis for iOS: استفاده از مدلهای محلی بهعنوان بکاند پیشفرض برای دستیارهای موبایل. نویسنده اکنون از Flash-Next به جای Siri AI استفاده میکند.
- Codex: سپردن کارهای کدنویسی ساده به زیر-عاملهای محلی Flash-Next و بررسی نهایی توسط یک مدل ابری. این روش اجازه میدهد تا سه جلسه همزمان Flash-Next با زیر-عاملها در oMLX ایجاد شود.
- Hermes Agent: اجرای حلقههای استدلالی پیچیده و چندمرحلهای بهصورت محلی. هنگام استفاده از RemCTL برای دریافت وظایف هفتگی، عامل در عرض چند ثانیه پرامپت را پردازش کرده و استدلال را آغاز میکند.
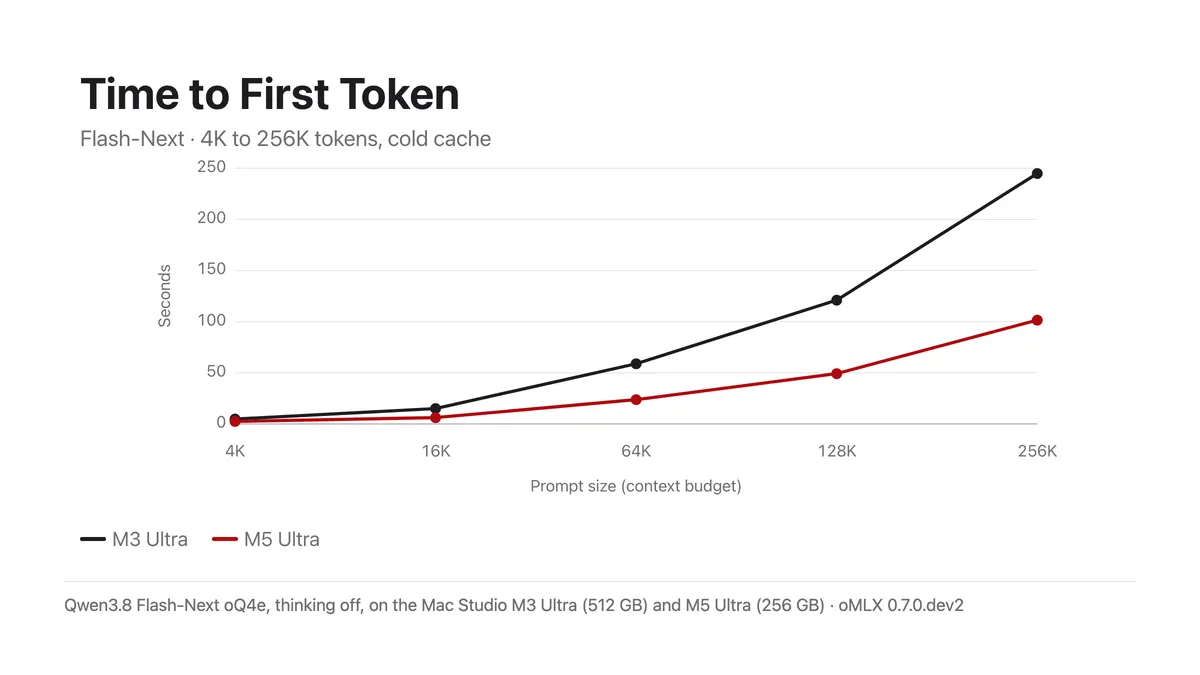
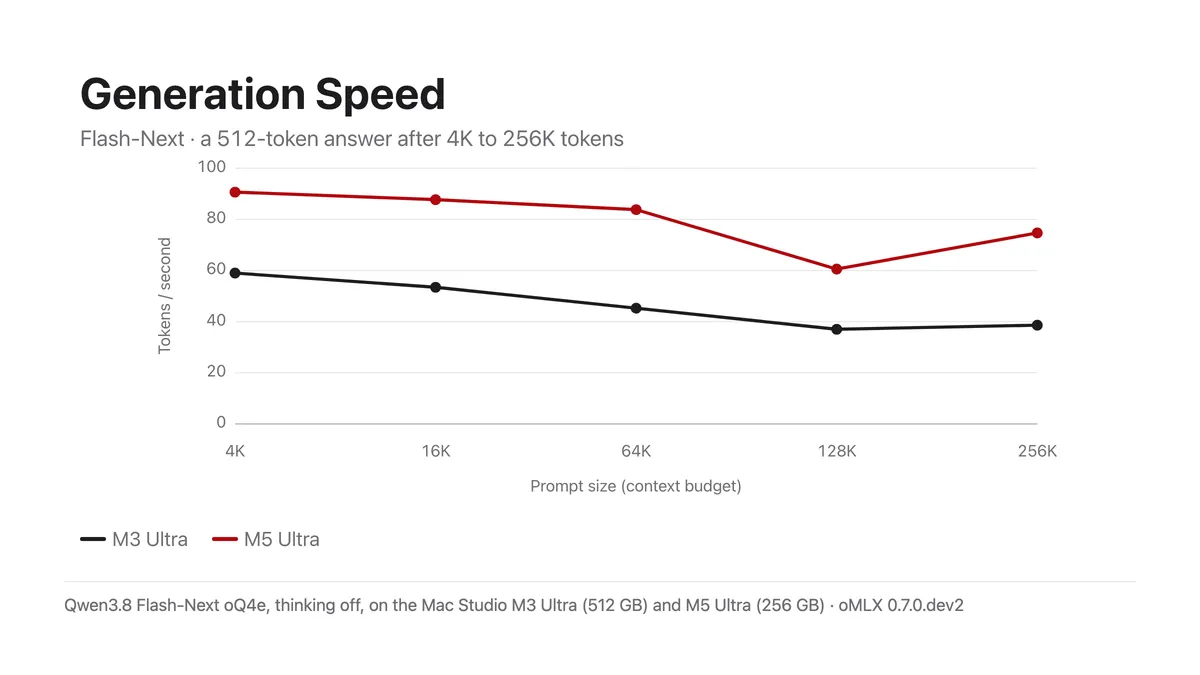
بر اساس مستندات متدولوژی تست، این اعداد طی چهار روز با یک سیستم خودکار ساخته شده توسط GPT-6 Astra به دست آمدهاند. این سیستم چندین نمونه از Codex را در M3 Ultra، M5 Ultra و PC دارای RTX 5090 هماهنگ کرد.
در مک، مدلهای اصلی تست شده عبارت بودند از:
- Qwen3.8-Flash-Next-oQ4e-mtp
- GLM-5.3-Flash-MLX-mixed-4_8bit
- Qwen3.8-27B-oQ4e-mtp
در ویندوز، از LM Studio با مدل Qwen3.8-27B-GGUF و محیط CUDA 12 استفاده شد. برای تستهای تمام-GPU، تمام ۶۶ لایه به کارت گرافیک منتقل شدند و تستهای جداگانهای برای تقسیم مدل بین GPU و رم سیستم انجام شد. دادهها توسط Astra جمعآوری و با Claude Fable 5.1 و Opus 5 با استفاده از قابلیت Projects شرکت Anthropic بصریسازی شدند. بصریسازیهای نهایی تعاملی با HTML و CSS خالص بر اساس استایل MacStories ساخته شدند.
این تحول سختافزاری، اقتصاد توسعه هوش مصنوعی را تغییر میدهد. وقتی هزینه استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند — به قیمت برق کاهش یابد، انگیزه ساخت عاملهای «همیشه روشن» افزایش مییابد. ما از پارادایم «جعبه چت» به سمت «کارگر پسزمینه» حرکت میکنیم. برای یک متخصص، این به معنای توانایی ساخت پشتههای پژوهشی بسیار شخصی و خصوصی است که نیازی به اشتراک ماهانه یا اعتبار API ندارند. این تمایل به استفاده گسترده از سختافزارهای اپل برای زیرساختهای AI، حتی در سطح سازمانهای بزرگ دیده میشود؛ برای مثال، استراتژی OpenAI برای خرید انبوه مکمینیها نشاندهنده تغییر رویکرد این شرکت به سمت بهرهگیری از اکوسیستم اپل است.
در حالی که ارائهدهندگان ابری خاص مثل Inco (که Kimi K3 را با سرعت ۳۰۰ توکن در ثانیه ارائه میدهد) یا Cerebras (که Qwen3.8-27B را با سرعت ۱۸۰۰ توکن در ثانیه ارائه میکند) سرعتهای خیرهکنندهای دارند، اما بسیار گران هستند؛ نویسنده در ۱۰ دقیقه ۲۰ دلار از اعتبار Inco را مصرف کرد. M5 Ultra جایگزینی محلی است که دادهها در آن روی دستگاهی میمانند که کاربر میتواند آن را ببیند و ریبوت کند.
با بهینهسازیهای جامعه MLX، انتظار میرود مدلهای پیشرو بزرگتری در حافظه ۲۵۶ یا ۵۱۲ گیگابایتی جای بگیرند. اکتشافات آینده ممکن است شامل موارد زیر باشد:
- DwarfStar: پروژهای از ایتالیا که مدلهای پیشرو محلی را روی پیکربندیهای مک با حافظه حتی کمتر ممکن میسازد.
- Inco Splash: یک موتور استنتاج جدید که مخصوصاً برای سیلیکون اپل و مدلهای خاص طراحی شده است.
- Exo: ابزاری که پیادهسازی RDMA آن میتواند تئوریکاً استنتاج را بین M3 Ultra و M5 Ultra از طریق Thunderbolt 5 و با استفاده از یک سرور سازگار با OpenAI توزیع کند.
منتظر عرضه نسخه ۵۱۲ گیگابایتی M5 Ultra در اواخر اکتبر باشید که احتمالاً اجازه کوانتایزیشن ۸-بیت را بدون نیاز به انتقال داده به SSD میدهد و احتمالاً شکاف با سیستمهای ردهبالای انویدیا را برای مدلهای بزرگتر میبندد. این ارتقای حافظه میتواند همانطور که در تحلیل حافظه ۵۱۲ گیگابایتی M5 Ultra اشاره شد، مک استودیو را به یک ایستگاه کاری واقعی برای مدلهای Frontier تبدیل کند.
گام بعدی شما
- اگر توسعهدهنده هستید، کتابخانه oMLX را برای مدیریت زیر-عاملهای محلی بررسی کنید.
- برای کاهش هزینه API، مدلهای Flash-Next را روی سختافزارهای اپل سیلیکون تست کنید.
- استراتژی کوانتایزیشن ۵-بیت را برای بهینهسازی مصرف رم در مدلهای بزرگ جایگزین کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو