اگر امروز یک عامل هوش مصنوعی را برای مدیریت پروژههای کدنویسی پیچیده به کار میگیرید، احتمالاً با مشکل «پرش از دستورات» یا هزینههای بالای استنتاج روبهرو هستید. مدل جدید متا این معادله را تغییر میدهد تا عاملها دقیقتر و ارزانتر عمل کنند.
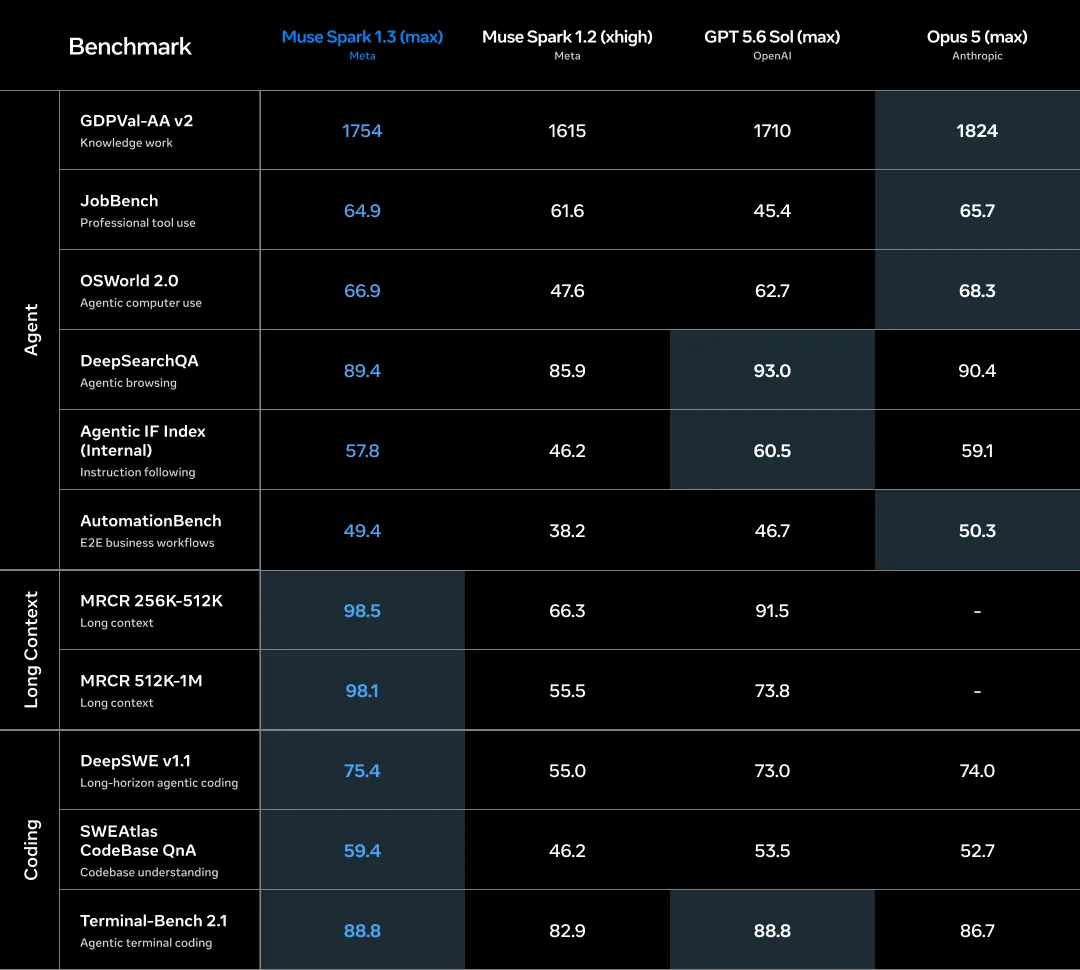
طبق اعلام متا در ۲ سپتامبر ۲۰۲۶، مدل Muse Spark 1.3 اکنون وظایف بلندمدت عاملمحور (Agentic) — یعنی سیستمهایی که مثل یک کارمند مستقل، هدف را میگیرند و مراحل رسیدن به آن را خودشان برنامهریزی میکنند — را با ۲۵٪ توکن کمتر نسبت به نسخه پیشین انجام میدهد. این بهروزرسانی دقیقاً نقاط ضعف مهندسی در دنیای واقعی را هدف قرار داده است؛ جایی که عاملهای هوش مصنوعی معمولاً در رشتههای طولانی گفتگو، رشتهی دستورات پیچیده را گم میکنند.
بسیاری از عاملهای فعلی با «رانش زمینه» (Context Drift) دستوپنجه نرم میکنند؛ وضعیتی که در آن مدل در مراحل انتهایی یک پروژه، محدودیتهای اولیه را فراموش کرده یا نتایج را به اشتباه تصور میکند وقتی که یک وظیفه شامل چندین مرحله است. همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، مدیریت دادههای متناقض همواره یک چالش بوده است. متا اکنون Muse Spark 1.3 را به عنوان پلی به سوی «ابرهوشمندسازی شخصی» معرفی میکند تا نحوه همکاری مدل با کاربران و مدیریت منابع دادهای آشفته و متناقض بهبود یابد.
زمینه و یکپارچهسازی
متا با بهرهگیری از ماهها پذیرش گسترده Muse Code و Meta Model API، این مدل را پالایش کرده است تا در محیطهای واقعی هوشمندتر و کاربردیتر باشد. این رویکرد در ادامه تلاشهای متا برای مدیریت پروژههای عظیم است، جایی که عاملهای موازی Muse Code توانستند تداخل در کدبیسهای بزرگ را حذف کنند. این مدل در مجموعهای متنوع از چارچوبهای آموزشی (Harnesses) آموزش دیده است تا اطمینان حاصل شود که میتواند در محیطهای مختلف عاملمحور بهطور کلی تعمیم یابد.
به گزارش وبسایت research.meta.ai، این مدل اکنون از طریق Muse Code و Meta Model API در دسترس است. این بهروزرسانی چندین اصلاح فنی کلیدی را معرفی میکند:
جزئیات فنی
- بهرهوری عملیاتی: مهندسان متا دریافتند که این مدل حدود ۲۰٪ کمتر از نسخه ۱.۲ از ابزارها (Tool Calls) استفاده میکند و ۲۵٪ توکنهای کمتری مصرف میکند. مدل دیگر بیش از حد پرحرف نیست و چرخشهای غیرضروری را حذف کرده است. این بهینهسازی در مصرف منابع، یادآور رویکرد متا در بهینهسازی ۲۴ ساعته هستههای GPU با استفاده از عاملهای ناهمگام است که بهرهوری سختافزاری را به حداکثر میرساند.
- پایداری عاملها: مدل اکنون برای پرامپتهای مبهم، بهطور فعال سؤالات شفافکننده میپرسد و پیش از انجام اقدامات غیرقابلبازگشت، تأییدیه میگیرد. همچنین میتواند بسته به ترجیح کاربر، بهصورت خاموش در پسزمینه کار کند یا بهطور مکرر گزارش پیشرفت ارائه دهد.
- نگاشت زمینه: حتی اگر کاربر جریان گفتگو را قطع کند یا مسیر درخواست را تغییر دهد و از درخواستهای قبلی عبور کند، مدل میتواند بهدقت درخواستهای جدید را به وظایف خاص در یک رشتهی شلوغ متصل کند.
- خودآگاهی: مدل درک بهتری از تواناییها و محدودیتهای خود دارد و بهجای توهم (Hallucination) — شبیه دوستی که خاطرهای را اشتباه تعریف میکند — تشخیص میدهد که چه زمانی با مانعی روبهرو شده است و آن را اعلام میکند.
کاربرد مهندسی
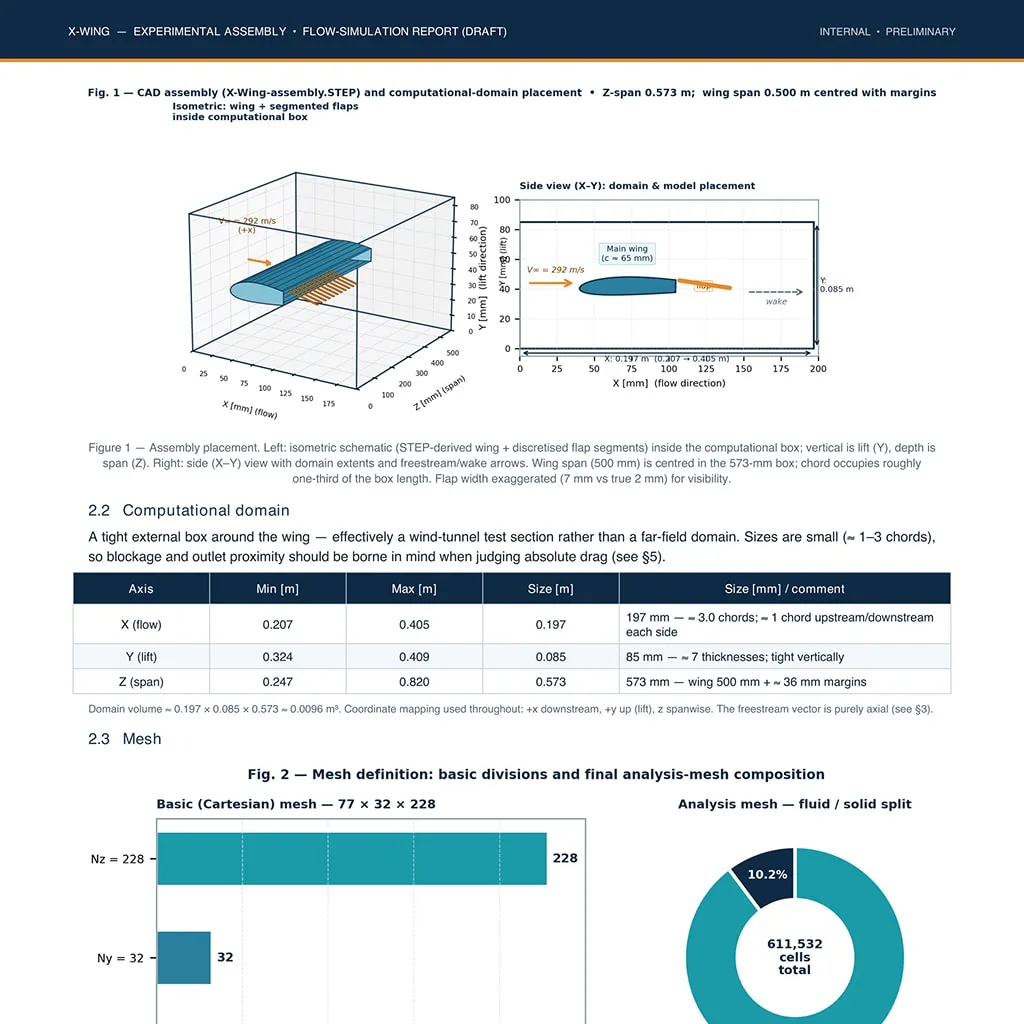
در یک نمایش عملی مهندسی، از این مدل خواسته شد تا نقش یک مهندس مکانیک در یک شرکت هوافضای کوچک را ایفا کند. هدف، تهیه پیشنویس گزارش شبیهسازی جریان برای یک مجموعهی آزمایشی X-Wing برای نسل بعدی هواپیماها بود.
برای تکمیل این پروژه، مدل دو ورودی خاص را پردازش کرد: (۱) نتایج اولیه شبیهسازی CFD و (۲) یک فایل STEP شامل مدل CAD مجموعهی بال. گزارش PDF نهایی در ۶ بخش مجزا شامل «هدف»، «محیط شبیهسازی»، «شرایط مرزی»، «نتایج»، «بحث» و «نتیجهگیری» سازماندهی شد.
مدل از دادههای پسپردازش CFD برای ترسیم اهداف تحلیل و توصیف دامنه محاسباتی، مشبندی و ویژگیهای مواد استفاده کرد. همچنین معیارهای کلیدی عملکرد را بهدقت خلاصه کرد، از جمله:
- سرعت محوری اوج (Peak axial velocity) و حداکثر شدت تلاطم.
- انرژی جنبشی تلاطم و نیروهای وارد بر بال.
- مقادیر هدف کلی و متغیرهای میدانی مانند چگالی، فشار، دما، مؤلفههای سرعت و عدد ماخ.
برای کاربران تجاری، این تغییر یعنی انتقال از «چتباتهایی که کد میزنند» به «همکاران دیجیتالی» که میتوانند بهصورت خاموش در پسزمینه کار کنند. کاهش مصرف توکنها تنها یک پیروزی فنی نیست؛ بلکه تأخیر (Latency) و هزینه استقرار عاملها در محیطهای عملیاتی تولید را بهشدت پایین میآورد.
متا با بهبود استواری خصمانه (Adversarial Robustness) و مقاومت در برابر تزریق پرامپت (Prompt Injection)، موانع امنیتی اصلی شرکتها برای دسترسی خودکار عاملها به ابزارهای داخلی را برطرف کرده است. کالیبراسیون بهتر مدل در مورد «اقدامات غیرقابلبازگشت»، نشاندهندهی حرکت به سوی خودمختاری پیشبینیپذیرتر و ایمنتر است.
متا سیگنال داده است که این یک گام تکرارپذیر است. نقشه راه شامل انتشار مدلهای بزرگتر و یک نسخه با وزنهای باز (Open Weights) از Muse Spark است که به توسعهدهندگان اجازه میدهد این قابلیتهای عاملمحور را برای کاربردهای صنعتی خاص تنظیم دقیق (Fine-tuning) کنند.
کاربران اکنون میتوانند به حالتهای استدلالی استاندارد دسترسی داشته باشند، در حالی که قابلیتهای «استدلال حداکثری» (Max Reasoning) پس از تکمیل تستهای ایمنی تکمیلی منتشر خواهند شد.
گام بعدی شما
- اگر از APIهای متا استفاده میکنید، نرخ مصرف توکنهای خود را در وظایف چندمرحلهای با نسخه ۱.۲ مقایسه کنید.
- برای کاهش توهمات در پروژههای کدنویسی، از قابلیت سؤالات شفافکننده مدل در پرامپتهای پیچیده بهره ببرید.
- منتظر انتشار نسخه وزنهای باز باشید تا مدل را روی دادههای اختصاصی صنعت خود بهینهسازی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو