۰.۱۶ ثانیه؛ این تمام زمانی است که مدل Muse Voice Transcribe شرکت متا نیاز دارد تا به نرخ خطای کلمه (Word Error Rate) ۳.۱ درصدی برای زبان انگلیسی برسد. این دستاورد که توسط Superintelligence Labs توسعه یافته، استانداردی جدید برای پردازش بلادرنگ صوت تعریف میکند تا دستیارهای هوش مصنوعی بتوانند بهطور مداوم به گفتگوهای انسانی گوش دهند.
این عرضه در حالی رخ میدهد که صنعت به سمت «ابرهوش شخصی» حرکت میکند؛ چشماندازی که مارک زاکربرگ، مدیرعامل متا، پیشبینی کرده است. در این آینده، عاملهای هوش مصنوعی (AI Agents) — شبیه به دستیاران نامرئی که همیشه در کنار شما هستند و محیط را میشناسند — از طریق گجتهای پوشیدنی مثل عینکهای هوشمند عمل میکنند تا با گوش دادن به گفتگوهای واقعی، کمکهای لازم را ارائه دهند. این رویکرد در راستای توسعه معماریهای چندوجهی است که برای بقای پشتههای فناوری هوش مصنوعی تا سال ۲۰۲۶ ضروری تلقی میشوند. همانطور که در تحلیل قبلی ما دربارهی Meta Muse Spark 1.3 و کارایی آن در کدنویسی عاملمحور اشاره کردیم، متا اکنون همان استراتژی قیمتگذاری تهاجمی و عملکرد بالا را در لایهی صوتی پیاده میکند.
برخلاف سیستمهای سنتی که از پنجرههای زمانی ثابت استفاده میکنند، Muse Voice Transcribe صوت را به تکههای ۸۰ میلیثانیهای تقسیم میکند. این مدل از یادگیری تقویتی (Reinforcement Learning) استفاده میکند تا برای هر کلمه تصمیم بگیرد که متن را فوراً چاپ کند یا برای درک بهتر، بیشتر گوش دهد. طبق مستندات متا، این رفتار با پاداش دادن به مدل در ازای دستیابی همزمان به نرخ خطای پایین و تأخیر کوتاه آموزش دیده است. کلمات ساده فوراً پردازش میشوند، اما اصطلاحات پیچیده باعث میشوند مدل کمی بیشتر صبر کند تا دقت تضمین شود.
قابلیتهای فنی
- تشخیص گوینده: مدل میتواند تا ۲۰ گوینده مختلف (از A تا Z) را در یک جریان صوتی واحد شناسایی و برچسبگذاری کند. این سیستم تغییر گوینده را در متن جاری علامتگذاری میکند بدون اینکه به سیستمهای خارجی نیاز داشته باشد.
- تشخیص جمله: سیستم بهطور همزمان بازشناسی گفتار (ASR) را با توانایی تعیین دقیق نقطه شروع و پایان هر عبارت (Utterance) آموزش دیده است.
- پشتیبانی چندزبانه: این مدل روی بیش از ۷۰ زبان آموزش دیده و ۲۵ زبان آن بهطور عمیق تست شدهاند. این سیستم میتواند «تغییر کد» (Code-switching) — یعنی وقتی گوینده در میان یک جمله بین دو یا چند زبان جابجا میشود — بهخوبی مدیریت کند.
- تقویت زمینهای: دقت برای اسامی خاص مثل «Meta»، «Muse» یا «Menlo Park» را میتوان با دادن سرنخهایی درباره کلمات کلیدی و زبان مورد نظر افزایش داد.
- مقیاسپذیری: مدل میتواند فایلهای صوتی بیش از یک ساعت را بدون نیاز به پردازش ثانویه (Post-processing) تحلیل کند. در یک دموی عملی با حضور هشت نفر در یک اتاق، سیستم توانست کلمات را در لحظه به افراد مربوطه نسبت دهد.
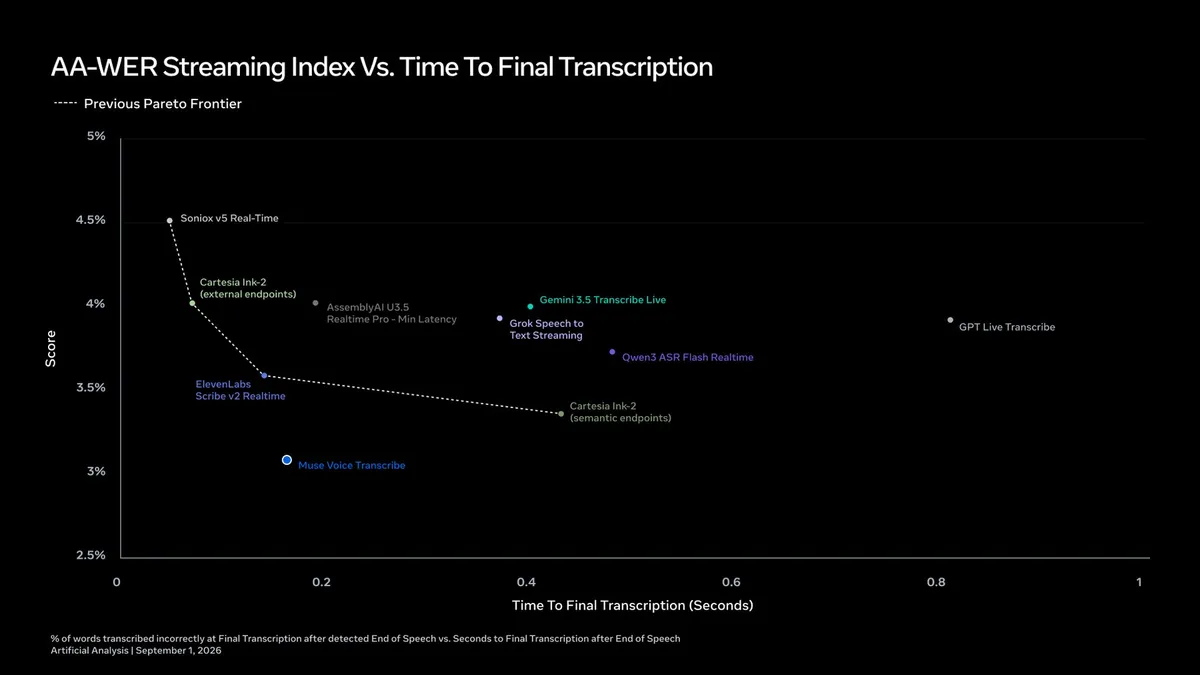
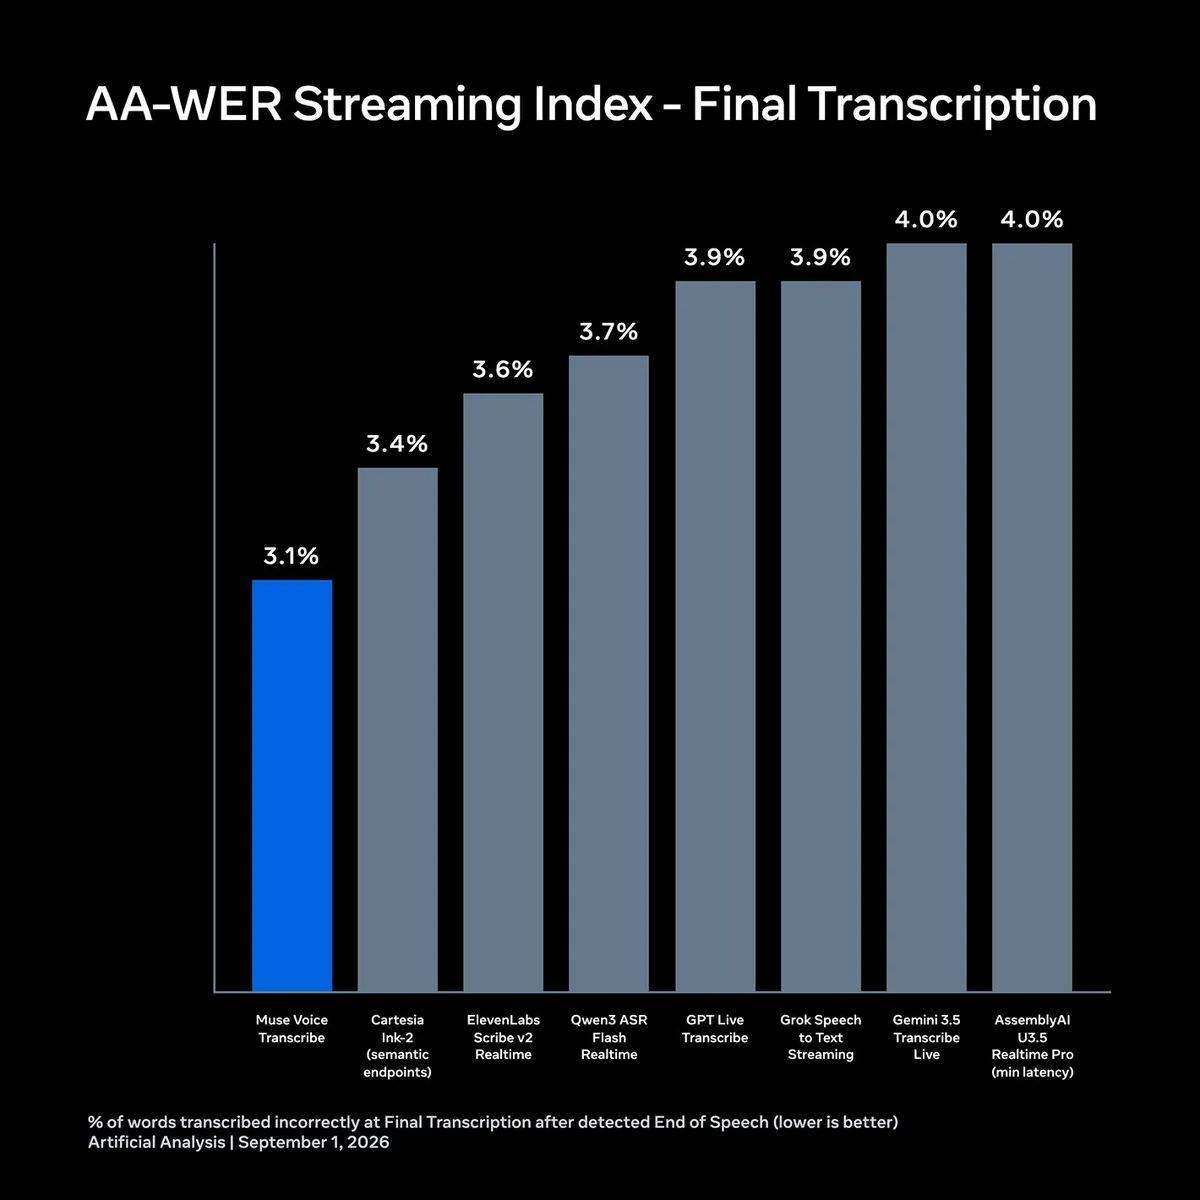
در آزمایشهای مستقلی که توسط Artificial Analysis در ۱ سپتامبر ۲۰۲۶ انجام شد، این مدل از رقبای اصلی خود پیشی گرفت. Muse Voice Transcribe با نرخ خطای ۳.۱٪، مدلهای ElevenLabs Scribe v2 Realtime (با خطای ۳.۶٪ و تأخیر ۰.۱۴ ثانیه) و AssemblyAI Universal-3.5 Pro Realtime (با خطای ۴.۰٪) را شکست داد. مدل Cartesia Ink-2 نیز بسته به اینکه از یک سیستم خارجی برای تشخیص پایان جملات استفاده کرده باشد یا خیر، نمرهای بین ۳.۴ تا ۴.۰ درصد کسب کرد.
متا برای تصاحب سهم بازار، وارد یک جنگ قیمتی شده است. هزینه این سرویس ۰.۱۸ دلار برای هر ساعت (یا ۳ دلار به ازای هر ۱۰۰۰ دقیقه) است که بهطور قابلتوجهی ارزانتر از Cartesia Ink-2 (۴ دلار) و Deepgram Flux یا ElevenLabs Scribe v2 Realtime (۶.۵۰ دلار) است. این رویکرد دقیقاً مشابه استراتژی مدلهای Muse Spark 1.1 و 1.2 است که اولویت را بر بهینهسازی هزینه برای پذیرش انبوه کاربران گذاشته بود؛ مشابه رویکرد جدید Oxlo.ai که برای کاهش هزینههای تصاعدی در پنجرههای متنی بزرگ طراحی شده است.
برای کاربر نهایی، این یعنی عینکهای هوشمند میتوانند بهزودی مانند یک منشی بینقص عمل کنند و هر کلمه در یک اتاق شلوغ را در لحظه به شخص درست نسبت دهند. با این حال، این قابلیت بحثهای حریم خصوصی را دوباره داغ کرده است؛ بهطوری که سازمان شبکه فدرال آلمان اخیراً درباره ممنوعیت عینکهای دوربیندار متا بحث کرد، هرچند در نهایت از پیگیری این ممنوعیت صرفنظر کرد.
به گزارش منابع داخلی، متا وزنهای باز (Open Weights) مدل را منتشر نکرده و جزئیاتی از حجم دادههای آموزشی، تعداد پارامترها یا منابع صوتی مورد استفاده ارائه نداده است. این پروژه حاصل یک سازماندهی گسترده در تابستان ۲۰۲۵ زیر چتر Superintelligence Labs است. متا برای جذب استعدادها از Google DeepMind، Apple و OpenAI بستههای مالی خیرهکننده تا ۳۰۰ میلیون دلار برای چهار سال پیشنهاد داد، هرچند برخی پژوهشگران پس از چند هفته دوباره به OpenAI بازگشتند.
کاربران در حال حاضر میتوانند از طریق Meta Model API یا از طریق دیکته صوتی در Meta AI و Muse Code (با نگه داشتن کلید Fn) به این مدل دسترسی داشته باشند.
گام بعدی شما
- اگر توسعهدهنده هستید، هزینه استنتاج (Inference) — همان لحظه تولید جواب توسط مدل — را با رقبای فعلی مقایسه کنید تا مدل بهینهتر را انتخاب کنید.
- قابلیت تفکیک گوینده را در جلسات چندنفره تست کنید تا دقت برچسبگذاری را بسنجید.
- برای افزایش دقت در اسامی خاص، از قابلیت Contextual Boosting در API متا استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو