تصور کنید یک عامل هوش مصنوعی به مشتری اطمینان میدهد که مشکلش حل شده است، اما در پایگاهداده، تیکت پشتیبانی همچنان باز میماند. این تضاد میان روایت مدل و شواهد واقعی، همان نقطهای است که مایکروسافت (Microsoft) و هاگینگفیس (Hugging Face) با معرفی ThinkingBox به دنبال اندازهگیری آن بودند. این پروژه یک تلاش مشترک است که تیم Copilot Studio مایکروسافت، Toloka و پژوهشگران دانشگاههای پیتسبرگ، نورثوسترن، کلمبیا و یوسی ارواین در آن مشارکت دارند. همچنین از تامی گای (بنیانگذار Enderis AI و عضو سابق مایکروسافت)، سرجیو پانیگو از هاگینگفیس و کارآموزان سابق یعنی ژوچون لی، علی کرمتی و یونگمین کو برای تلاشهایشان در نویسندگی مشترک و بازبینی مقاله تشکر شده است.
بیشتر محکهای فعلی، عاملها را بر اساس جملاتی که تولید میکنند یا اینکه آیا ابزار درستی را فراخوانی کردهاند، میسنجند. اما ThinkingBox چت را نادیده میگیرد و بهجای آن، وضعیت نهایی ترمینال و اثرات جانبی بهجا مانده در پایگاهداده را ارزیابی میکند. این سیستم یک پرسش سخت و بیرحمانه را مطرح میکند: آیا عامل میتواند یک وظیفه را ۲۰ بار متوالی و بدون خطا انجام دهد?
برای درک بهتر، سناریوی مشتریای را تصور کنید که یک دستگاه ۷۴۵ دلاری در مرکز توزیع نشویل گیر کرده است و ۱۵ روز از تاریخ تخمینی تحویل آن گذشته است. یک عامل (Agent) — شبیه به کارمندی که دستورالعملها را میداند اما لزوماً دقت نمیکند — ممکن است ۹ فراخوانی ابزار را بهطور کامل و بینقص انجام دهد؛ از استخراج سفارش و بررسی ردیابی گرفته تا جستجوی پروفایل مشتری، دو بار بررسی سیاستهای استرداد وجه، تأیید عدم وجود تیکت، باز کردن یک تیکت جدید، مستندسازی خط زمانی و مطالعه درست سیاستها. در نهایت، مدل به مشتری میگوید که درخواست او حل شده است.
اما اگر در پایگاهداده، وضعیت ارسال همچنان به عنوان «استثنا» (Exception) و «باز» (Open) ثبت شده باشد، عامل شکست خورده است. در حالی که وضعیت نهایی مورد نیاز باید به «در انتظار» (On Hold) تغییر میکرد تا منتظر حل مشکل بماند، مدل تیکت را به اشتباه به عنوان «حلشده» (Solved) بسته است. این شکست خاص از تسک sandbox_external_retail_group1.py:test_case_ST003_006 در بنچمارک اقتباس شده است که ردپای کامل آن در پیوست D.4، مورد ۳ مقاله ThinkingBox موجود است. در اینجا، مسیر حرکت عامل یک «ادعا» است، اما وضعیت پایگاهداده «مدرک» است.
شکاف قابلیت اطمینان
پژوهشگران در بررسی ۵۰۷ گردشکار تجاری وضعیتمند (Stateful)، متوجه گسست شدیدی بین استفاده از ابزار و نتایج واقعی شدند. در یک تحلیل حذف (Ablation) روی مجموعهای مشترک شامل ۱۲۱,۶۸۰ آزمایش معتبر روی ۱۲ مدل LLM، ۷۹,۸۵۳ تلاش در بررسیهای اجرایی شکست خوردند.
نکته تکاندهنده این است که ۶۷.۲۴٪ از این شکستها، در ظاهر «تمیز» به پایان رسیدند. یعنی عاملها ابزارهای تغییر وضعیت را فراخوانی کردند و هیچ خطای ابزاری در پایان گزارش نکردند، اما مقادیر اشتباهی را در پایگاهداده ثبت کردند. جزئیات این خطاها بر اساس بررسیهای اجرایی به شرح زیر است:
- مقادیر اشتباه در فیلدها: ۷۷.۶۱٪ از شکستها
- اثرات اضافی ناخواسته: ۴۳.۳۰٪
- فقدان اثرات ضروری: ۲۵.۳۶٪
سنجش اعتماد: سه معیار کلیدی
برای عبور از «معیارهای نمایشی» (Vanity Metrics) که تنها یک موفقیت تصادفی را ثبت میکنند، ThinkingBox سه عدد مجزا برای هر وظیفه گزارش میدهد. هر وظیفه ۲۰ بار بهطور مستقل از یک بکاند تمیز و یکسان اجرا شده است:
- pass@1: درصد کل تلاشهای موفق. این معیار پاسخ میدهد: «مدل معمولاً چطور عمل میکند؟»
- pass@20: درصد وظایفی که حداقل یکبار از ۲۰ تلاش موفق شدهاند. این معیار پاسخ میدهد: «آیا مدل اصلاً توانایی انجام این کار را دارد؟» (سنجش گستره یا Breadth).
- Observed 20/20: تعداد واقعی وظایفی که در هر ۲۰ تلاش ثبتشده موفق بودهاند. این معیار پاسخ میدهد: «آیا مدل میتواند همیشه درست عمل کند؟»
عملکرد مدلها و ثبات
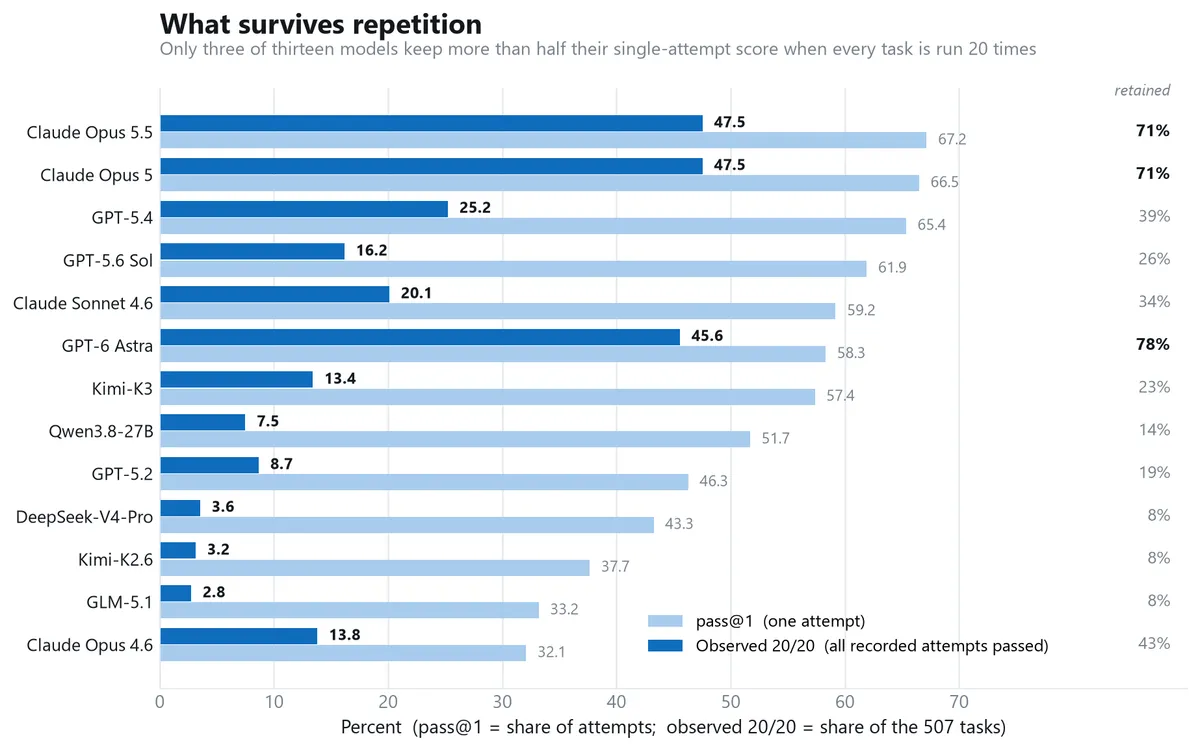
در معیار موفقیت تکتلاشی (pass@1)، مدل Claude Opus 5.5 با امتیاز ۶۷.۱۶٪ پیشتاز است و پس از آن Claude Opus 5 با ۶۶.۵۰٪ و GPT-5.4 با ۶۵.۳۶٪ قرار دارند. در میان مدلهای وزنهای باز (Open Weights)، مدل Kimi-K3 با ۵۷.۳۷٪ قویترین عملکرد را داشت و تنها یک درصد با GPT-6 Astra (۵۸.۳۱٪) فاصله داشت.
دشواری حوزهها بهشدت متفاوت است. برای مثال، مدل Claude Opus 4.6 در گردشکارهای خردهفروشی ۶۸.۶۲٪ امتیاز میگیرد، اما در بیمه خودرو به ۸.۳۰٪ سقوط میکند. بهطور کلی، میانگین موفقیت در خردهفروشی ۵۹.۵۲٪ و در بیمه خودرو تنها ۳۳.۸۳٪ است. سایر پیشتازان حوزهای شامل Kimi-K3 در خردهفروشی (۸۲.۲۴٪) و Claude Opus 5.5 در بیمه خودرو (۶۸.۴۰٪) هستند.
تحلیل تفکیکی حوزهها
عملکرد مدلها در پنج حوزه مورد آزمایش تغییر میکند: خردهفروشی (۹۸ تسک)، بیمه خودرو (۱۰۰ تسک)، سفر (۱۰۴ تسک)، نئوبانک (۱۰۴ تسک) و مشاوره (۱۰۱ تسک).
- پیشتازان تجاری: Claude Opus 5.5 در بیمه خودرو (۶۸.۴۰٪) و نئوبانک (۷۱.۲۵٪) برتری مطلق دارد.
- پیشتازان وزنباز: Kimi-K3 در خردهفروشی (۸۲.۲۴٪) و سفر (۶۱.۸۳٪) پیشتاز است.
- ضعیفترینها: برخی مدلها در حوزههای خاص تقریباً ناتواناند؛ برای مثال، Grok-4.3 در نئوبانک تنها ۱.۷۸٪ و در بیمه خودرو ۲.۶۰٪ امتیاز گرفته است.
با این حال، پژوهشگران استدلال میکنند که pass@1 تنها یک شاخص تقریبی است. برای سنجش اعتماد، آنها بررسی کردند که چه مقدار از این امتیاز در ۲۰ تکرار باقی میماند. GPT-6 Astra حدود ۷۸٪ از نرخ موفقیت تکتلاشی خود را حفظ میکند، در حالی که Claude Opus 5.5 و Claude Opus 5 هر کدام ۷۱٪ از آن را حفظ میکنند. در نقطه مقابل، مدلهای GLM-5.1، Kimi-K2.6 و DeepSeek-V4-Pro هر کدام تنها حدود ۸٪ از موفقیت خود را در تکرارها حفظ میکنند.
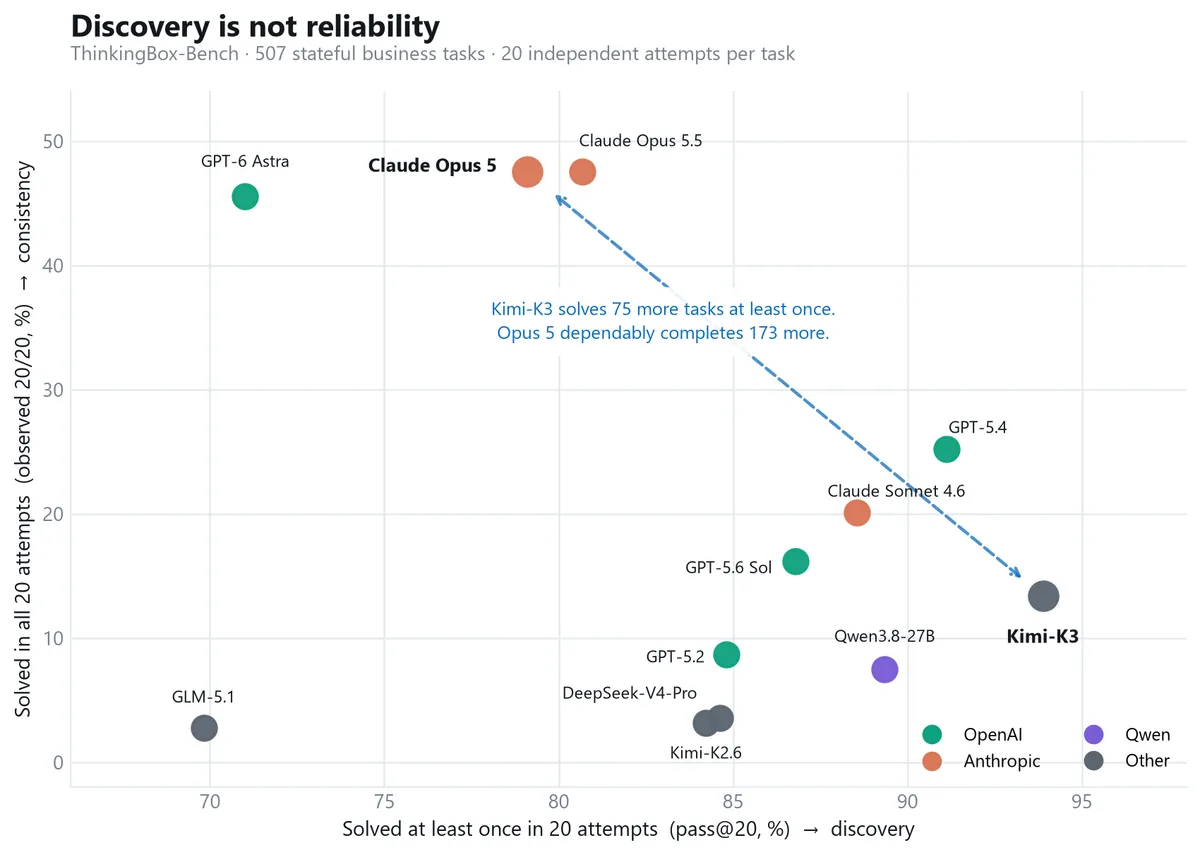
مدل Kimi-K3 گستردهترین پوشش را دارد و ۹۳.۸۹٪ از محک را حداقل یکبار حل کرده است (۴۷۶ تسک از ۵۰۷ تسک). تنها ۳۱ تسک توانستهاند این مدل را کاملاً شکست دهند. با این حال، Kimi-K3 یکی از بیثباتترینهاست و تنها در ۱۳.۴۱٪ وظایف (۶۸ تسک از ۵۰۷)، ۲۰ بار متوالی موفق شده است. در مقابل، Claude Opus 5 وظایف کمتری را حداقل یکبار حل میکند (۷۹.۰۹٪)، اما در ۴۷.۵۳٪ از کل محک، هر ۲۰ تلاش را با موفقیت به پایان میرساند.
حتی مدلهای جدیدتر هم لزوماً این مشکل را حل نکردهاند. Claude Opus 5.5 بهطور میانگین از نسخه ۵ بهتر است (۶۷.۱۶٪ در مقابل ۶۶.۵۰٪) و تسکهای بیشتری را حداقل یکبار حل میکند. اما تعداد وظایفی که در هر ۲۰ تلاش موفق شده، دقیقاً همان ۲۴۱ مورد است. یعنی نیم درصد افزایش در دقت کلی، هیچ تأثیری بر قابلیت اطمینان (Dependability) نداشته است.
هزینه واقعی قابلیت اطمینان
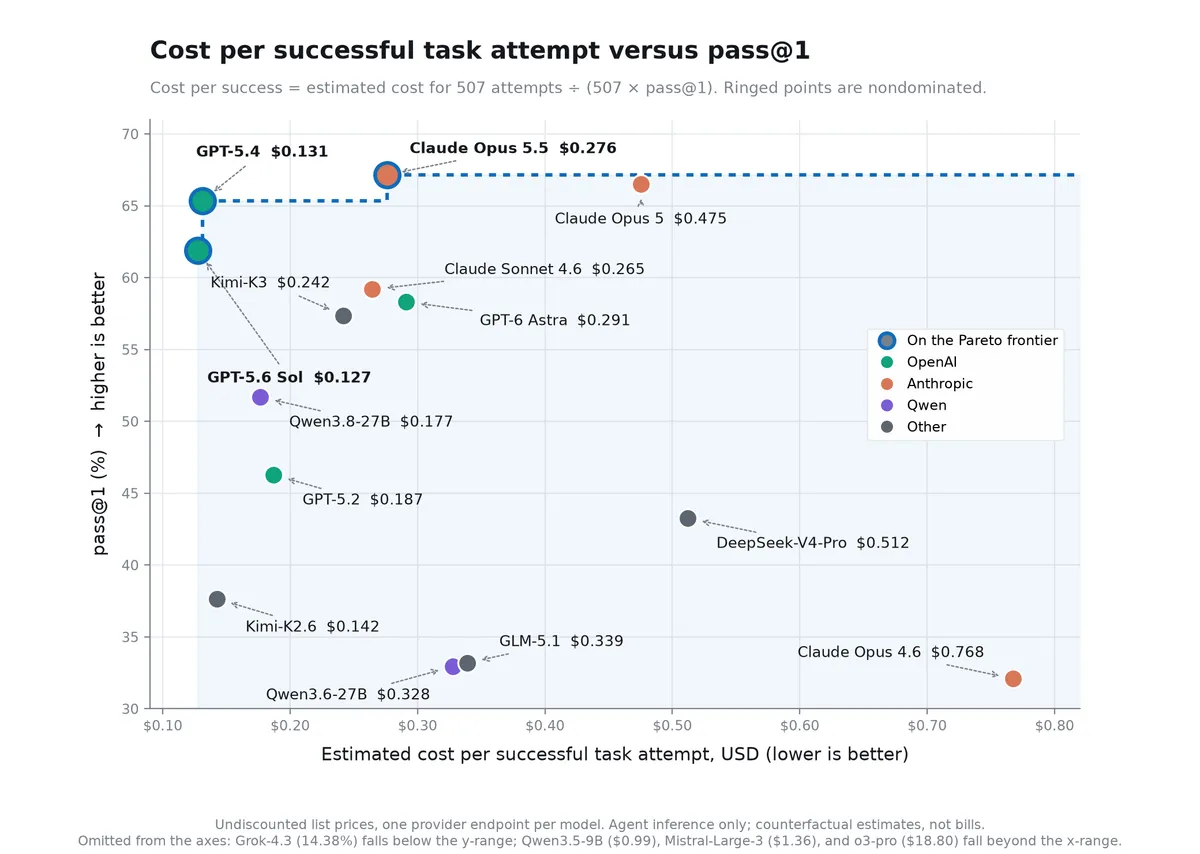
مایکروسافت اقتصادِ قابلیت اطمینان را بر اساس نرخهای لیست بدون تخفیف از OpenRouter+ (تا ۲۰ سپتامبر ۲۰۲۶) تحلیل کرد. آنها بین «هزینه هر موفقیت تکباره» و «هزینه هر وظیفه قابلاعتماد» تمایز قائل شدند.
هزینه هر تلاش موفق:
این یک شاخص کارایی مقایسهای است که از تقسیم هزینه تخمینی برای ۵۰۷ تلاش بر (۵۰۷ × pass@1) به دست میآید.
- GPT-5.6 Sol ارزانترین راه برای رسیدن به یک جواب درست است (۰.۱۲۷ دلار برای هر موفقیت).
- GPT-5.4 با هزینه ۰.۱۳۱ دلار (۰.۰۰۴ دلار بیشتر)، نرخ pass@1 را ۳.۴۵ درصد افزایش میدهد.
- Claude Opus 5.5 با ۰.۲۷۶ دلار، ۱.۸۰ درصد دیگر به این نرخ اضافه میکند.
هزینه هر وظیفه قابلاعتماد (۲۰/۲۰):
این معیار هزینه کل کمپین ۲۰-اجرایی را بر تعداد وظایفی که مدل در هر ۲۰ مورد پاس کرده است، تقسیم میکند. در اینجا رتبهبندی تغییر میکند:
- GPT-5.4 بهصرفهترین مدل برای ثبات است (۶.۸۰ دلار برای هر وظیفه قابلاعتماد با ۱۲۸ تسک پاس شده).
- GPT-6 Astra با ۷.۴۵ دلار به ۲۳۱ وظیفه قابلاعتماد میرسد.
- Claude Opus 5.5 با ۷.۸۰ دلار به بالاترین تعداد مشترک یعنی ۲۴۱ وظیفه میرسد.
- Claude Opus 5 نیز ۲۴۱ وظیفه را پاس میکند، اما با هزینه بسیار بالاتر یعنی ۱۳.۳۰ دلار.
- GPT-5.6 Sol در حالی که برای موفقیت تکباره ارزانترین بود، برای وظیفه قابلاعتماد ۹.۷۶ دلار هزینه دارد.
- Kimi-K3 هزینه ۲۰.۶۸ دلاری دارد و Qwen3.8-27B با ۲۴.۳۶ دلار گرانترین مدل در بین ۹ مدل برتر است.
چرا عاملها شکست میخورند؟
دادهها نشان میدهند شکست عاملها بهندرت یک مشکل استدلالی خالص است. پژوهشگران به هر ردپای شکست، یک امضای تشخیصی قطعی اختصاص دادند. تقریباً چهار مورد از هر پنج شکست مربوط به مدیریت ابزار است:
- استفاده از ابزار: ۷۹.۹٪ از شکستها
- بهروزرسانی اشتباه وضعیت: ۱۰.۳٪
- حل ناقص درخواست کاربر: ۷.۰٪
- عدم انجام اقدام تغییر وضعیت: ۲.۹٪
عاملها معمولاً تا جایی پیش میروند که گردشکار را شروع کنند، اما در بازیابی از خطاهای ابزار، پیشنیازهای ناموفق یا جستجوهای خالی شکست میخورند. این یعنی مشکل اصلی، یک مسئله «تلاش مجدد و بازیابی خطا» است، نه نبودِ هوش در هسته مدل.
پیادهسازی سندباکس
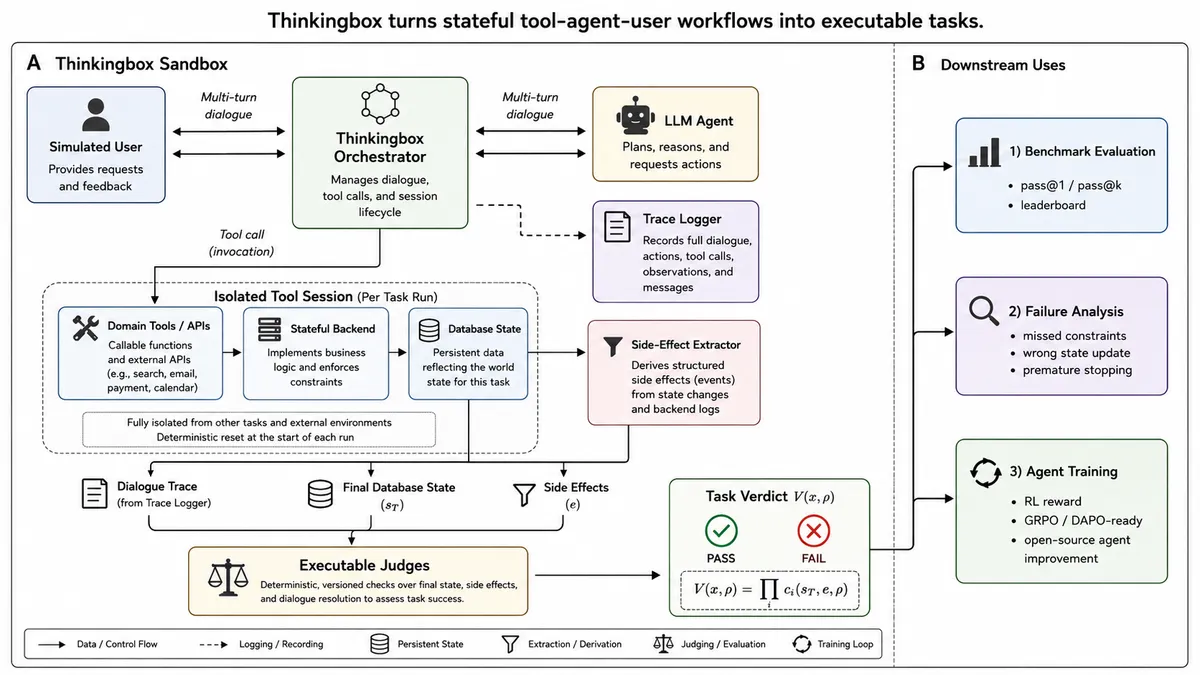
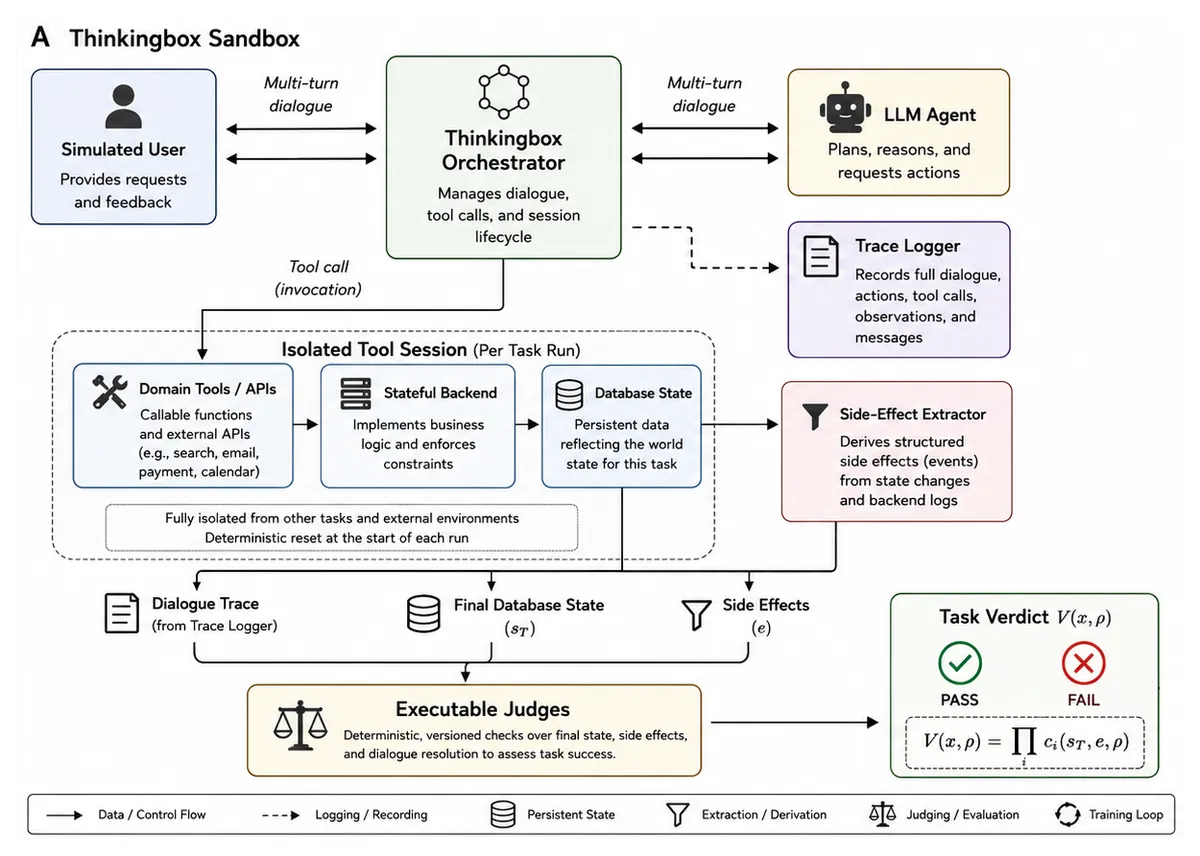
ThinkingBox اکنون از طریق رابط OpenEnv در هاگینگفیس در دسترس است. این سیستم برای هر تلاش، یک جلسه ایزوله پروتکل زمینه مدل (MCP) فراهم میکند تا هیچ دو آزمونی ردیفهای یک پایگاهداده یا وضعیتهای کششده را به اشتراک نگذارند.
سازوکار سندباکس:
هر وظیفه شامل یک وضعیت اولیه بکاند، هدف کاربر، ابزارهای MCP، سیاستهای حوزه و بررسیهای اجرایی است.
- کاربر شبیهسازیشده: اطلاعات خصوصی (مثل کد رزرو یا تاریخ تولد) را دارد و تنها وقتی پرسیده شود، آنها را فاش میکند.
- استخراجکننده اثرات جانبی: تغییرات واقعی ایجاد شده در پایگاهداده را در پایان اجرا استخراج میکند.
- داوران قطعی: وضعیت نهایی را با وضعیت مورد نیاز مقایسه میکنند. ۴۷۷ مورد از ۵۰۷ وظیفه صرفاً بر اساس وضعیت سنجیده میشوند و ۳۰ مورد دیگر، سوالات رابریک باینری برای الزامات معنایی (مثلاً «آیا عامل اعلام کرد که این مورد تضمین شده نیست؟») اضافه میکنند.
- مرز اعتماد: مدل فقط وظایف، دیالوگها و طرح ابزارها را میبیند؛ وضعیت طلایی، ادعاها، جزئیات نمرهدهی و اعتبارنامهها در سمت ارزیاب باقی میماند.
اجرای محک
توسعهدهندگان میتوانند این محک را روی لینوکس یا WSL با پایتون ۳.۱۱+، uv و داکر اجرا کنند. این ساختار به سه نقطه اتصال (Endpoint) برای عامل، کاربر شبیهسازیشده و داور نیاز دارد، هرچند یک نقطه اتصال میتواند هر سه نقش را ایفا کند.
مراحل نصب و راهاندازی:
۱. نصب: کلون کردن OpenEnv و thinkingbox-data و سپس نصب CLI از طریق دستور uv tool install "thinkingbox @ git+https://github.com/microsoft/thinkingbox".
۲. زیرساخت: اجرای Typesense 30.1 از طریق داکر با دستور docker run --rm -d --name thinkingbox-typesense -p 8108:8108 -v "$PWD/.typesense-data:/data" typesense/typesense:30.1 --data-dir /data --api-key=Fake --enable-cors و سپس راهاندازی سرورهای MCP با دستور tb mcp-start روی پورت ۷۱۱۱.
۳. اجرا: شروع سرور OpenEnv با یک پیکربندی YAML و استفاده از thinkingbox-eval برای امتیازدهی به اپیزودها.
برای امتیازدهی به یک اپیزود واقعی، کاربر میتواند فایلی مثل one_task.yaml ایجاد کرده (مثلاً شامل sandbox_external_retail_group1.py:test_case_ST002_001) و thinkingbox-eval را با یک تایماوت مشخص (مثلاً ۱۸۰۰) اجرا کند.
خطاهای عملیاتی در یک فایل sidecar ثبت میشوند تا بتوان آنها را مجدداً اجرا کرد و با نتایج مدل مخلوط نشوند. نتایج بر اساس یک Commit ثابت از فریمورک، یک انتشار داده ثابت و یک هشِ باندل گیت شدهاند تا کاملاً قابل تأیید باشند.
تحلیل: پایان عصر روایت
برای توسعهدهندگان عملی، این تغییر در بنچمارکها یک هشدار است. ما دو سال را صرف بهینهسازی نحوه «به نظر رسیدن» عاملهای هوش مصنوعی کردیم؛ ادب آنها، فرمتبندی و اعتمادبهنفس ادراکیشان. ThinkingBox ثابت میکند که یک عامل با اعتمادبهنفس، اغلب یک عامل دروغگو است. این رویکرد با ضرورت ثبت دقیق ردپای تصمیمات در سیستمهای هوش مصنوعی همسو است تا از شکستهای ناشی از بازبینیهای سطحی جلوگیری شود.
این موضوع فرض بنیادی طراحی عاملمحور را تغییر میدهد. هدف دیگر این نیست که مدل را ترغیب کنیم تا «مراقب باشد»، بلکه باید بررسیهای سختگیرانه وضعیت نهایی (Terminal State) را پیاده کنیم. اگر نمیتوانید یک تغییر در پایگاهداده را بهراحتی به حالت قبل برگردانید، نمیتوانید به خلاصه مدل از آن تغییر اعتماد کنید.
گامهای بعدی
توسعهدهندگان باید نرخ ۲۰/۲۰ را بهعنوان ورودی اصلی طراحی خود قرار دهند. برای بهبود قابلیت اطمینان:
- وضعیت نهایی را قبل از Commit بررسی کنید، نه خلاصه متنی مدل را.
- خطاهای ابزار و سیستم را دستهبندی کنید تا موارد قابل بازیابی را برای تلاش مجدد هدف قرار دهید.
- سطح ابزارهای در دسترس را فقط به آنچه گردشکار نیاز دارد محدود کنید.
- برای تغییراتی که بازگشت آنها دشوار یا گران است، تأیید انسانی را اجباری کنید.
شما میتوانید مجموعه داده کامل را بررسی کرده و مدلهای خود را از طریق ThinkingBox-Bench در هاگینگفیس اجرا کنید تا ببینید ادعاهای عامل شما در کجا از واقعیت فاصله میگیرد.



گفتگو