اگر امروز برای پردازش دادههای حجیم و کدنویسی پیشرفته به مدلهای آمریکایی تکیه میکنید، باید بدانید یک رقیب چینی با مقیاسی خیرهکننده وارد میدان شده است. Moonshot AI در ۱۶ ژوئیه ۲۰۲۶ مدل Kimi K3 را عرضه کرد؛ غولی با ۲.۸ تریلیون پارامتر که مستقیماً برای به چالش کشیدن مدلهای پیشرو (Frontier Models) ایالات متحده طراحی شده است. این جهش فنی در واقع بخشی از تلاش این شرکت برای جابهجایی مرزهای مدلهای باز است که پیشتر در گزارش مربوط به رسیدن به ۲.۸ تریلیون پارامتر و پنجره بافت یک میلیون توکنی به آن پرداختیم.
این عرضه در حالی رخ میدهد که صنعت به سمت مدلهای «کلاس ۳ تریلیونی» حرکت میکند. در این رویکرد، از مقیاس عظیم (Sheer Scale) برای رسیدن به استدلالهای پیچیده استفاده میشود. Kimi K3 خود را به عنوان نخستین مدل وزنهای باز (Open Weights) — شبیه به دستور پخت غذایی که به جای ارائه غذای آماده، روش ساختش را علناً منتشر میکند — در این مقیاس معرفی کرده است (با گرد کردن ۲.۸ تریلیون به ۳ تریلیون). هدف این مدل، پیشی گرفتن از مدل v4 Pro شرکت DeepSeek با ۱.۶ تریلیون پارامتر است. برای کاربران تجاری، این به معنای حرکتی به سوی مدلهای با ظرفیت بالا است که میتوانند مجموعهدادههای عظیم و گردشهای کاری حرفهای و پیچیده را مدیریت کنند.
زمینه و جایگاه در بازار
همانطور که در تحلیل قبلی ما دربارهی رقابت مدلهای بازمتن و بسته اشاره کردیم، توازن قدرت در حال تغییر است. Moonshot AI اکنون استراتژی قیمتگذاری خود را به سمت بخش «پریمیوم» تغییر داده است. با همتراز کردن قیمتهای خود با سری Claude Sonnet شرکت Anthropic، Moonshot سیگنال داده است که دیگر نمیخواهد صرفاً به عنوان یک جایگزین ارزانقیمت چینی شناخته شود، بلکه میخواهد بر اساس قابلیتهای خام (Raw Capability) رقابت کند. این رویکرد در واقع بخشی از استراتژی جامع Moonshot AI برای کاهش شکاف عملکردی با مدلهای برتری همچون GPT-5.6 Sol است. در واقع، Kimi K3 اکنون گرانترین مدلی است که یک آزمایشگاه هوش مصنوعی چینی تا به امروز عرضه کرده است.
بنچمارکهای عملکرد
به نقل از گزارش Artificial Analysis، مدل Kimi K3 جهشی قابلتوجه در عملکرد داشته است. این مدل در بیشتر موارد از Claude Opus 4.8 max و GPT-5.5 high پیشی میگیرد، هرچند هنوز در برابر Claude Fable 5 و GPT-5.6 Sol شکست میخورد. در ارزیابیهای مربوط به کارهای دانشی با افق زمانی بلند (Long-horizon knowledge work)، این مدل به امتیاز Elo ۱۵۴۷ رسید که جهشی ۷۳۲ امتیازی نسبت به نسل قبلی (Kimi K2.6) است و در حال حاضر در این معیار خاص، تنها از Claude Fable 5 عقبتر است.
جزئیات فنی و مالی این مدل به شرح زیر است:
- قیمتگذاری: ۳ دلار برای هر میلیون توکن (Token) — تکههای کوچکی از متن مثل برشهای یک کیک که مدل تکهتکه میخورد — ورودی و ۱۵ دلار برای هر میلیون توکن خروجی. این مبلغ نسبت به قیمت ۰.۹۵/۴ دلاری در نسخه K2.6 افزایش شدیدی داشته است.
- بهینگی: این مدل در شاخص هوش Artificial Analysis، ۲۱٪ توکن خروجی کمتری نسبت به K2.6 مصرف کرده است.
- کدنویسی: مدل Kimi K3 اکنون در میدان کدنویسی Frontend در سایت Arena.ai پیشتاز است و حتی Claude Fable 5 را شکست داده است.
- هزینه هر تسک: هزینه اجرای یک задание (تسک) در این مدل ۰.۹۴ دلار است که با GPT-5.6 Sol (۱.۰۴ دلار) مشابه و تقریباً نصف قیمت Opus 4.8 (۱.۸۰ دلار) است، هرچند همچنان گرانتر از همتایان وزنباز خود است.
- وزنهای باز: در حالی که مدل فعلاً از طریق API و وب در دسترس است، انتشار وزنهای باز آن برای ۲۷ ژوئیه ۲۰۲۶ برنامهریزی شده است.
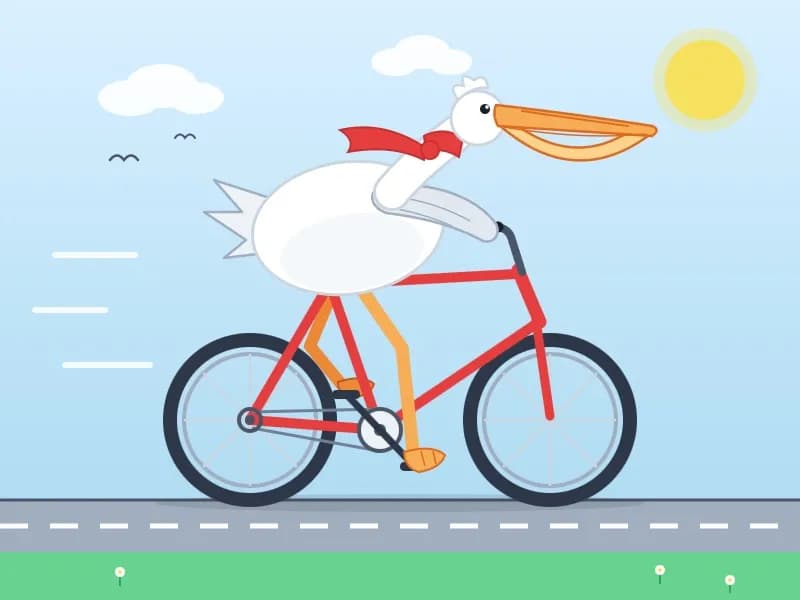
بررسی استدلال فضایی این مدل از طریق «محک پلیکان» — تولید یک فایل SVG از پلیکانی روی دوچرخه — هزینهی بالای استدلال (Reasoning) را آشکار میکند. با استفاده از OpenRouter و پلاگین llm-openrouter برای دور زدن نیاز به کلید API مستقیم Moonshot، یک پرامپت ساده منجر به تولید ۹۵ توکن ورودی و ۱۶٬۶۵۸ توکن خروجی شد. از این مقدار، ۱۳٬۲۴۱ توکن مربوط به زنجیره تفکر (Chain-of-Thought) — مثل وقتی شاگرد ریاضی پای تخته بلند بلند فکر میکند تا به جواب برسد — بود که هزینه نهایی را به ۲۵ سنت رساند.
این موضوع نشان میدهد که مدل به شدت به استدلالهای «بیشینه» (Max Effort) متکی است، زیرا K3 در حال حاضر تنها یک سطح تلاش برای استدلال دارد. مدل برای تولید یک تصویر SVG، تقریباً چهار برابر توکن استدلالی نسبت به توکنهای پاسخ واقعی (۳٬۴۱۷ توکن) مصرف کرد.
علاوه بر این، رفتار توکنسازی (Tokenization) مدل عجیب است. یک سلام ساده (hi) ۸۶ توکن محاسبه شد؛ این یعنی یک پرامپت سیستمی (System Prompt) مخفی با حدود ۸۵ توکن وجود دارد که مدل از افشای آن خودداری میکند. این در حالی است که همان دستور تولید SVG در مدلهای OpenAI و Opus 4.6 تنها ۱۰ توکن، در Opus 4.7 حدود ۳۰ توکن و در Sonnet 5/Fable 5 حدود ۲۵ توکن است.
قابلیتهای بینایی و چندوجهی
در بخش قابلیتهای چندوجهی (Multimodal) — مدلی که همزمان متن و عکس را میفهمد، شبیه به ما که با چند حس دنیا را میخوانیم — مدل K3 ورودیهای تصویری را میپذیرد. در آزمونی که مدل باید تصویر SVG تولید شده را تحلیل کند، K3 با هزینه ۰.۶ سنت، توصیفی دقیق (alt-text) ارائه کرد: «تصویر کارتونی یک پلیکان سفید با شالگردن قرمز، در حال دوچرخهسواری با یک دوچرخه قرمز در جادهای خاکستری با خطچینهای سفید؛ پلیکان منقاری نارنجی بزرگ و پاهای پردهدار نارنجی دارد که پدال میزند و خطوط حرکت سفید پشت آن دیده میشود؛ پسزمینه شامل آسمان آبی روشن با ابرهای سفید، خورشید زرد، دو پرنده سیاه کوچک در حال پرواز و چمن سبز با گلهای سفید ریز در پیشزمینه است».
برای توسعهدهندگان، پیروزی واقعی در عملکرد کدهای فرانت-اند است. پیشی گرفتن از Claude Fable 5 در یک میدان کدنویسی تخصصی نشان میدهد که مقیاس ۲.۸ تریلیون پارامتری، برتری ملموسی در درک سینتکس (Syntax) و ساختار فضایی ایجاد کرده است.
با این حال، «تست پلیکان» ثابت میکند که بنچمارکها در حال واگرا شدن هستند. این تست که ۲۱ ماه پیش به عنوان یک شوخی شروع شد اما زمانی با کیفیت مدل همبستگی داشت، اکنون از هم گسسته است؛ به طوری که پلیکانهای تولید شده توسط GPT-5.6 و Claude Fable 5 در واقع توسط GLM-5.2 شکست میخورند. بزرگترین محدودیت فعلی این است که این تستها به حیاتیترین نیاز مدرن، یعنی فراخوانی ابزاری (Agentic Tool Calling) و توانایی مدل در اجرای مطمئن ابزارها با افزایش طول گفتگو، نمیپردازند.
با این وجود، این تمرین برای مهندسی پرامپت همچنان یک «Hello World» ارزشمند است. این آزمایش تایید میکند که آیا مدل میتواند SVG معتبر تولید کند و آگاهی هندسی و فضایی اولیه دارد یا خیر. این موضوع بهویژه برای مدلهای کوچکی که روی سختافزارهای محلی مثل MacBook Pro M5 با رم ۱۲۸ گیگابایت از طریق llama.cpp، LM Studio یا Ollama اجرا میشوند، اهمیت دارد.
شما میتوانید پس از انتشار وزنها در ۲۷ ژوئیه، اثر این مدل بر اکوسیستم متنباز را دنبال کنید تا ببینید آیا میزبانی محلی یک مدل کلاس ۳ تریلیونی برای سختافزارهای سازمانی امکانپذیر است یا خیر.
گام بعدی شما
- اگر توسعهدهنده فرانت-اند هستید، پس از ۲۷ ژوئیه برای تست محلی مدل K3 روی سختافزارهای قدرتمند آماده شوید.
- هزینههای استنتاج را با مدلهای آمریکایی مقایسه کنید تا نقطه بهینه بین هزینه و دقت را بیابید.
- برای بررسی محدودیتهای استدلالی، مدل را با تسکهای تولید SVG پیچیده به چالش بکشید.
اما اثر این مقیاس عظیم بر اکوسیستم مدلهای بازمتن حتی شگفتانگیزتر است؛ منتظر تحلیل ما درباره قابلیتهای میزبانی محلی مدلهای ۳ تریلیونی باشید.



گفتگو