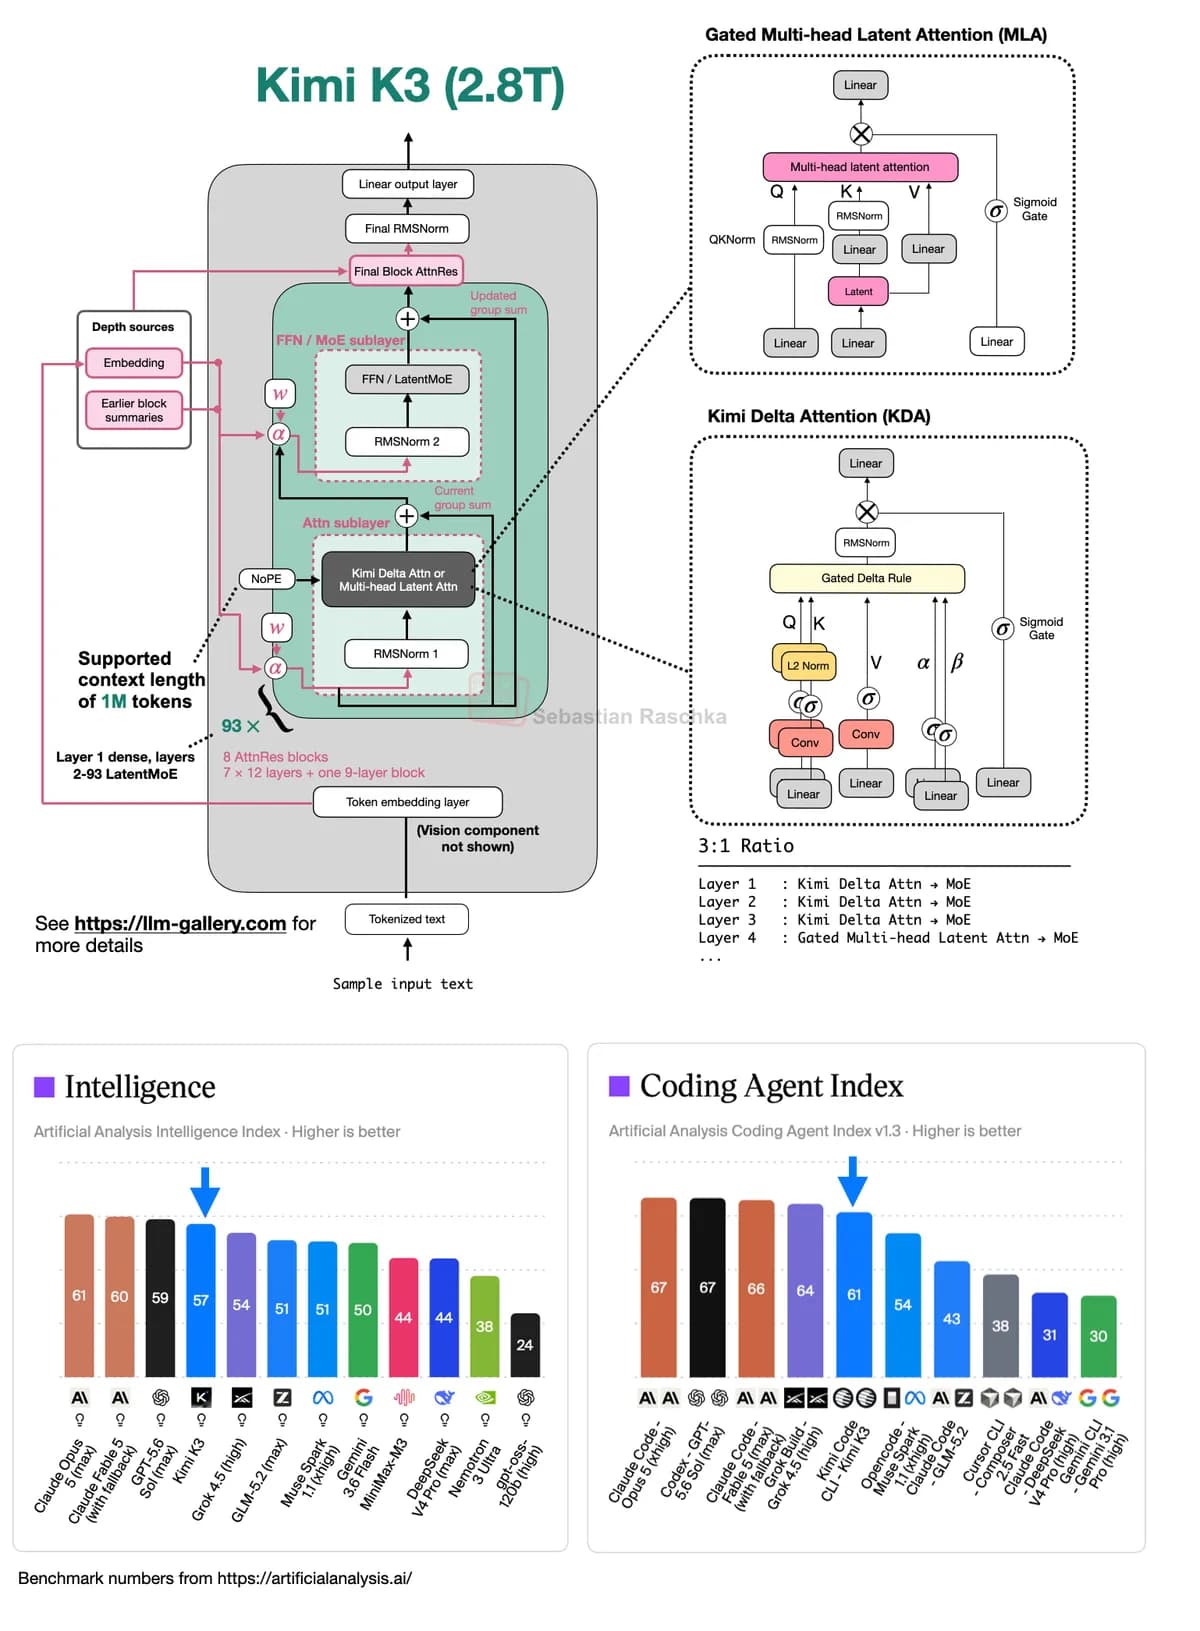
دسترسی به مدلهای تریلیونی دیگر یک امتیاز انحصاری برای آزمایشگاههای بسته نیست. با انتشار Kimi K3، اکنون ابزاری با ۲.۸ تریلیون پارامتر در دسترس جامعهی متنباز قرار دارد که مرزهای کارایی استنتاج را جابهجا میکند.
به نقل از تحلیل فنی سباستین رشکا در ۲۸ جولای ۲۰۲۶، Kimi K3 در حال حاضر بزرگترین مدل با وزنهای باز (Open Weights) موجود است و جهشی عظیم نسبت به نسخهی ۴۸ میلیارد پارامتری Kimi Linear محسوب میشود. این عرضه در حالی رخ میدهد که آزمایشگاههای پیشرو به سمت بهینهسازی شدید استنتاج (Inference) حرکت کردهاند؛ چراکه مدیریت هزینههای محاسباتی در مدلهای غولآسا به یک چالش حیاتی تبدیل شده است. همانطور که در تحلیلهای پیشین ما دربارهی قوانین مقیاسپذیری اشاره کردیم، توازن بین تعداد پارامترها و هزینهی عملیاتی، نقطهی تعیینکننده در بقای مدلهای تجاری است. این فشار عملیاتی پیش از این نیز در تغییر ساختار عضویت Kimi برای مدیریت تقاضای غیرمنتظره مشاهده شده بود.
این مدل برای کاهش سربار لایههای خطی، از مکانیزم LatentMoE برای فشردهسازی لایههای بزرگ استفاده میکند. همچنین Kimi Delta Attention برای بهینهسازی حافظه و پردازش به کار گرفته شده است.

بر اساس مستندات فنی, Kimi K3 رویکرد متفاوتی در مسیرهای باقیمانده (Residual Paths) دارد. برخلاف مدلهای رایج، این مدل از باقیماندههای توجه استفاده میکند که لایهها را از طریق امتیازات توجه وزندهی میکند. این تغییر، هزینهی آموزش را ۴٪ و هزینهی استنتاج را ۲٪ افزایش داده است، اما منجر به بهبود مستمر در تابع زیان (Loss Function) شده است.
جنجالیترین تغییر در Kimi K3، حذف کامل رمزگذاری موقعیت (Positional Encoding) چرخشی یا RoPE است. این مدل بهطور کامل بر معماری NoPE (بدون رمزگذاری موقعیت) تکیه کرده و نخستین مدل در سطح پیشرو است که در تمامی لایهها از این روش استفاده میکند.
طبق گزارش Telnyx در ۲۸ جولای ۲۰۲۶، این مدل اکنون از قابلیتهای بومی چندوجهی (Multimodal) و پنجرهٔ زمینه (Context Window) یک میلیون توکنی بهره میبرد و از طریق API این شرکت با شناسه moonshotai/Kimi-K3 در دسترس است. این مقیاسپذیری عظیم با زیرساختهای پیشرفتهای ممکن شده است، مشابه آنچه در استفاده از Firecracker برای تابهبندی مدلهای عظیم Moonshot AI دیدیم.
این چرخش ساختاری نشان میدهد که صنعت احتمالاً به سقف کارایی RoPE رسیده است و برای مدیریت متون میلیونی به طرحهای سادهتر یا کاملاً متفاوتی نیاز دارد. همچنین استفاده از LatentMoE ثابت میکند که صرفاً «پراکندگی» (Sparsity) کافی نیست و فشردهسازی فعال لایههای ترکیب خبرهها (MoE) پیششرط مقیاسپذیری به سطح تریلیون است. این رویکرد در تضاد با استراتژیهایی است که مدلهای متخصص Sakana AI برای رقابت با غولهای تکسازه به کار میبرند.
گام بعدی شما
- بررسی اثر حذف RoPE بر انسجام متنهای طولانی در مقایسه با مدلهای Llama و Mistral.
- تست قابلیتهای بینایی بومی Kimi K3 در تحلیل اسناد حجیم تصویری.
- ارزیابی نرخ تأخیر در استنتاج این مدل در مقیاس تریلیونی از طریق API تلنیکس.
اما تأثیر این تغییر معماری بر هزینه سختافزاری استنتاج حتی پیچیدهتر است — به تحلیل ما دربارهی بهینهسازیهای KV Cache مراجعه کنید.



گفتگو