اگر امروز برای اجرای مدلهای استدلالی سنگین هزینههای گزاف پرداختی دارید، انویدیا راهی برای کاهش این هزینهها بدون افت کیفیت پیدا کرده است. در ۱۵ اکتبر ۲۰۲۶، شرکت انویدیا (Nvidia) از مدل Nemotron 3.5 Super VL پردهبرداری کرد؛ یک مدل چندوجهی (Multimodal) — شبیه به انسانی که همزمان متن را میخواند، عکس را میبیند و صدا را میشنود — که بهطور خاص برای عاملهایی طراحی شده که باید بهصورت شبانهروزی در پسزمینه، متن، تصویر و ویدیو را پردازش کنند.
بسیاری از سیستمهای هوش مصنوعی سازمانی امروز به ارائهدهندگان مدلهای بسته وابستهاند و شرکتها مجبورند شرایط سخت استفاده و مدیریت دادههای خارجی را بپذیرند. طبق گزارشهای صنعتی، این عرضه یک چرخش راهبردی به سمت «حاکمیت محاسباتی» است تا شرکتها بتوانند مدلها را روی سرورهای خصوصی خود تنظیم دقیق (Fine-tuning) کنند — یعنی مثل وقتی به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه خاص خبره شود. همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، این حرکت بخشی از موج بزرگتری است که در آن آزمایشگاههای غربی برای به چالش کشیدن تسلط مدلهای چینی، به سمت وزنهای باز (Open Weights) — که در آن دستور پخت مدل علناً منتشر شده و نه فقط غذای آماده — حرکت میکنند. وبسایت ZDNET اشاره میکند که این روند به آزمایشگاههای غربی کمک میکند تا برتری پیشین آزمایشگاههای هوش مصنوعی چین را به چالش بکشند.
معماری بهرهوری
مدل Super VL دارای ۱۲۰ میلیارد پارامتر (Parameters) است، اما برخلاف مدلهای متراکم، همه آنها را همزمان به کار نمیگیرد. این مدل از معماری ترکیب خبرهها (Mixture of Experts یا MoE) استفاده میکند؛ سیستمی شبیه به یک بیمارستان که برای هر بیماری فقط متخصص مربوطه را صدا میزند، نه تمام پزشکان را. در اینجا برای هر توکن (Token) — تکههای کوچکی از متن که مدل تکهتکه میخورد — تنها ۱۲ میلیارد پارامتر فعال میشوند. این طراحی اجازه میدهد هوش مدل حفظ شود بدون اینکه فشار محاسباتی عظیمی به سختافزار وارد شود.
انویدیا این مدل را با همکاری «ائتلاف نموترون» توسعه داده است. این گروه شامل شرکتهای Mistral AI، Thinking Machines Lab، Perplexity و Black Forest Labs است. این مدل در کنار یک خط تولید گستردهتر قرار میگیرد که شامل مدل Lightning (منتشر شده در ماه اوت برای توان عملیاتی بالا) و مدل Ultra (که برای سختترین وظایف استدلالی طراحی شده) است.
بر اساس مستندات انویدیا، Super VL از طریق فرآیند تقطیر (Distillation) از مدل Nemotron 3 Ultra استخراج شده است که بزرگترین مدل استدلالی انویدیاست. این مدل با وجود داشتن تنها حدود یکپنجم پارامترها، در دنبال کردن دستورات، فراخوانی ابزارها و تحلیل تصاویر، دقتی برابر با Ultra دارد. در آزمونهای Hermes و LangChain، این مدل حتی در وظایف مربوط به عامل (Agent) نمرات بالاتری نسبت به Ultra کسب کرد. همچنین در محکهای کدنویسی Terminal-Bench و SWE-bench، از نسل قبلی خود یعنی Nemotron 3 Super پیشی گرفته است. اگرچه در کدنویسی کمی ضعیفتر از برخی رقباست، اما انویدیا تأکید میکند که وظایف را چهار برابر سریعتر به پایان میرساند.
جهش در سرعت و توان عملیاتی
سرعت، مزیت اصلی برای عاملهایی است که باید هزاران وظیفه را طی هفتهها انجام دهند. به نقل از جدول امتیازات Artificial Analysis، مدل Super VL روی یک واحد پردازش گرافیکی (GPU) — که در واقع کرایه آشپزخانه صنعتی مدل است — تا ۵ برابر توان عملیاتی بیشتری نسبت به مدلهای باز مشابه در وظایف عاملی دارد.
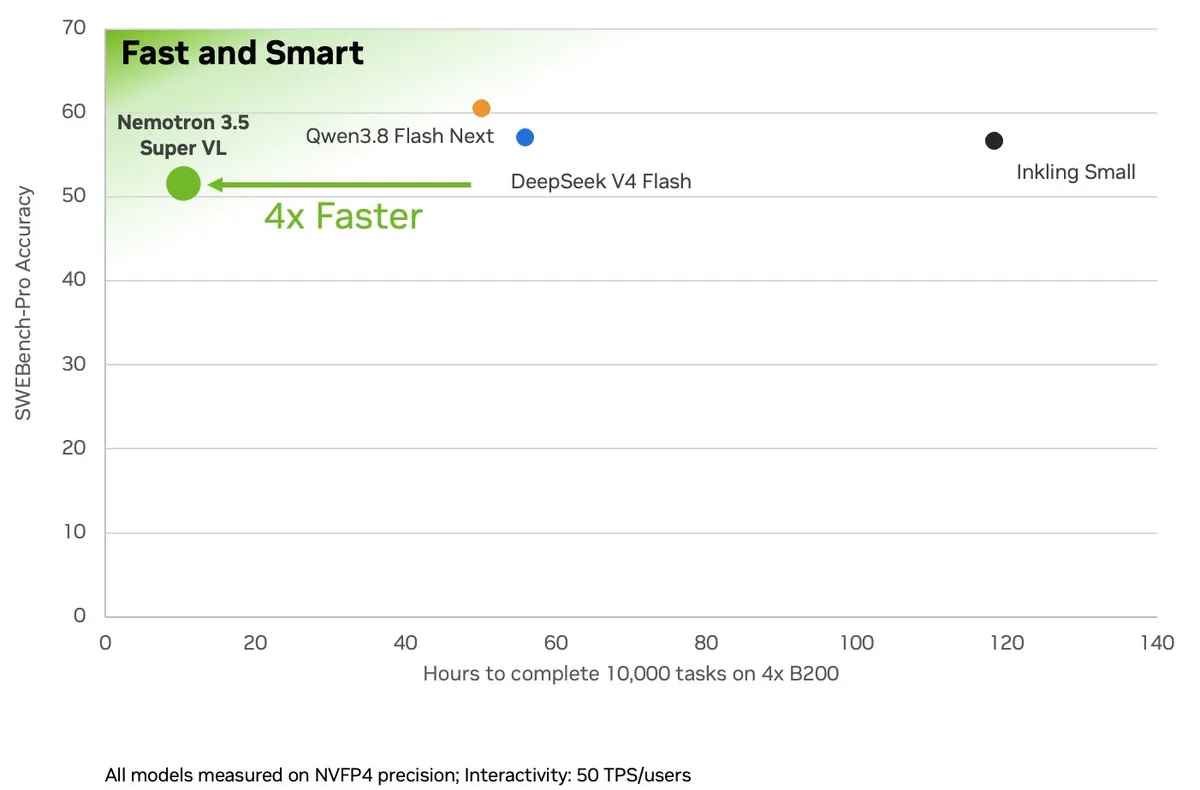
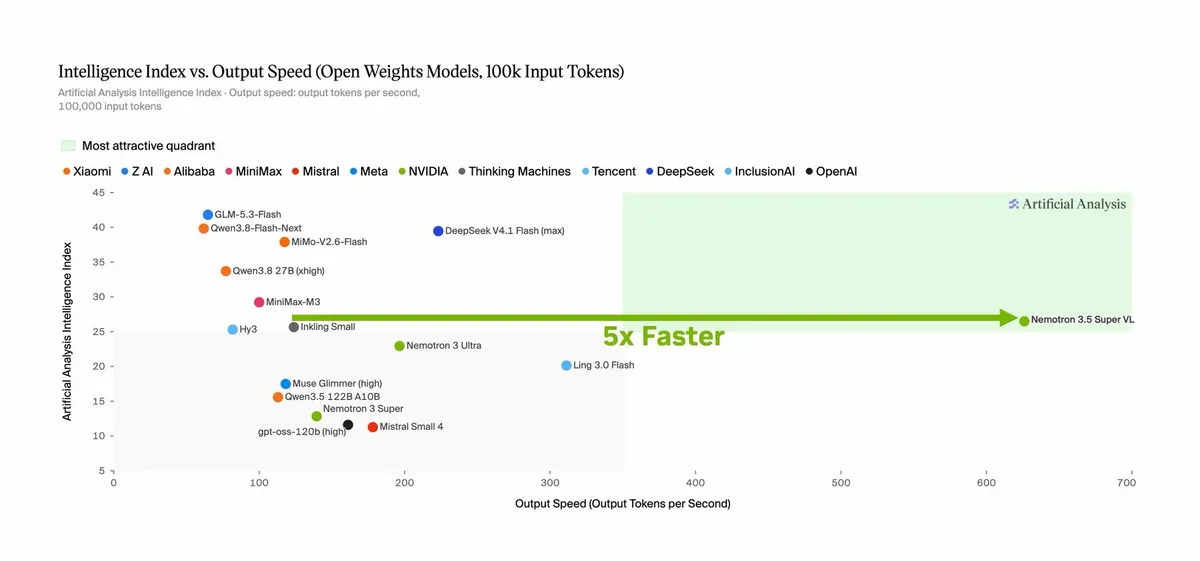
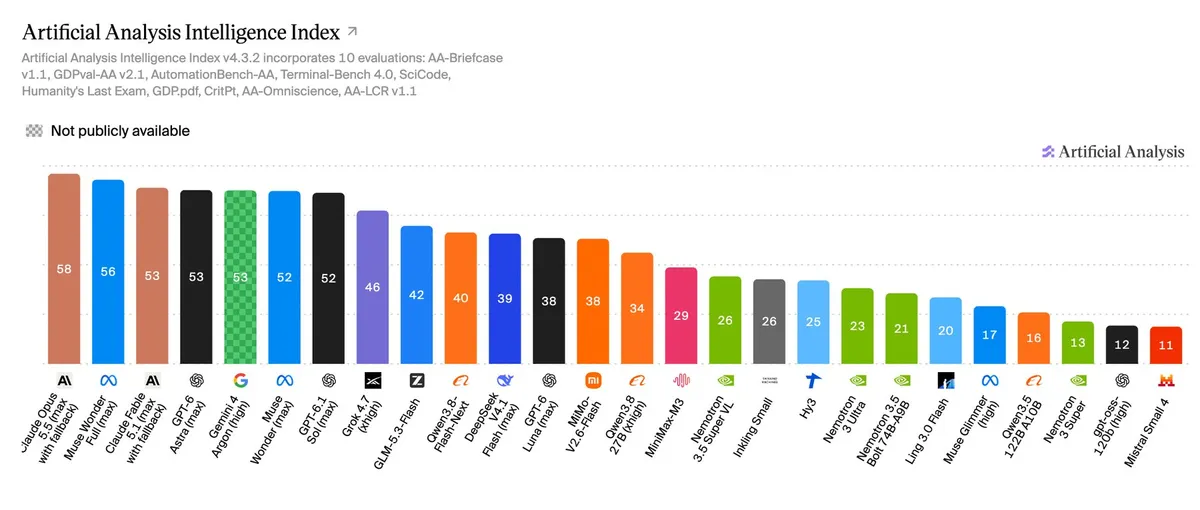
انویدیا ادعا میکند در سطح امتیاز شاخص هوش (Intelligence Index) مشابه، این مدل ۵ برابر توکن بیشتری در ثانیه نسبت به همتایان باز-وزن خود تولید میکند. آزمایشهای مستقل EXO Labs روی سختافزار DGX Spark تأیید کرد که هیچ مدل دیگری بهطور همزمان هم سریعتر و هم دقیقتر از Super VL نبود. هرچند Super VL در رتبهبندی کلی Artificial Analysis با فاصله زیادی از مدلهای بسته پیشرو عقب است، اما عملکرد مدل Nemotron 3 Ultra خودِ انویدیا را شکست میدهد.
بهینهسازی سختافزاری و فشردهسازی
برای رسیدن به حداکثر بازدهی روی GPUهای Blackwell، انویدیا از فرمت فشردهسازی 4-bit NVFP4 استفاده کرده است. این یعنی مدل روی کارتهای جدید کاملاً با دقت ۴ بیتی اجرا میشود، در حالی که سختافزارهای قدیمیتر وزنها را در ۴ بیت ذخیره و محاسبات را در ۱۶ بیت انجام میدهند. برای جلوگیری از افت کیفیت، بخشهای حساس مدل با دقت بالاتری حفظ شدهاند. انویدیا نسخه فشرده را بهگونهای آموزش داده که خروجیهای آن دقیقاً با نسخه اصلی مطابقت داشته باشد.
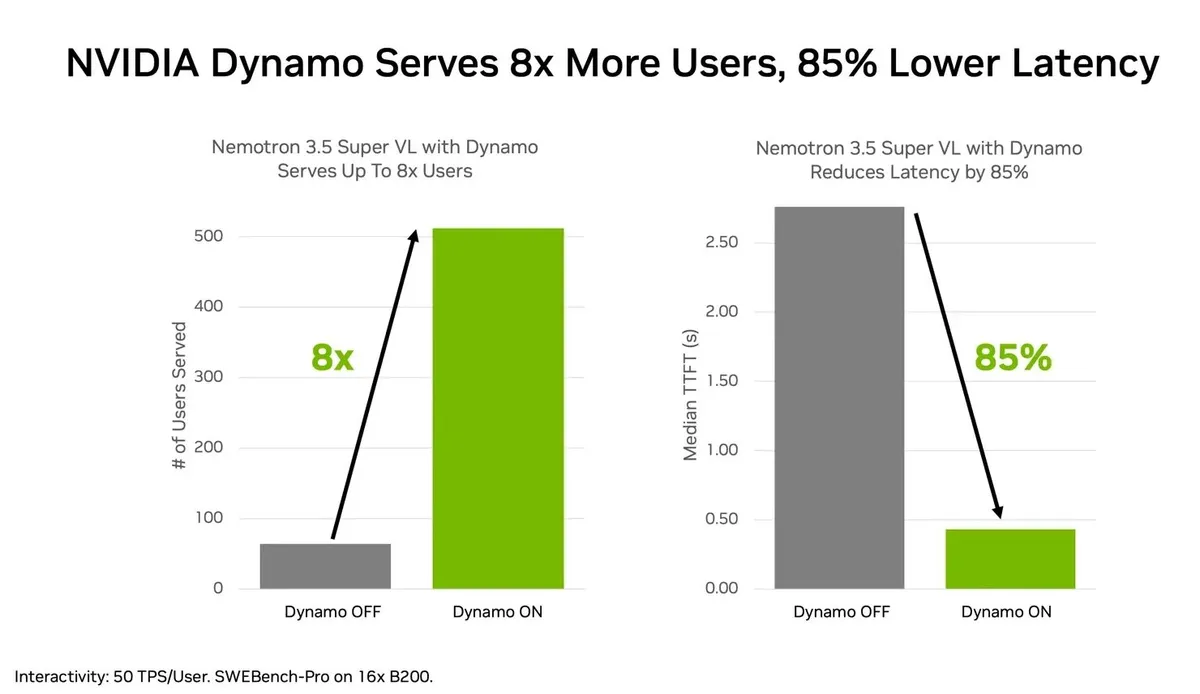
همزمان، نرمافزار استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند و شبیه خودِ آشپزی است، نه دوره آموزش — به نام Dynamo معرفی شد. Dynamo با ذخیره دستورات تکراری در حافظه (Caching) و هدایت جلسات به یک GPU واحد، اجازه میدهد مدل ۸ برابر کاربران همزمان بیشتری را پشتیبانی کند و زمان تا نخستین توکن را ۸۵ درصد کاهش دهد.
مکانیزمهای پیشرفته استنتاج
برای افزایش سرعت، انویدیا یک مؤلفه پیشنویس (Draft) داخلی را پیاده کرده که چندین توکن را از پیش پیشنهاد میدهد. سپس مدل اصلی این توکنها را در یک مرحله (Forward Pass) تأیید میکند. انویدیا روی DGX Spark روش LiLiCorr را توصیه میکند که توکنهای پیشنویس را بهصورت دستهجمعی ارزیابی میکند تا خروجی منسجمتری داشته باشد. این رویکرد سرعت تولید متن را تا ۲.۳ برابر نسبت به حالتی که بدون پیشنویسهای گمانهزن (Speculative Drafts) اجرا شود، افزایش میدهد.
بهرهوری از طریق ذخیرهسازی محاسبات (Computation Caching) نیز بهبود یافته است. عاملها اغلب توصیفات ابزار، تاریخچه گفتگو و دستورات یکسانی را در هر درخواست ارسال میکنند. Super VL این بخشهای تکراری را ذخیره میکند تا دوباره آنها را پردازش نکند. روی ۱۶ عدد GPU B200، این ترکیب از ذخیرهسازی و مسیریابی باعث میشود مدل ۸ برابر کاربران بیشتری را پشتیبانی کند و تأخیر شروع پاسخ را ۸۵ درصد کم کند.
قابلیتهای چندوجهی
برخلاف بسیاری از عاملها که به یک مدل بینایی جداگانه نیاز دارند، Super VL جداول، نمودارها و PDFها را بهصورت بومی تحلیل میکند. این مدل برای مواد کاری روزمره، از جمله OCR (نویسهخوان)، اسناد چندصفحهای و ویدیوها طراحی شده است. این مدل میتواند یک نمودار را تفسیر کرده، آن را به جدولی در جای دیگر همان سند مرتبط کند و هر دو را خلاصه نماید.
- تحلیل نمودار: در محک CharXiv، این مدل امتیاز ۸۰.۸ درصد را کسب کرد که بهطور قابلتوجهی بالاتر از ۶۳ درصد مدل Nemotron 3 Nano Omni است. با قابلیت اجرای کد پایتون، این عدد به ۸۴ درصد میرسد.
- عملکرد OCR: طبق اعلام انویدیا، این مدل در جدول OCRBench v2 جزو بهترین مدلهای باز است.
انتقال عاملها به لبه
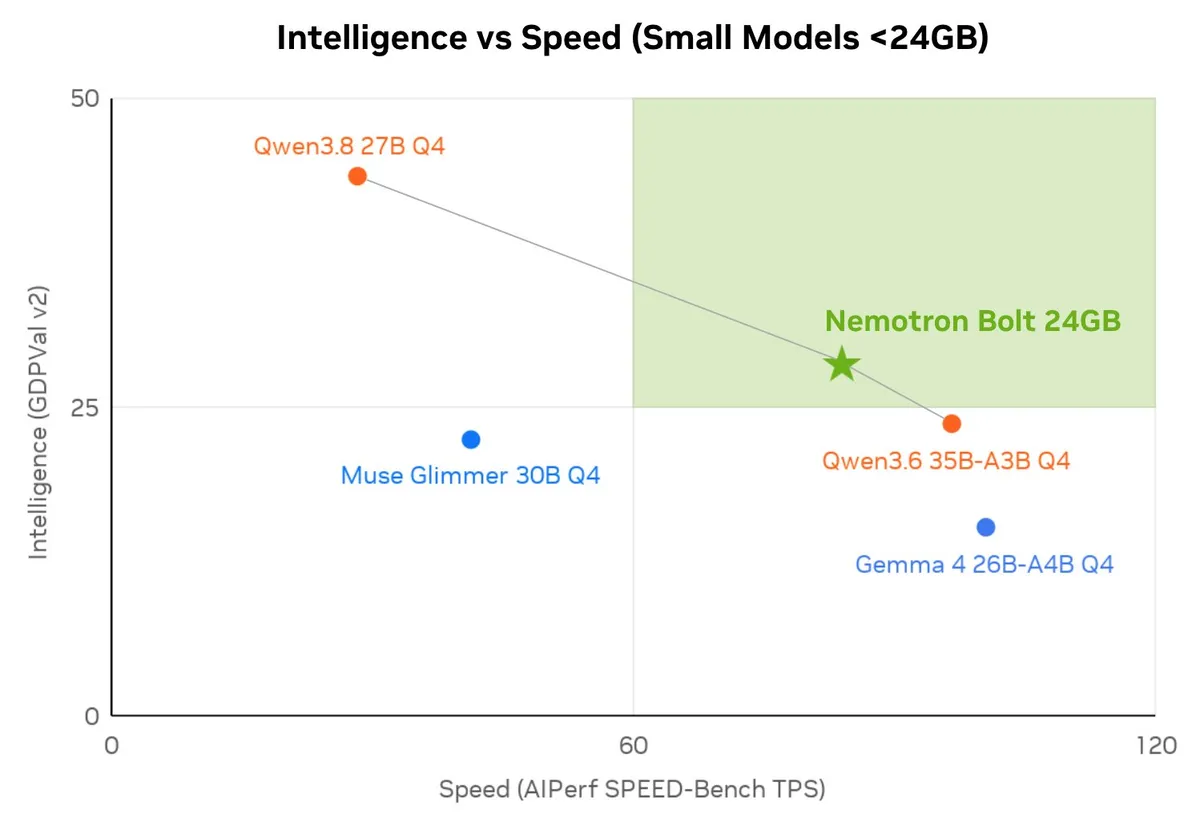
در کنار مدل اصلی، انویدیا دو مدل Bolt را برای سختافزارهای محلی عرضه کرد که ادعا میشود «بیشترین هوش را در هر گیگابایت حافظه» ارائه میدهند.
- Nemotron 3.5 Bolt 74B-A9B 24GB: یک مدل MoE ترکیبی که تنها ۹ میلیارد از ۷۴ میلیارد پارامتر آن در هر گام فعال است. برای جایگیری در ۲۴ گیگابایت حافظه، انویدیا از کوانتایزیشن (Quantization) شدید ۲ بیتی روی وزنها استفاده کرده است. این مدل برای تراشه لپتاپ RTX Spark و ایستگاههای کاری DGX Spark (که تا ۱۲۸ گیگابایت حافظه مشترک دارند) بهینه شده است. همچنین از PCهای GeForce RTX، ایستگاههای DGX، ورکاستیشنهای RTX PRO و چارچوبهایی مثل Ollama، llama.cpp، vLLM و LM Studio پشتیبانی میکند.
- Bolt E4B 4GB: مدلی کوچکتر برای دستیارهای صوتی سریع، شخصیتهای تعاملی و رابطهای دستگاهی که برای انتشار در اواخر اکتبر برنامهریزی شده است. این مدل برای ماژولهای Jetson، کارتهای GeForce RTX و RTX/DGX Spark طراحی شده و میتواند گفتگوهای طبیعی را در چندین نوبت (Turn) در حالی که از اپلیکیشن فعال آگاه است، پیش ببرد.
انویدیا اذعان دارد که ۲۴ گیگابایت حافظه برای اکثر مصرفکنندگان معیار بالایی است، بنابراین مدل Bolt 74B فعلاً برای توسعهدهندگان و مالکان ایستگاههای کاری ردهبالا هدفگذاری شده است.
پذیرش در دنیای واقعی
چندین سازمان در حال حاضر Super VL را برای حجمهای کاری حساس و مستند-محور مستقر کردهاند. انویدیا اشاره میکند که این مدل برای شرکتهای بیمه (جهت غربالگری ادعاهای خسارت برای شناسایی تقلب) و مؤسسات مالی (برای امتیازدهی اعتبار بر اساس معیارهای اختصاصی) بسیار جذاب است.
- مالی و رسانه: شرکت Scale AI این مدل را برای Skydance بهینه کرد تا اعتبارات تامینکنندگان را مدیریت کند؛ با پیشبینی اینکه هزینهها به یکچهلام و زمان پاسخ به یکپنجم برسد. Ramp از آن برای تبدیل عکس رسیدها به دادههای ساختاریافته استفاده میکند تا پاسخها ۱۰ برابر سریعتر شوند. EY برای بررسیهای پیش از تصاحب (Due Diligence) و Hebbia برای قراردادهای اعتباری از آن بهره میبرند.
- امنیت سایبری: شرکت AI21 مدل را برای تحلیل تهدیدات شرکت Alice تنظیم کرد که منجر به بهبود ۴۰ درصدی دقت شد. Dream برای شکار حفرههای امنیتی و CrowdStrike برای ساخت عاملهایی جهت دفاع از شبکههای سازمانی از آن استفاده میکنند.
- سایر پذیرندگان: Salesforce در حال خودکارسازی گردشکارهای دولتی است، R1 از آن برای حسابرسی صورتحسابهای پزشکی استفاده میکند و شرکتهایی مثل Perplexity، Mercor و Dassault Systèmes نیز در حال بهرهبرداری از این مدل هستند.
دسترسی جهانی و باز بودن
انویدیا نهتنها وزنها، بلکه مجموعهدادهها و دستورالعملهای آموزش را نیز منتشر میکند. این شامل یک نسخه پایه، یک نسخه پسآموزشدیده و یک نسخه فشرده ۴ بیتی، به همراه محیطهای یادگیری تقویتشده (RL) است. این مدل در مرحله پیشآموزش و پیشآموزش مستمر روی بیش از ۲۵ تریلیون توکن آموزش دیده و در مرحله پسآموزش، حدود ۴ میلیون نمونه در ۱۰۰ محیط آموزشی باز به آن اضافه شده است.
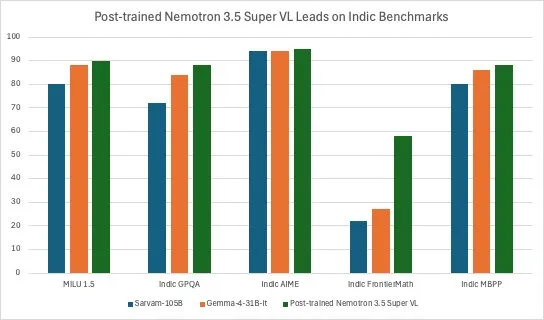
در Hugging Face، مجموعهدادههایی برای استفاده از ابزار، دنبال کردن دستورات، مدیریت متون طولانی، درک تصویر، ایمنی و عدالت منتشر میشود. همچنین یک مجموعهداده عظیم برای زبانهای هندی شامل ۲.۸۳ تریلیون توکن در ۲۲ زبان، با همکاری IIT Madras و AI4Bharat ارائه شده است. Super VL پس از تنظیم با این دادهها، در محکهای زبانهای هندی از مدلهای تخصصی بزرگتری مثل Sarvam-105B پیشی میگیرد.
استراتژی سختافزاری
اگرچه مدلها باز هستند، اما بهدقت برای سختافزار انویدیا بهینه شدهاند. Super VL روی سیستمهای دسکتاپ مثل DGX Spark، DGX Station، RTX PRO و RTX و همچنین ماژولهای Jetson در دستگاههای لبه اجرا میشود. از طریق Nvidia NIM، شرکتها میتوانند مدل را بهعنوان یک میکروسرویس با پیکربندیهای تأییدشده و بهروزرسانیهای هر دو هفته یکبار مستقر کنند.
این استراتژی تضمین میکند که با پذیرش مدلهای باز توسط شرکتها، تقاضا برای زیرساختهای انویدیا رشد کند. با ارائه نرمافزار، انویدیا تسلط تراشههای خود را در برابر رقبایی مثل گوگل، متا، Anthropic یا OpenAI که در حال ساخت سیلیکونهای خود هستند، تضمین میکند. برای تقویت این اکوسیستم، انویدیا اخیراً ۱۲.۹ میلیارد دلار در Hugging Face سرمایهگذاری کرد.
برای مشاهده عملکرد این مدلها در گردشکار خاص خود، میتوانید به وزنهای Nemotron 3.5 Super VL 120B-A12B و Nemotron 3.5 Bolt 74B-A9B 24GB در Hugging Face دسترسی پیدا کنید یا آنها را از طریق Nvidia NIM مستقر نمایید.
گام بعدی شما
- اگر توسعهدهنده هستید، وزنهای Nemotron 3.5 Super VL را در Hugging Face بررسی کنید تا توازن بین سرعت و دقت را در پروژه خود بسنجید.
- برای کاهش هزینههای استنتاج در محیطهای سازمانی، استقرار مدل از طریق Nvidia NIM را جایگزین APIهای بسته کنید.
- قابلیتهای تحلیل PDF و نمودار مدل را در گردشکارهای تحلیل دادههای مالی تست کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو