
تصور کنید یک برنامهنویس بخواهد بدون پرداخت هزینه API و بدون ارسال دادههای حساس شرکتش به سرورهای خارجی، یک مدل قدرتمند را روی لپتاپش اجرا کند. اکنون این کار بهجای نیاز به تجهیزات آزمایشگاهی، تنها با یک دستور ساده در ترمینال ممکن است.
اولاما (Ollama) استنتاج مدلهای زبانی بزرگ را به تجربهای شبیه به نصب یک بسته نرمافزاری تبدیل کرده است. این ابزار بهطور موثری نیاز به مدیریت دستی فایلهای GGUF یا تنظیمات پیچیده پرچمهای CUDA را از بین برده است. کافی است عبارت ollama run qwen3:8b را تایپ کنید، چند دقیقه برای دانلود منتظر بمانید و سپس یک مدل محلی داشته باشید که روی دستگاه شما به سوالات پاسخ میدهد، در حالی که هیچ دادهای از سیستم خارج نمیشود.
این تحول در حالی رخ میدهد که فناوری کوانتیزاسیون (Quantization) — شبیه به فشردهسازی یک فایل حجیم برای جا شدن در فلشمموری بدون از دست دادن کیفیت اصلی — به بلوغ رسیده است. این پیشرفت اجازه میدهد مدلهای توانمند در حافظه رم ۸ تا ۱۶ گیگابایتی با سرعت قابلقبول اجرا شوند. در حالی که ما پیشتر بررسی کردیم که سیستمهای تخصصی مانند GenRec نتفلیکس چگونه منطق توصیهگر را بهینه میکنند، اولاما بر نقطه مقابل این طیف تمرکز دارد: در دسترس قرار دادن مدلهای وزنبازِ همهمنظوره برای همه. اولاما مانع ورود به این حوزه را از دانش عمیق سیستمها به یک دستور ساده در ترمینال و یک فایل DMG تغییر داده است.
مقیاس پذیرش محلی
به نقل از دادههای ذکر شده در گزارشی در medium.com، اولاما در سه ماهه اول سال ۲۰۲۶ به ۵۲ میلیون دانلود ماهانه رسید. این رقم نشاندهنده رشد خیرهکننده ۵۲۰ برابری نسبت به ۱۰۰ هزار دانلود ماهانه است که در سه ماهه اول ۲۰۲۳ ثبت شده بود. این روند بازتابدهنده یک گرایش گستردهتر در اکوسیستم مدلهای وزنباز است؛ بهطوری که پلتفرم هاگینگ فیس (Hugging Face) اکنون میزبان بیش از ۱۳۵ هزار مدل با فرمت GGUF است و پروژه زیربنایی لاماسیپلاسپلاس (llama.cpp) از ۷۳ هزار ستاره در گیتهاب عبور کرده است.
این مسیر نشان میدهد که استنتاج محلی از یک سرگرمی برای علاقهمندان، به زیرساختی واقعی تبدیل شده است که توسعهدهندگان روی آن محصول میسازند. سادگی راهاندازی محرک اصلی است؛ یکی از متخصصانی که اولاما را روی مک مینی اجرا کرده، توصیف میکند که مدل در بازه زمانی بسیار کوتاهی «فعال شد، پاسخ داد و مانند یک چتبات رفتار کرد» و اشاره میکند که خودِ فرآیند نصب هرگز بخش سخت ماجرا نبوده است. در همین راستا، برخی توسعهدهندگان توانستهاند با ترکیب مکمینی و مدل Qwen، جایگزینی اقتصادی و محلی برای ابزارهایی مانند گیتهاب کوپایلت ایجاد کنند.
سازوکار فنی
اولاما بهعنوان یک محیط اجرای متنباز بر بستر llama.cpp عمل میکند و چندین مرحله پیچیده را در یک رابط واحد بستهبندی میکند:
- مدیریت خودکار: دانلود مدل، کوانتیزاسیون و شتابدهی سختافزاری را بهصورت خودکار مدیریت میکند؛ در واقع مانند pip یا Homebrew برای مدلهای هوش مصنوعی عمل میکند.
- API استاندارد: یک سرور محلی روی پورت ۱۱۴۳۴ اجرا میکند و نقاط انتهایی (Endpoints) سازگار با OpenAI را تحت مسیر
/v1/ارائه میدهد. این یعنی هر ابزاری که برای OpenAI طراحی شده، میتواند بهجای ابر، به یک لپتاپ محلی اشاره کند. - استقرار سریع: یک کاربر تازهکار میتواند در حدود ۲۰ دقیقه از مرحله نصب به داشتن یک چتبات پاسخگو برسد.
بر اساس مستندات وبلاگ رسمی ollama.com، بهروزرسانیهای اخیر شامل افزودن مدل Nemotron 3.5 Lightning انویدیا (یک مدل ۳۰ میلیارد پارامتری) و دستور جدید ollama launch است. این دستور به توسعهدهندگان اجازه میدهد ابزارهای کدنویسی مانند Claude Code، OpenCode یا Codex را بدون ویرایش دستی متغیرهای محیطی به مدلهای محلی یا ابری متصل کنند. این امر اولاما را نه فقط به عنوان یک اجراکننده چتبات، بلکه به عنوان لولهکشی زیرساختی تبدیل میکند که ابزارهای کدنویسی عاملمحور (Agentic) به آن متصل میشوند.
کاربردهای عملی و کاهش هزینهها
متخصصان از این ابزار در سناریوهای خاص و با ارزش بالایی استفاده میکنند که در آنها APIهای ابری یا شکست میخورند یا بیش از حد گران هستند.
نمونهسازی و مقایسه: کاربران میتوانند سه یا چهار مدل کاندید مانند Qwen3، Gemma 3 یا نسخههای distill شده از DeepSeek R1 را دریافت کرده و در یک بعدازظهر، آنها را روی تسکهای واقعی A/B تست کنند. این کار بدون نیاز به کلید API، بدون داشبوردهای پرداخت و بدون درگیر شدن با محدودیتهای نرخ درخواست (Rate Limits) انجام میشود.
حریم خصوصی و امنیت: حریم خصوصی محرک اصلی است. برای حوزههای حقوقی، پزشکی یا ابزارهای داخلی شرکتها، ماهیت ایزوله (Air-gapped) اولاما تضمین میکند که هیچ تلهمتری یا دادهای درباره آنچه اجرا یا پرسیده میشود، ارسال نگردد. یک تجربه ۳۰ روزه از قطع ChatGPT نشان داد که پیش از کوچ به مدلهای محلی، چه مقدار از جزئیات پروژههای مشتریان و تکههای کد منبع بهطور اتفاقی در پنجرههای ابری کپی شده بود.
کار آفلاین و دستهای: پس از دریافت وزنها، اولاما به هیچ اتصال شبکهای نیاز ندارد و برای محیطهای امن یا استقرار در میدان ایدهآل است. همچنین در پردازشهای حجیم و کمریسک عالی عمل میکند. یک آزمایش نشان داد که بازنویسی ۶۰ توصیف محصول از طریق API محلی در آدرس http://localhost:11434 تنها ۸ دقیقه زمان برد. این کار باعث اجتناب از هزینهای تخمینی بین ۳ تا ۴ دلار و همچنین حذف مشکل کند شدن سرعت (Throttling) شد که در سرویسهای ابری رایج است.
آنبوردینگ: بهدلیل نبود نیاز به حساب کاربری، کد فعالسازی یا صورتحساب ماهانه، اولاما برای ارائه یک محیط هوش مصنوعی آماده به افرادی که برنامهنویس نیستند، در قالب یک راهنمای ساده (Walkthrough) استفاده میشود.
مرزهای تولید (Production)
با وجود محبوبیت، اولاما سقفهای فنی مشخصی دارد. این ابزار یک محیط اجرای تکگره (Single-node) است، نه یک پشته سرویسدهی صنعتی. اولاما فاقد صف درخواست (Request Queueing)، مقیاسدهی خودکار (Autoscaling) و جداسازی کاربران (Multi-tenant isolation) است که در چارچوبهایی مثل vLLM یا TensorRT-LLM دیده میشود. اولاما نمیتواند بار کاری را بین چندین GPU در یک کلاستر توزیع کند؛ اگر بخواهید به صدها کاربر همزمان سرویس دهید، از توان ارکستراسیون اولاما فراتر خواهید رفت.
مدیریت پنجره زمینه (Context Window) نقطه ضعف بحرانی دیگر است. طبق تجربه یکی از متخصصان در richardgolian.com، وقتی یک مدل محلی با دادههای حجیم SEO مواجه شد، بهجای ترکیب سیگنالها در کل مجموعه داده، صرفاً «یک عدد را از جایی در دادهها برداشت و تکرار کرد». مدل آنچه را که در پنجره زمینه جا میشد پردازش کرد و بقیه را بهطور بیصدا نادیده گرفت.
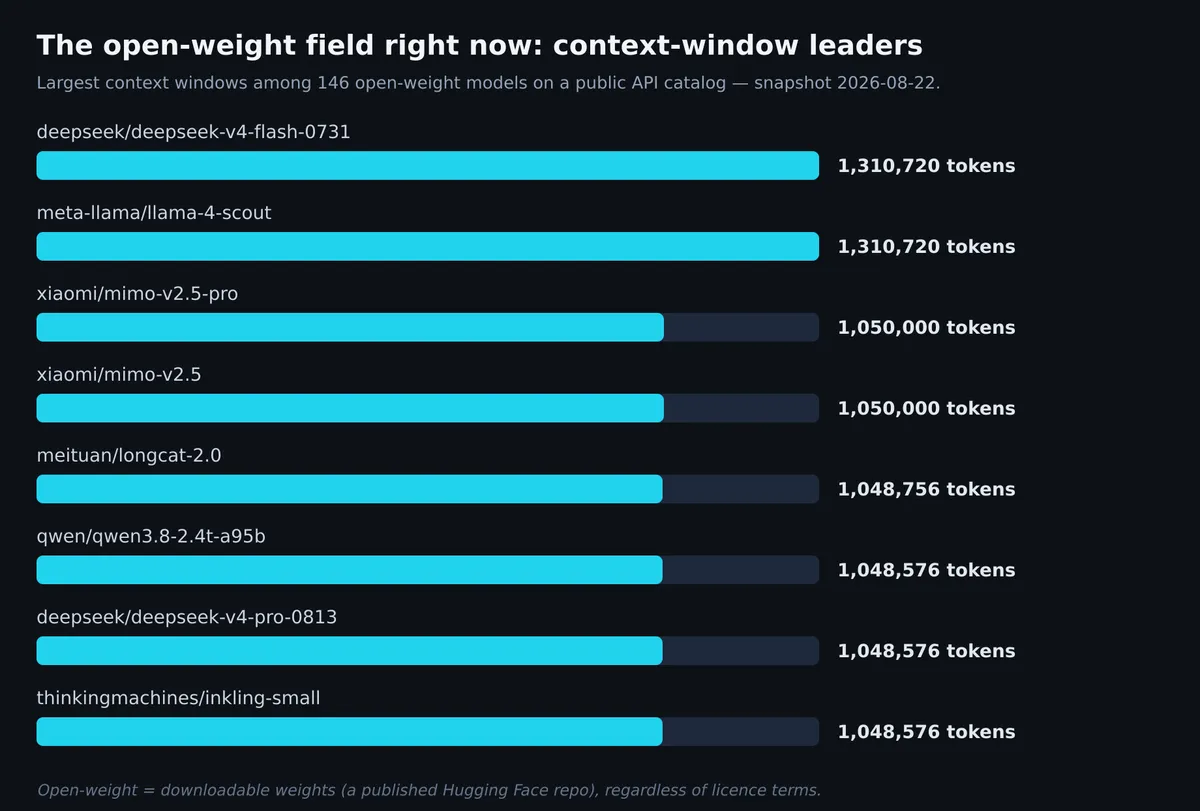
این حالت شکست خطرناک است چون خروجیهایی با اعتمادبهنفس اما غلط تولید میکند که ساختاریافته به نظر میرسند. در حالی که برخی معماریها در تئوری ادعای پنجره متنی ۱۰ میلیون توکنی دارند، در واقعیت هیچ سختافزار محلیای وجود ندارد که بتواند چنین حجمی را در عمل اجرا کند.
استراتژی ترکیبی
استاندارد جدید صنعت، یک استراتژی مسیریابی ترکیبی (Hybrid Routing) است. کاربران بخش عمده کارهای روزمره و کمریسک را بهصورت محلی اجرا میکنند و مدلهای پیشرو (Frontier) ابری را برای استدلالهای پیچیده رزرو میکنند. یک آزمایش ۳۰ روزه نشان داد که کاربر تنها ۳ تا ۴ بار در هفته نیاز داشت به مدل ابری سوییچ کند، در حالی که پیش از این وابستگی او به ابر دائمی بود.
تحلیل هزینهها نشان میدهد که استراتژی ترکیبی محلی-ابری در حجم بالای درخواست، تنها ۱۱ تا ۲۰ درصد هزینه یک سیستم تمامابری دارد. این یعنی اولاما برای جایگزینی قدرتمندترین مدلها طراحی نشده است، بلکه هدفش جذب ۷۰ تا ۸۰ درصد درخواستهایی است که نیاز به هوش سطح اول ندارند.
برای تبدیل یک پاسخ ترمینال به اپلیکیشن کامل، کاربران معمولاً اولاما را با Open WebUI برای داشتن رابطی شبیه به ChatGPT یا لایههای ارکستراسیونی مثل n8n برای ایجاد خط لولههای پردازشی (Pipelines) ترکیب میکنند. در واقع، ترکیب n8n و اولاما امکان ساخت گردشکارهای هوشمند و خصوصی را فراهم میکند که در مقایسه با سرویسهای ابری، کنترل کاملتری بر دادهها ارائه میدهد.
گام بعدی شما
- اگر از مک یا لینوکس استفاده میکنید، اولاما را نصب کنید و مدل Qwen3 یا Gemma 3 را برای تسکهای ساده کدنویسی تست کنید.
- برای کاهش هزینههای API، گردشکارهای تکراری و حجیم خود را به API محلی اولاما منتقل کنید.
- برای ایجاد رابط کاربری گرافیکی، Open WebUI را روی داکر نصب کرده و به اولاما متصل کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell و بهینهسازی استنتاج مراجعه کنید.



گفتگو