
اگر به دنبال مدلی هستید که تفاوت میان یک توصیف دقیق و یک تکرار مکانیکی را بفهمد، باید نگاهی به معماریهای هیبریدی بیندازید. این مدلها در حال شکستن انحصار ترنسفورمرها در پیشبینی توکنهای دارای بار معنایی هستند.
طبق تحلیل فنی منتشرشده در ۲۵ ژوئن ۲۰۲۶ (arXiv:2606.20936)، مقایسهای جامع میان Olmo Hybrid و مدل ترنسفورمر-محور Olmo 3 نشان میدهد که برتری مدل ترکیبی به شدت به نوع اطلاعات پردازششده وابسته است. برای سالها، معماری ترنسفورمر (Transformer) به دلیل مکانیسم توجه (Attention) استاندارد صنعت بوده است. این مکانیسم اجازه میدهد مدل با دقت کامل به هر توکن قبلی نگاه کند. در این ساختار، هر لایه از توجه استفاده میکند تا وزن مربوط به میزان مرتبط بودن هر توکن قدیمی با پیشبینی فعلی را محاسبه کند. اما این قدرت، هزینهی محاسباتی سنگینی دارد؛ زیرا با افزایش طول ورودی، پیچیدگی افزایش مییابد چون هر توکن باید با تمام توکنهای قبلی مقایسه شود. علاوه بر این، اگرچه توجه در بازیابی و تجمیع اطلاعات بسیار قوی است، اما در نمایش اطلاعاتی که به صورت متوالی در طول زمان تکامل مییابند، دچار مشکل میشود.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی حافظهی مدلها اشاره کردیم، مدلهای هیبریدی تلاش میکنند یک راه میانه پیدا کنند. آنها این کار را با حفظ تعداد کمی از لایههای توجه و جایگزینی مابقی لایهها با لایههای بازگشتی (Recurrent Layers) انجام میدهند. برخلاف لایه توجه، یک لایه بازگشتی توکنها را از چپ به راست میخواند و یک حافظه با اندازه ثابت را حمل میکند. این لایه هر توکن جدید را در حین پیشروی در حافظه ادغام میکند، که تضمین میکند هزینه پردازش هر توکن، فارغ از طول ورودی، ثابت و مسطح باقی بماند. با این حال، این حافظه فشرده و گمشونده (Lossy) است؛ این بدان معناست که لایههای بازگشتی نمیتوانند مانند مکانیسم توجه، دقیقاً به یک توکن خاص از گذشته با دقت کامل دسترسی پیدا کنند، اما در عوض برای نگه داشتن یک گزارش جاری از اطلاعات در حال تغییر بسیار مناسبتر هستند.
به گزارش این مطالعه، دو مدل ۷ میلیارد پارامتری به گونهای ساخته شدند که در تمام ابعاد خارج از معماری، تا حد ممکن مشابه باشند. آنها در حجم و نوع دادهها، توکنساز (Tokenizer) و دستورالعملهای آموزش (Training Recipes) کاملاً با یکدیگر مطابقت داشتند. این محیط کنترلشده تضمین میکند که تفاوتهای مشاهدهشده در عملکرد، نتیجه مستقیم خود معماریها است و نه ناشی از نابرابریهای احتمالی در فرآیند آموزش. برای جداسازی این نقاط قوت و ضعف، تیم تحقیق هر دو مدل را با متون متنوعی تغذیه کردند که شامل مدخلات ویکیپدیا، کتابها، مقالات علمی، متون خبری و متون ساختاریافته مانند کدهای پایتون، HTML و LaTeX بود.
برتری در کلمات محتوایی
بر اساس مستندات، خیرهکنندهترین یافته این است که Olmo Hybrid در پیشبینی «کلمات محتوایی» — یعنی اسمها، فعلها و صفتهایی که حامل معنا هستند و تعریف میکنند یک جمله درباره چه چیزی است — بهطور قابلتوجهی بهتر عمل میکند. پژوهشگران برای سنجش این موضوع از «شکاف زیان» (Loss Gap) استفاده کردند؛ یعنی تفاوتی که در میزان خطای پیشبینی میان دو مدل وجود دارد. در این تحلیل، یک شکاف مثبت نشاندهنده این است که مدل هیبریدی توکن بعدی واقعی را با دقت بیشتری پیشبینی کرده است.
- کلمات محتوایی: مدل هیبریدی در این توکنها شکاف زیانی در حدود ۰.۰۴ را نشان داد.
- کلمات تابعی: برای توکنهای دستوری مانند «the»، «of» و «is»، این شکاف کاهش یافت و به حدود ۰.۰۲ رسید.
- دستههای تخصصی: برتری مدل هیبریدی بهویژه در پیشبینی قیدها و صفتها بسیار چشمگیرتر بود.
- وجودهای دستوری: برخی دستههای کلمات تابعی، مانند کلمه «there»، نیز برتری قابلتوجهی را برای مدل هیبریدی نشان دادند.
به زبان ساده، لبهی رقابتی مدل هیبریدی در کلماتی است که معنا منتقل میکنند و کمترین برتری را در کلمات دستوری دارد که هر مدلی میتواند آنها را تقریباً از روی قواعد نحوی (Syntax) حدس بزند. تیم تحقیق برای اطمینان از اینکه این نتایج به دلیل نادر بودن برخی دستهها یا تکرار توکنها منحرف نشدهاند، این الگوها را با استفاده از یک تحلیل رگرسیون که در آن سایر عوامل ثابت نگه داشته شده بود، تایید کردند.
نقاط پیروزی ترنسفورمرها
برتری مدل هیبریدی در دو سناریوی خاص بهطور کامل از بین میرود: تکرار واژه به واژه (Verbatim Repetition) و تطبیق ساختاری. وقتی یک توکن صرفاً توالی متنی را تکرار میکند که پیشتر در ورودی حضور داشته است — که به عنوان n-grams تکراری شناسایی میشوند — برتری مدل هیبریدی به صفر نزدیک میشود. در واقع، هرچه طول بخش تکراری متن بیشتر شود، فاصله عملکردی مدل هیبریدی با ترنسفورمر کمتر میشود.
دلیل این اتفاق این است که حافظه در لایههای بازگشتی فشرده است؛ بنابراین آنها نمیتوانند مانند مکانیسم توجه ترنسفورمر، برای یافتن یک توکن دقیق و واژه به واژه، بهطور بهینه «به عقب بازگردند». قدرت ترنسفورمر دقیقاً در جایی است که پاسخ درست «همینجاست و فقط باید به آن نگاه کرد».
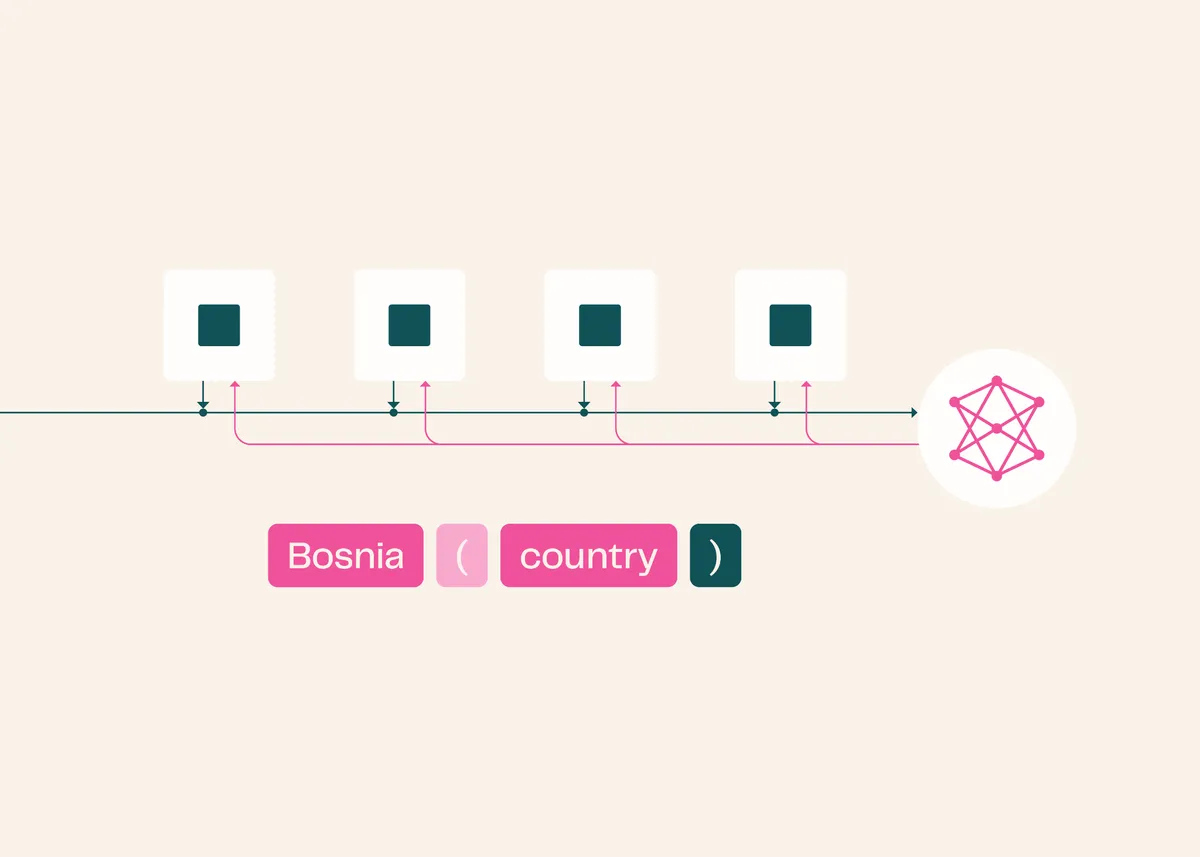
نقطه شکست دیگر برای مدل هیبریدی، پیشبینی براکتهای پایانی (Closing Braces) بود. در حالی که مدل هیبریدی در مدیریت براکتهای شروع مشکلی نداشت، اما وقتی نوبت به بستن براکت میرسید، برتریاش از بین میرفت. این الگو در تمامی زبانهای طبیعی، کدهای برنامهنویسی و زبانهای مارکآپ مشاهده شد. از آنجایی که مکانیسم توجه برای نمایش تطبیق براکتها (Bracket Matching) شناخته شده و کافی است، این یافته نشان میدهد که توجه به تنهایی برای پیشبینی براکتهای پایانی کفایت میکند.
آزمایش در مقیاس بزرگ
برای اعتبارسنجی این یافتهها و بررسی اینکه این تفاوتها چگونه در طول آموزش ظاهر میشوند، تیم تحقیق نسخههای ۱ میلیارد پارامتری از سه معماری مختلف را مورد آزمایش قرار داد: یک ترنسفورمر خالص، یک مدل هیبریدی و یک شبکه عصبی بازگشتی (RNN) خالص که هیچ لایه توجهی نداشت. آنها منحنیهای زیان توکن را در نقاط بازرسی (Checkpoints) که با روش WSD-annealed بهینه شده بودند، تحلیل کردند.
- توکنهای معنادار: در کلمات محتوایی که تکراری نبودند، هم مدل هیبریدی و هم RNN خالص از ترنسفورمر پیشی گرفتند. در این دسته، مدل هیبریدی در مجموع بهترین عملکرد را داشت.
- توکنهای تکراری: مدل RNN خالص از هر دو مدل ترنسفورمر و هیبریدی عقب ماند، زیرا هیچ مکانیسم توجهی برای تسهیل فرآیند کپیبرداری از متون قبلی نداشت.
- عملکرد کلی: این تحلیلهای تفکیکشده (Filtered Token Losses) تفاوتهای ظریفی را در توانایی کپیبرداری و پردازش کلمات محتوایی آشکار کرد که در غیر این صورت، در یک معیار استاندارد «میانگین زیان» (Average Loss) نامرئی میماندند.
این دادهها تایید میکند که یک «میانگین زیان» واحد — یعنی خطای متوسط مدل در تمامی توکنها — برای مقایسه معماریها بیش از حد کلی و غیردقیق است. توسعهدهندگان با استفاده از زیانهای تفکیکشده میتوانند دقیقاً تشخیص دهند مدل در کجا شکست میخورد؛ برای مثال آیا مشکل از استدلال منطقی است یا ناتوانی در بازیابی حافظه.
پیامدهای معماری مدل
از دیدگاه فنی، این جابجایی نحوه بنچمارک پیشآموزش (Pretraining) را تغییر میدهد. ما در حال حرکت از امتیازات کلنگر به سمت منحنیهای زیان «قابلیت-محور» (Capability-specific) هستیم. لایههای بازگشتی در مدلهای هیبریدی، گزارشی جاری از اطلاعات در حال تکامل ارائه میدهند و قابلیتهای ردیابی وضعیت (State-tracking) را فراهم میکنند که بهویژه برای توکنهای کلاس-باز (Open-class tokens) مفید است.
اگر هدف ساخت مدلی است که ظرافتهای زبانی و بسترهای متغیر در طول متن را بفهمد، مسیر بهینهسازی به سمت هیبریدیت است. اما اگر هدف بازیابی کامل اطلاعات و پایبندی سختگیرانه به ساختارهای صلب است، مکانیسم توجه همچنان پادشاه است. پژوهشگران معتقدند بهترین معماریهای هیبریدی از طریق درک دقیق توکن-به-توکن از اینکه هر مؤلفه چه کاری را بهخوبی انجام میدهد، ظهور خواهند کرد. نسل بعدی مدلها احتمالاً ترکیبی آگاهانه خواهند بود که برای ایجاد تعادل میان این دو قدرت متضاد تنظیم شدهاند.
برای مشاهده عملی این تفاوتهای معماری، پژوهشگران جامعه هوش مصنوعی را تشویق میکنند تا آرتیفکتهای باز Olmo 3 و Olmo Hybrid را بررسی کرده و ارزیابیهای زیان تفکیکشده را در آزمایشهای پیشآموزش خود به کار بگیرند.
گام بعدی شما
- اگر در حال آموزش مدل هستید، بهجای تکیه بر Average Loss، از Filtered Token Loss برای شناسایی نقاط کور مدل در کپیبرداری یا استدلال استفاده کنید.
- آرتیفکتهای باز Olmo 3 و Olmo Hybrid را بررسی کنید تا تاثیر لایههای بازگشتی بر توکنهای معنادار را در دادههای خود ببینید.
اما تاثیر این معماریها بر هزینه استنتاج در مقیاس میلیاردها کاربر، ابعاد متفاوتی دارد — به تحلیل ما دربارهی بهینهسازیهای KV Cache مراجعه کنید.



گفتگو