اگر امروز برای هر درخواست از مدلهای پیشرو هزینه میپردازید، باید بدانید که مالکیت مدلهای کوچک و تخصصی میتواند صورتحساب شما را تا ۹۸ درصد کاهش دهد. این یعنی عبور از عصر «اجاره هوش» و ورود به دوران «مالکیت تخصص».
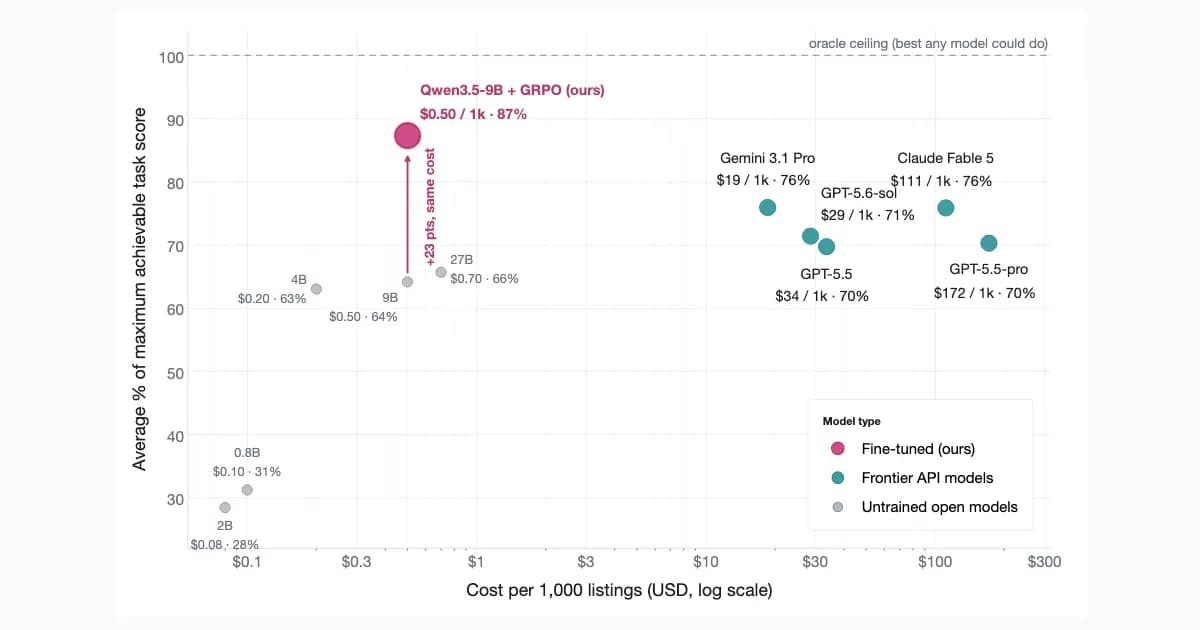
بر اساس گزارش fermisense.com در ۲۸ ژوئیه ۲۰۲۶، یک مدل متنباز ۹ میلیارد پارامتری که بهصورت تخصصی تنظیم شده، در گردشکار بررسی کاتالوگ محصولات، تمامی پیکربندیهای مدلهای پیشرو را شکست داد. این مدل تنها ۰.۵۰ دلار برای هر ۱۰۰۰ مورد هزینه داشت؛ یعنی ۶۸ برابر ارزانتر از قدرتمندترین مدل موجود. مدل ۹ میلیارد پارامتری به ۸۷.۳٪ از حداکثر امتیاز ممکن رسید، در حالی که بهترین مدل پیشرو تنها ۷۶.۹٪ موفق بود. این یعنی بهبود ۱۳.۵ درصدی نسبی نسبت به غولهای هوش مصنوعی و ۳۶ درصد پیشرفت نسبت به نسخه آموزشندیده خودش که امتیاز ۶۴.۲٪ داشت.
برای سالها، مدیران کسبوکار با هوش مصنوعی مثل یک ابزار آماده برای خلاصهسازی ایمیلها یا پیشنویس اسناد برخورد کردند. اما اکثر سازمانها نتوانستند این بردها به بازگشت سرمایه (ROI) قابل اندازهگیری تبدیل کنند، چون مدلها را بدون بازطراحی فرآیندها، درون گردشکارهای قدیمی ریختند. این رویکرد تکهتکهوار باعث شده تا بسیاری از سازمانها در رسیدن به نتایج عملیاتی شکست بخورند، همانطور که برخی مطالعات نشان میدهند بخش بزرگی از پروژههای هوش مصنوعی سازمانی بهدلیل شکافهای ساختاری با شکست مواجه میشوند. دادههای پلتفرم هزینه شرکتی Ramp تضاد شدیدی را بین نوامبر ۲۰۲۲ و دسامبر ۲۰۲۵ نشان میدهد: شرکتهایی که در ردهی یکچهارم بالای مصرفکنندگان AI بودند، شاهد بیش از دو برابر شدن درآمدهای خود بودند، در حالی که کسبوکارهایی با هزینه صفر برای AI تنها ۱۵ درصد رشد کردند. در همین بازه زمانی سه ساله، پذیرندگان سنگین AI هشت برابر بیشتر رشد کردند.
همانطور که در تحلیل قبلی ما دربارهی بهرهوری سختافزاری در بیومتریک با حجم بالا اشاره کردیم (که در آن سختافزار و نرمافزارهای تخصصی باعث ایجاد بهرهوری دائمی شدند)، اکنون همین منطق «بهینهسازی تخصصی» به کارهای شناختی رسیده است. برندگان این رقابت دیگر وقت خود را تلف مهندسی پرامپت (Prompt Engineering) — که شبیه هنر سؤال درست پرسیدن از یک مشاور است تا بهترین جواب را بگیرد — نمیکنند. آنها بهجای پرداخت «مالیات پرامپت» در هر درخواست، منطق تجاری اختصاصی خود را مستقیماً در وزنهای مدل میبافند. این تغییر استراتژیک در واقع گذاری است به سمت جایگزینی منطق سنتی کسبوکار با جریانهای کاری هوش مصنوعی تا بهرهوری به بخشی جداییناپذیر از ساختار سازمان تبدیل شود.
چرا اکثر استقرارهای AI مقیاس نمیگیرند؟
تحقیقات به پنج دلیل اصلی اشاره میکنند که چرا شرکتها در دیدن بازگشت سرمایه شکست میخورند. نخست، عدم بازطراحی فرآیندها است. بسیاری مدل را در گردشکاری میگذارند که برای انسان ساخته شده و گلوگاههای قدیمی (Legacy Bottlenecks)، بهرهوری را میبلعند. در نظرسنجی ۲۰۲۵ مککینزی، بازطراحی گردشکار ویژگیای بود که بیشترین همبستگی را با تأثیر بر EBIT (سود قبل از بهره و مالیات) داشت، اما تنها ۲۱٪ سازمانها واقعاً هرگونه گردشکاری را بازطراحی کرده بودند.
دوم، نبود انگیزه برای آزمایش است. ابزارها و بهترین روشها (Best Practices) هر هفته تغییر میکنند، اما بسیاری از تیمها بهجای گزارش اینکه چه چیزی شکست خورد، برای «تحویل دادن و ارسال» پاداش میگیرند. تیمهای فنی اغلب بهترین نقطه شروع هستند زیرا مشکلات تکراری را در عملکردهای مختلف تجاری میبینند و میتوانند شناسایی کنند که مدل واقعاً میتواند کدام یک را بر عهده بگیرد.
سوم، ارائه بستر تجاری سفارشی از طریق مهندسی پرامپت، خودش یک برنامه مهندسی پیچیده است. این شامل دسترسی به دادههای خام، اعمال کنترلهای دسترسی سختگیرانه بر آنچه هر درخواست میتواند ببیند و ساخت سامانههای بازیابی (Retrieval Systems) است که شواهد درست را استخراج کنند. علاوه بر این، تیمها باید پنجرههای متنی (Context Windows) را مدیریت کنند که مدلها با افزایش اندازه، اغلب بهطور نامساوی از آنها استفاده میکنند.
در نهایت، بسیاری از شرکتها در اندازهگیری درست میزان استفاده و اثرات شکست میخورند. بدون ارزیابیهای امتیازدهیشده روی دادههای اختصاصی، شرکتها به «ارزیابیهای حسی» (Vibe Evaluations) یا گزارشهای نادرست زمانی تکیه میکنند. این نبود زیرساخت برای ردیابی هزینههای تصمیمگیری و عملکرد مدل، دفاع از بودجهها را سخت میکند. طبق نظرسنجی METR در مه ۲۰۲۶، دستاوردهای AI که بهصورت خود-گزارشی اعلام شدهاند، حدود ۴۰ درصد بیشتر از صرفهجوییهای زمانی اندازهگیریشده برآورد شدهاند.
دستورالعمل مدلهای تخصصی
استراتژی نوظهور برای AI با مقیاس بالا از یک دستورالعمل سه مرحلهای خاص پیروی میکند: شروع با یک مدل متنباز، اعمال دادههای تخصصی وظیفه (Task Data) و استفاده از یادگیری تقویتی (RL) در مقابل نسخهای امتیازدهیشده از گردشکار واقعی. این کار باعث میشود مدل معناشناسی خاص محیط شرکت — یعنی تاکسونومی (دستهبندی) منحصربهفرد، تفاوتهای ظریف سیاستها و مجموعهابزارهای آن — را یاد بگیرد.
در این محیط، مدل با ابزارها و دادهها تعامل میکند، یک رابریک (Rubric) یا معیار، خروجی را امتیازدهی میکند و سیگنال پاداش، وزنهای مدل را بهروز میکند. پس از دهها هزار تکرار، قضاوت در وزنها تثبیت میشود، در حالی که حقایق متغیر — مانند قیمتها، موجودی انبار و متن سیاستها — در ابزارها باقی میمانند.
پیشروهای صنعت این الگو را اجرا کردهاند:
- Bridgewater Associates: یکی از بزرگترین صندوقهای پوشک ریسک جهان. تحلیلگران آن مقالات و پروندهها را بررسی میکنند تا مرتبط بودن آنها را بر اساس تز سرمایهگذاری داخلی شرکت بسنجند. چون مهندسی پرامپت نمیتوانست این قضاوت را بهطور قابلاعتمادی جذب کند، شرکت یک مدل متنباز را روی برچسبهای سرمایهگذاران خبره آموزش داد که منجر به ۳۰٪ خطای کمتر نسبت به بهترین مدلهای پیشرو شد.
- Harvey: برای دفاتر حقوقی عامل AI میسازد. dealing با وظایف بلندمدت مانند بررسیهای لازم (Due Diligence) تراکنشها و پیشنویس یادداشتهای حقوقی، نیازمند پیمایش در مجموعههای بزرگ اسنادی است که در آن خطاها روی هم انباشته میشوند. آنها با اجرای RL روی یک مدل وزنباز، یک عامل حقوقی ساختند که در معیارهای داخلی از GPT-5.5 و Claude Opus 4.8 پیشی گرفت.
- Intercom: عامل AI آنها یعنی Fin، تقریباً دو میلیون مسئله را هفتگی حل میکند. در این حجم، اقتصاد واحد (Unit Economics) حیاتی است. آنها با آموزش پسزمینه روی میلیاردها تعامل خدماتی، مسائل بیشتری را با هزینه کمتر از APIهای پیشرو حل کردند.
مطالعه موردی: عامل یکپارچهسازی کاتالوگ
مدیریت کاتالوگ تجارت الکترونیک یک بار عملیاتی عظیم است. هر لیست باید در دسته تاکسونومی درست قرار بگیرد و ویژگیها برای جستوجو و فیلترها بهدقت از تصاویر و توضیحات استخراج شوند. eBay حدود ۲.۵ میلیارد لیست فعال را مدیریت میکند و Shopify روزانه بیش از ۱۰ میلیون بهروزرسانی محصول را پردازش میکند. والمارت اعلام کرده است که انجام کارهای کاتالوگ با کمک AI اگر تنها توسط انسانها انجام میشد، به حدود ۱۰۰ برابر نیروی انسانی بیشتر نیاز داشت. ریسک بالاست: ۷۱٪ خریداران گزارش دادهاند که محصولی را بازگرداندهاند چون با لیست محصول مطابقت نداشته است.
برای آزمایش این موضوع، پژوهشگران یک «همزاد دیجیتال» از پلتفرم تجارت الکترونیک با استفاده از مجموعه داده Amazon Berkeley Objects ساختند. آنها ۱۷۷,۷۶۷ اپیزود بررسی ایجاد کردند که هر کدام شامل یک لیست با تصویر، عنوان، توضیحات، برند ادعا شده و منطقه بود. در این جریان، آنها موارد کنترلشدهی سیاستها، تصاویر نامطابق و ادعاهای متناقض برند را کاشتند تا اطمینان حاصل کنند هر اپیزود پاسخ صحیح مشخصی دارد.
در این همزاد دیجیتال، عامل مانند یک تحلیلگر انسانی عمل میکند و توالی خاصی را دنبال میکند:
۱. search_taxonomy(): پیمایش در حدود ۱۳,۰۰۰ دسته.
۲. lookup_brand(): بررسی اینکه آیا یک برند ثبت شده یا محافظت شده است.
۳. get_attribute_schema(): بازیابی ویژگیهای مورد نیاز برای آن دسته.
۴. تصمیم: ثبت دسته و حکم نهایی.
یک امتیازدهنده هر اپیزود را میسنجد، به خروجیهای درست پاداش میدهد و ویژگیهای پشتیبانینشده یا فراخوانیهای بیهوده ابزار را جریمه میکند. بهطور مشخص، جریمهها اولویتهای تجاری را کدگذاری میکنند: نادیده گرفتن یک تخلف واقعی برای مدل ۷ برابر بیشتر از ایجاد یک هشدار اشتباه هزینه دارد.
در مقایسه با پنج مدل پیشرو — GPT-5.5، GPT-5.6-sol، Gemini 3.1 Pro، Claude Opus 4.8 و Claude Fable 5 — نتایج تکاندهنده بود. آزمایشکنندگان از ۲۰۰ اپیزود اعتبارسنجی طبقهبندیشده استفاده کردند. حتی با دستورالعملهای پرامپت بهینهشده (۲,۸۰۰ کاراکتر شامل کنوانسیونهای استخراج و مثالهای حلشده)، مدلهای پیشرو در سقف ۷۶.۹٪ از حداکثر امتیاز ممکن متوقف شدند و تفاوت آنها با یکدیگر کمتر از یک دهم درصد بود. اما مدل ۹ میلیاردی آموزشدیده با RL به ۸۷.۳٪ رسید.
اقتصاد مالکیت
شکاف عملکرد مهم است، اما شکاف هزینه تحولآفرین است. یک بازارگاه متوسط که روزانه ۱۰ میلیون ویرایش را پردازش میکند، اگر از APIهای پیشرو استفاده کند، سالانه حدود ۵۰۰ میلیون دلار هزینه خواهد کرد. همین حجم کاری اگر توسط یک مدل تخصصی میزبانیشده (Self-hosted) مدیریت شود، هزینه آن تقریباً ۱۰ میلیون دلار خواهد بود؛ یعنی کاهش ۹۸ درصدی هزینه. Shopify این محاسبات را تأیید میکند و محصولات را با مدلهای متنباز تنظیمشده در حجم حدود ۴۰ میلیون استنتاج در روز طبقهبندی میکند؛ حجمی که APIهای تجاری نمیتوانند بهطور اقتصادی پشتیبانی کنند.
این شکاف به این دلیل است که مدلهای پیشرو بهصورت «اجارهای» برای هر فراخوانی هستند. دستورالعملهای بهینه برای این مدلها، صورتحساب توکنهای ورودی را ۲۸ تا ۵۵ درصد در هر فراخوانی افزایش میدهند. در مقابل، دستورات مدل تخصصی در وزنهای آن جای دارد. مدل ۹ میلیاردی آموزشدیده برای هر ۱۰۰۰ لیست ۰.۵۰ دلار هزینه دارد؛ این مبلغ ۴۰ برابر ارزانتر از ارزانترین گزینه پیشرو (Gemini با ۱۹ دلار برای هر ۱۰۰۰ مورد) و ۳۴۰ برابر ارزانتر از گرانترین گزینه (GPT-5.5-pro با ۱۷۲ دلار برای هر ۱۰۰۰ مورد) است.
هزینه آموزش نیز بهطور شگفتآوری پایین است. با استفاده از چارچوب متنباز prime-rl روی دو GPU مدل RTX PRO 6000 (یکی برای تولید خروجیها و یکی برای بهروزرسانی گرادیان)، این عملیات ۳.۵ روز زمان برد و تقریباً ۵۰۰ دلار هزینه محاسباتی داشت. مدل تنها پس از ۲۵۰ گام (حدود یک روز آموزش)، از محدوده عملکرد مدلهای پیشرو عبور کرد و گامهای باقیمانده برای استخراج حداکثر عملکرد استفاده شد.
انتخاب ابزار درست
هر وظیفهای نیاز به مدل تخصصی ندارد. تصمیم به دو عامل بستگی دارد: تکرار وظیفه و قابلیت تأیید. اگر یک وظیفه نادر است یا نتیجه آن غیرقابل تأیید (سلیقهای) است، اجاره یک مدل پیشرو یا نگه داشتن انسان در چرخه بهینهتر است. زمانی که مشکل مربوط به حقایق متغیر باشد و نه قضاوت، راهکار درست «بازیابی» (Retrieval) است، صرفنظر از حجم دادهها.
گردشکار شما کاندیدای مناسبی برای دستورالعمل تنظیم دقیق (Fine-tuning) است اگر این معیارها را داشته باشد:
- حجم بالا: تکرار بهقدری زیاد باشد که هزینههای هر تصمیم و خطاها به مبالغ واقعی تبدیل شوند.
- نتایج تأییدپذیر: هر پاسخ را بتوان با یک قانون، تست یا رابریک، بدون حضور انسان چک کرد.
- توافق خبرگان: متخصصان داخلی شما روی اینکه یک پاسخ درست چگونه است، توافق داشته باشند.
- پتانسیل اثباتشده: یک مدل توانمند در حال حاضر گاهی موفق میشود، اما نه بهطور قابلاعتماد.
- پیچیدگی: پاسخ درست نتواند یک حدس شانس باشد؛ بلکه باید شامل چندین گام استدلال و فراخوانی ابزار باشد.
- محدودیتهای داخلی: وظیفه به ابزارها و سیاستهای اختصاصی وابسته باشد یا شامل دادههای حساسی باشد که بهدلیل مسائل امنیتی نباید از زیرساخت شما خارج شوند.
مزیت انباشته هوش
این چرخش، AI را از یک هزینه عملیاتی جاری به یک دارایی فکری انباشته تبدیل میکند. هرچه مدل در حین تولید دادههای بیشتری تولید کند، تصمیمات ثبتشده را میتوان به مجموعههای تنظیم نظارتشده (SFT) تبدیل کرد و هر تکرار بعدی را ارزانتر و آگاهانهتر ساخت. علاوه بر این، یک مدل پایه قویتر، همیشه متخصص پسساخت (Post-trained) قویتری ایجاد میکند.
این الگو در صنایع مختلف فراتر از تجارت الکترونیک تکرار میشود:
- Cognition: در بنچمارکهای کدنویسی GPT-5.5 را شکست داد و ۱۰۰۰ توکن در ثانیه را با کسری از هزینههای سرویسدهی استریم میکند.
- AT&T: روزانه ۹۰۰ هزار تماس را خلاصه میکند و دادههای شخصی را ۱۷٪ بهتر از GPT-4o شناسایی میکند؛ همچنین پروندههای کلاهبرداری را ۱۲ برابر سریعتر بررسی میکند.
- LinkedIn: کاندیداها را ۴٪ دقیقتر از مدل GPT قبلی خود با شغلها تطبیق میدهد، در حالی که ۷۵ برابر ارزانتر از GPT-4 و ۶ برابر ارزانتر از GPT-4o است.
- Ambience Healthcare: در تست پنل طلایی برای کدهای صورتحساب پزشکی، از ۱۸ پزشک دارای بورد تخصصی بهتر عمل کرد و ۱۲ امتیاز بالاتر از o4-mini با پرامپت قرار گرفت.
- Phonely: به دقت ۹۹.۲٪ رسید در حالی که دقت GPT-4o برابر ۹۴.۷٪ بود؛ پاسخها ۷۳٪ سریعتر شدند و یک مشتری توانست ۳۵۰ عامل انسانی را در یک ماه با آن جایگزین کند.
- OpenPipe: در QA پشتیبانی امتیاز ۹۳٪ گرفت در حالی که OpenAI o3 تنها ۵۰٪ بود؛ در حالی که ۶۴ برابر ارزانتر و ۵ برابر سریعتر اجرا میشود.
- Perplexity: در تستهای کور با GPT-4o برابر شد در حالی که با سرعت ۱۰ برابر بیشتر عمل میکند.
- Checkr: در طبقهبندی دشوار سوابق کیفری از GPT-4 پیشی گرفت و ۳۰ برابر سریعتر و ۵ برابر ارزانتر اجرا میشود.
گام بعدی شما
- شناسایی گردشکارهای با حجم بالا که خروجیهای آنها توسط یک قانون یا rubric قابل تأیید است.
- بررسی مدلهای ۹ میلیارد پارامتری متنباز برای جایگزینی APIهای گرانقیمت در وظایف تکراری.
- جمعآوری دادههای برچسبخورده توسط متخصصان داخلی برای شروع فرآیند آموزش تخصصی.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ به تحلیل ما درباره تراشههای Blackwell مراجعه کنید تا ببینید این مدلهای کوچک کجا اجرا میشوند.



گفتگو