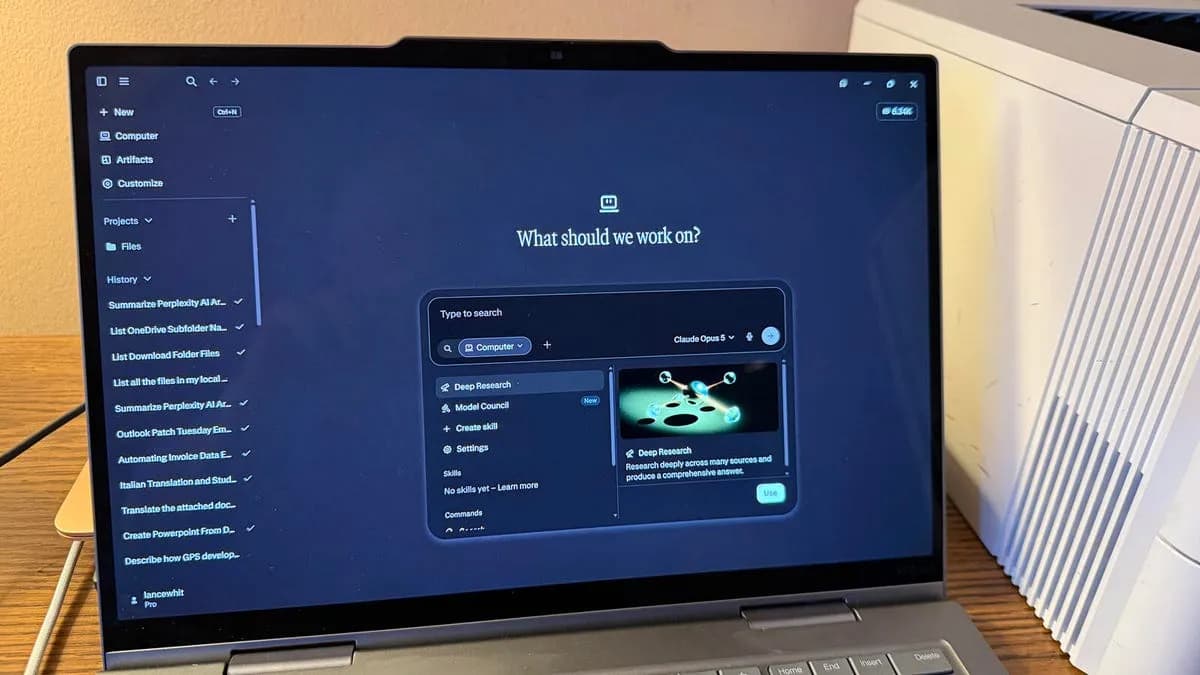
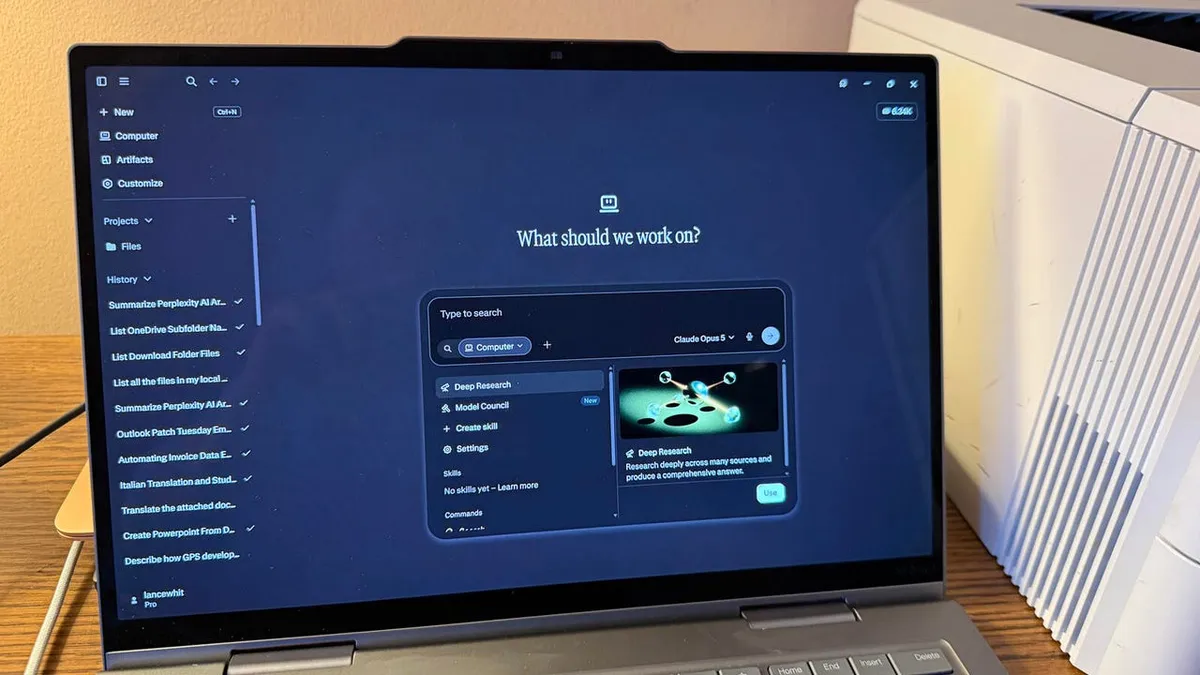
اگر امروز برای هر درخواست از هوش مصنوعی هزینه پرداخت میکنید یا نگران خروج دادههای حساس شرکتتان هستید، مدل اقتصادی این ابزارها در حال تغییر است. پرتپلکسی (Perplexity) در ۲۵ اوت ۲۰۲۶ با معرفی Portable Computer، بار محاسباتی عاملهای هوش مصنوعی را از سرورهای دوردست مستقیماً به دستگاه کاربر منتقل کرد.
بیشتر ابزارهای فعلی شبیه به مکالمه با یک سرور دوردست هستند که هر پیام در آن یک «مالیات توکنی» ایجاد میکند؛ یعنی هر درخواست هزینه دارد و دادهها باید برای پردازش از دستگاه خارج شوند. برای کاربران تجاری، این وضعیت تضادی دائمی میان بهرهوری و حاکمیت دادهها ایجاد کرده است. این تغییر رویکرد با پیشبینیهای استراتژیک همسو است؛ چرا که گارتنر پیشبینی کرده بود ۶۰٪ سازمانها تا سال ۲۰۲۷ استنتاج AI را به لبه منتقل میکنند.
مزیتهای رویکرد محلی-محور
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، کنترل روی لایهی سختافزاری تنها راه تضمین کامل حریم خصوصی است. Portable Computer با قرار دادن مدلها و فایلها در یک محیط ایزولهی محلی (Sandbox)، این مشکل را حل میکند. به نقل از وبلاگ فنی پرتپلکسی، این معماری «محلی-محور» تضمین میکند که دادههای حساس بدون اجازه صریح کاربر، هرگز دستگاه را ترک نکنند. این شرکت تأکید دارد که چون سیستم ذاتاً خصوصی و مقرونبهصرفه است، مدلهای محلی هیچ هزینه استنتاج (Inference) — یعنی همان لحظهی تولید جواب که شبیه به خودِ آشپزی است و نه دورهی آموزش آشپز — ندارند.
کاربران همچنان میتوانند به سرویسهای ابری مثل Slack، GitHub، Gmail و Google Drive متصل شوند، اما استدلال اصلی بهصورت آفلاین رخ میدهد. این رویکرد ترکیبی اجازه میدهد عامل هوش مصنوعی از فایلهای ابری استفاده کند اما زیربنای محلی خود را حفظ کند.
الزامات سختافزاری و دسترسی
با این حال، ورود به این دنیای جدید هزینهبر است و سد ورود بالایی دارد. این ابزار تنها برای مشترکان طرحهای پولی — بهطور مشخص سطوح Pro، Max، Enterprise Pro و Enterprise Max — در دسترس است و کاربران رایگان به آن دسترسی ندارند. در حال حاضر این سیستم فقط از لینوکس پشتیبانی میکند و نسخهی ویندوز برای سپتامبر ۲۰۲۶ برنامهریزی شده است.
بر اساس مستندات فنی، برای اجرای این عامل به سختافزارهای ردهبالا نیاز دارید:
- لینوکس: سیستم Nvidia DGX Spark یا دستگاهی با GPU مدل Nvidia RTX. سیستم باید روی اوبونتو یا Nvidia DGX OS و بر روی معماری ARM یا x64 اجرا شود.
- ویندوز: یک GPU مدل NVIDIA RTX با حداقل ۲۴ گیگابایت حافظه ویدیویی (VRAM).
برای درک بهتر، یک GPU با ۲۴ گیگابایت VRAM معمولاً حداقل ۱,۵۰۰ دلار قیمت دارد. این یعنی لپتاپهای معمولی یا دسکتاپهای ابتدایی، مانند سیستمهایی که تنها ۴ گیگابایت رم دارند، اصلاً نمیتوانند این ابزار را اجرا کنند.
گزینههای مدل و مکانیسمها
کاربران میتوانند بسته به نوع وظیفه، مدلهای مختلفی را انتخاب کنند. این سیستم از Qwen 3.8 27B پشتیبانی میکند؛ یک مدل با وزنهای باز (Open Weights) — یعنی دستور پخت مدل علناً منتشر شده و نه فقط غذای آماده — که به دلیل سرعت، عملکرد و قدرت در کدنویسی، پژوهش و کارهای حرفهای مشهور است.
پرتپلکسی همچنین مدل PPLX 27B را ارائه میدهد که نسخهای «پسآموزشدیده» (Post-trained) است. در این فرآیند، مدل پس از آموزش اولیه، برای افزایش دقت و کارایی بازبینی و اصلاح میشود تا فراتر از دستورالعملهای اولیه عمل کند. این تلاش برای بهینهسازی مدلهای بزرگ روی سختافزار محلی، یادآور مدل Muse Glimmer متا است که امکان اجرای عاملهای ۳۰ میلیارد پارامتری را روی GPUهای خانگی فراهم کرد.
علاوه بر این، این پلتفرم بهزودی مدل Nemotron 3.5 Lightning انویدیا را ادغام خواهد کرد که بهطور خاص برای کارهای عاملمحور (Agentic) با حجم بالا و اجرای طولانیمدت طراحی شده است. کاربران میتوانند بسته به مأموریت خاصی که به هوش مصنوعی میسپارند، بین این مدلها جابهجا شوند.
این حرکت، اقتصاد هوش مصنوعی را برای کاربران حرفهای تغییر میدهد. با انتقال استنتاج به لبه (Edge)، هزینههای تکرارشوندهی توکنها برای کارهای محلی حذف میشود. شما فقط زمانی اعتبار ابری مصرف میکنید که عامل نیاز داشته باشد برای دریافت دادههای خارجی «به فضای آنلاین بپرد».
برای یک متخصص، این یعنی هوش مصنوعی از یک سرویس اشتراکی با شمارش هزینه، به یک ابزار دائمی تبدیل میشود؛ نرمافزاری که با ارتقای سختافزار شما رشد میکند، نه با ارتقای سطح اشتراک. در واقع، عامل هوش مصنوعی از یک مشاور ابری به یک قطعه نرمافزاری محلی تبدیل میشود.
اینکه آیا این رویکرد فراتر از «نخبههای GPU» گسترش مییابد یا خیر، هنوز مشخص نیست. اگر پرتپلکسی بتواند این مدلها را برای VRAMهای کمتر بهینه کند، موج بزرگی از مهاجرت از عاملهای وابسته به ابر آغاز خواهد شد. باید منتظر انتشار نسخهی ویندوز در سپتامبر باشیم تا ببینیم آیا پرتپلکسی بهینهسازیهای سختافزاری جدیدی برای کاهش نیاز به ۲۴ گیگابایت VRAM معرفی میکند یا خیر.
گام بعدی شما
- اگر سختافزار RTX با VRAM بالا دارید، نسخهی لینوکس را برای تست حریم خصوصی دادهها نصب کنید.
- برای کاربران ویندوز، منتظر بهروزرسانی سپتامبر ۲۰۲۶ باشید تا ببینید آیا نیاز به ۲۴ گیگابایت VRAM کاهش مییابد یا خیر.
- مدل Qwen را برای کارهای کدنویسی محلی امتحان کنید تا تفاوت سرعت استنتاج محلی با ابری را حس کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو