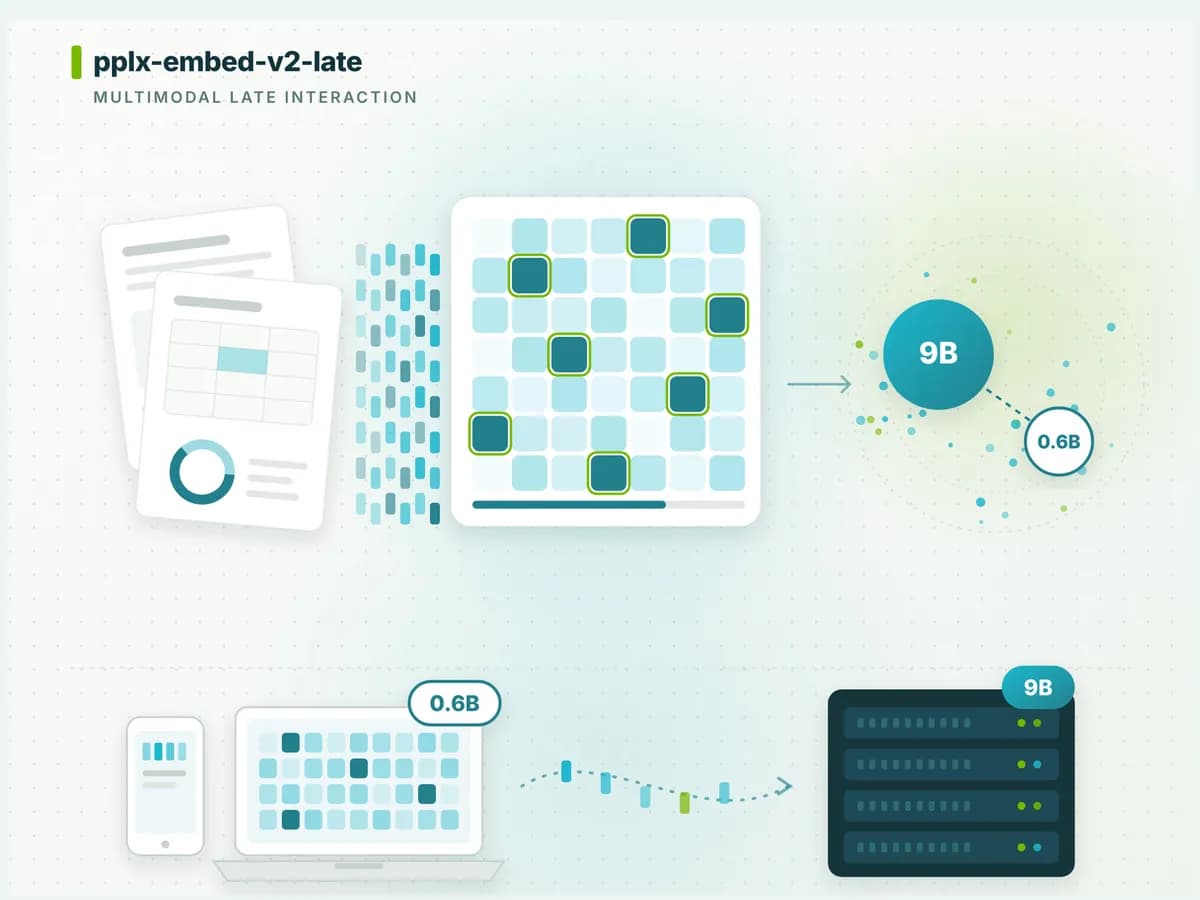
دقت بازیابی اطلاعات از اسناد حجیم و پیچیده، نقطه ضعف همیشگی عاملهای هوش مصنوعی بوده است. حالا مدل جدید Perplexity با ثبت صحت ۹۲.۴ درصدی در محک MADQA، استانداردهای بازیابی عاملمحور (Agentic Retrieval) را جابهجا کرد. طبق اعلام این شرکت در ۸ اکتبر ۲۰۲۶، سری مدلهای pplx-embed-v2-late با رویکردی دوگانه عرضه شدهاند تا متن، تصاویر و صفحات رندر شده PDF را در یک فضای مشترک پردازش کنند.
بسیاری از مدلهای فعلی، کل یک سند را در یک بردار معنایی (Embedding) فشرده میکنند و در این مسیر، جزئیات ریز سند از دست میرود. Perplexity برای حل این مشکل از معماری ColBERT استفاده کرده است؛ سیستمی که برای هر توکن (Token) یک بردار ۱۲۸-بعدی مجزا نگه میدارد. این ساختار اجازه میدهد تا مکانیزم امتیازدهی MaxSim، بهترین تطابق هر توکن پرسوجو را در سند پیدا کرده و مجموع آنها را محاسبه کند که نتیجه آن، افزایش چشمگیر دقت در محتواهای طولانی است.
برای دستیابی به این سطح از عملکرد، Perplexity هر دو مدل را از یک مدل معلم ۱۸ میلیاردی و با استفاده از آموزش سطح توکن به سبک LEAF استخراج (Distillation) کرده است. این فرآیند آموزشی خاص است که باعث ایجاد یک فضای جاسازی مشترک بین مودالیتههای مختلف و اندازههای متفاوت مدل میشود. این تلاش برای بهینهسازی مدلها در راستای کاهش هزینههای پردازشی است، مشابه آنچه در بهینهسازی حجم توکنهای استدلال در مدل ThinkingCap شاهد بودیم.
بر اساس مستندات منتشر شده در Hugging Face، این مدلها تحت لایسنس MIT و برای استفاده تجاری در دسترس هستند. این عرضه شامل دو وزن مجزا است:
- pplx-embed-v2-late-0.6b: مدلی سبک بر پایه Qwen3.5-0.8B که هرس (Pruning) شده است (به ۱۲ لایه متنی کاهش یافته). این مدل تقریباً از ۲۴۰ میلیون پارامتر فعال برای متن و ۳۴۰ میلیون پارامتر برای تصاویر استفاده میکند. با تخمین bf16، این مدل به حدود ۱.۲ گیگابایت حافظه نیاز دارد و برای استقرار روی لپتاپها، دستگاههای لبه (Edge Devices) یا پردازندههای گرافیکی کوچک طراحی شده است.
- pplx-embed-v2-late-9b: مدلی با ظرفیت بالا بر پایه Qwen3.5 با ۷.۴ میلیارد پارامتر فعال. این مدل به ۱۶ تا ۱۸ گیگابایت حافظه (تخمین bf16) نیاز دارد و برای استفاده در مراکز داده (Data Center) یا GPUهای با حافظه بالا جهت ساخت شاخصهای اسنادی با کیفیت بالا در نظر گرفته شده است.
به گزارش Marktechpost، مدل ۹ میلیاردی در ۷۲ تکلیف متنی تخصصی (با معیار nDCG@10) با امتیاز ۸۱.۳٪، تمام مدلهای تست شده را با اختلاف ۱.۶ درصد پشت سر گذاشت. همچنین در محک BrowseComp+، با امتیاز ۶۴.۰٪، فاصله ۸.۷ درصدی با بهترین مدل متراکم (Dense Model) ایجاد کرد که برتری قابل توجهی است.
سایر نتایج بنچمارکها حاکی از برتری این مدلهاست:
- Q2D-Web (Recall@1000): هر دو مدل توانستند رکورد قبلی ۶۹.۳٪ را بشکنند؛ مدل ۹ میلیاردی به ۷۴.۸٪ و مدل ۰.۶ میلیاردی به ۷۳.۶٪ رسیدند.
- ViDoRe v3 Markdown (nDCG@10): مدل ۹ میلیاردی با امتیاز ۶۴.۷٪، تمام مدلهای خارجی تست شده را شکست. مدل ۰.۶ میلیاردی امتیاز ۶۱.۲٪ را کسب کرد که اگرچه کمترین امتیاز در این مجموعه بود، اما همچنان دومین نتیجه برتر در کل این بنچمارک محسوب میشود.
- MADQA: صحت ۹۲.۴ درصدی مدل ۹ میلیاردی، مدل بازیاب Mixedbread (۸۸.۹٪) را شکست، هرچند هنوز از جستوجوی عاملمحور Mixedbread (۹۳.۴٪) عقبتر است.
نکته فنی جالب این است که Perplexity سیستم را بهگونهای طراحی کرده که مدل ۰.۶ میلیاردی بتواند روی شاخصهای (Index) مدل ۹ میلیاردی پرسوجو کند. در بازیابی تصاویر ViDoRe v3، این رویکرد ترکیبی امتیاز ۶۳.۵٪ را کسب کرد که حدود نیمی از شکاف کیفی بین دو مدل را پر میکند، در حالی که هزینه استنتاج (Inference) را در سطح مدل کوچک نگه میدارد.
از نظر مهندسی، این مدلها بر خلاف رقبایی مثل Nemotron-colembed-vl-8b-v2 انویدیا یا Gemini Embedding 2 گوگل که از بردارهای ۲۰۴۸ تا ۴۰۹۶ بعدی استفاده میکنند، تنها از ۱۲۸ بعد برای هر توکن استفاده میکنند. این یعنی بردارها ۱۶ تا ۳۲ برابر باریکتر شدهاند.
البته این معماری یک سبک-سنگین (Trade-off) در ذخیرهسازی ایجاد میکند. چون برای هر توکن یک بردار ذخیره میشود، حجم شاخصها با افزایش طول سند بهصورت خطی رشد میکند. برای مدیریت چنین حجمهای عظیم از داده در مقیاس صنعتی، زیرساختهای ذخیرهسازی پیشرفتهای مانند خوشه OceanStor M900 هواوی که حافظههای پتابایتی را برای استنتاج فراهم میکند، حیاتی هستند. علاوه بر این، مدلها در حال حاضر نمیتوانند متن و تصویر را در یک ورودی واحد ترکیب کنند و در امتیازات بازیابی تصاویر ViDoRe v3 از مدل EVIE شرکت تنسنت (که مدل ۹ میلیاردی در آن ۶۵.۲٪ گرفت) عقبتر هستند. همچنین اشاره شده است که Gemini Embedding 2 در MIRACL-Vision و با اختلاف ۲ درصد در PPLX-Q2I بر مدل ۹ میلیاردی برتری دارد.
این عرضه، تمرکز جامعه فنی را از «مدل بزرگتر، بهتر است» به «کارایی ساختاری» تغییر میدهد. این رویکرد بهویژه برای جستوجوی اسناد بصری (مانند اسلایدهای ارائه و گزارشهای اسکن شده) قدرتمند است، زیرا صفحات را بهعنوان تصویر کدگذاری میکند و نیاز به مرحله نویسهخوانی نوری (OCR) را حذف میکند. این امر امکان ایجاد یک معماری ترکیبی ابر-لبه (Cloud-Edge) را فراهم میکند: شاخصگذاری مجموعهدادههای عظیم در ابر با مدل ۹ میلیاردی و اجرای پرسوجوهای زنده بهصورت محلی روی دستگاه با مدل ۰.۶ میلیاردی.
توسعهدهندگان میتوانند هماکنون این مدلها را با کتابخانههای sentence-transformers >= 6.0.0 و transformers >= 5.4.0 پیادهسازی کنند. در حالی که وزنها برای میزبانی شخصی (در قالب F32) منتشر شدهاند، یک نقطه اتصال (API) میزبانی شده توسط Perplexity برنامهریزی شده اما هنوز فعال نشده است.
گام بعدی شما
- اگر با اسناد PDF حجیم سر و کار دارید، مدل ۹ میلیاردی را برای ساخت Index و مدل ۰.۶ میلیاردی را برای Querying تست کنید.
- برای کاهش هزینههای حافظه در محیطهای لبه، معماری ۱۲۸-بعدی این مدل را با مدلهای متراکم مقایسه کنید.
- بررسی کنید که آیا حذف مرحله OCR در گردشکار شما، سرعت پردازش اسناد بصری را افزایش میدهد یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو