انتخاب یک فریمورک اشتباه برای هوش مصنوعی زاینده میتواند سرعت پروژه شما را متوقف و کیفیت خروجی را کاهش دهد. طبق بحثهای جامعه گیتهاب (#۲۰۸۹۴۴) که در ۱۴ اکتبر ۲۰۲۶ منتشر شد، PyTorch به توصیه قطعی برای توسعهدهندگانی تبدیل شده است که مدل انتشار (Diffusion Model) — شبیه به مجسمهگری که ابتدا با یک توده از نویز شروع میکند و ذرهذره جزئیات را بیرون میکشد — میسازند.
این چرخش در حالی رخ میدهد که هوش مصنوعی زاینده از یک کنجکاوی آکادمیک به ابزارهای سطح تولید تبدیل شده است. همانطور که در تحلیل قبلی ما دربارهی مدلهای انتشار متنی و تولید موازی توکنها اشاره کردیم، تمرکز صنعت اکنون بر زیرساختی است که این مدلها را در مقیاس واقعی عملی کند. برای اکثر تیمها، انتخاب فریمورک دیگر بحث سینتکس نیست، بلکه بحث این است که کدام اکوسیستم سریعترین مسیر را به یک نمونه اولیه (Prototype) موفق ارائه میدهد.
برتری اکوسیستم
کتابخانه Hugging Face diffusers که استاندارد صنعت برای این مدلهاست، بهصورت بومی روی PyTorch بنا شده است. این یکپارچگی باعث میشود اجزای حیاتی از روز اول برای این فریمورک بهینه شوند:
- وزنهای پیشآموزشدیده و زمانبندها: مدلهایی مثل Euler، DPM-Solver و UniPC عمدتاً برای PyTorch بهینه شدهاند.
- اسکریپتهای تنظیم دقیق: ابزارهایی مانند لورا (LoRA)، DreamBooth و ControlNet بهشدت به استک PyTorch متکی هستند.
- افزایش عملکرد: نسخه ۲.x پایتورچ قابلیتهای SDPA و
torch.compileرا معرفی کرده که طبق گزارشهای جامعه توسعهدهندگان، سرعت را بدون نیاز به وابستگیهای خارجی ۲ تا ۳ برابر میکند.
چابکی مهندسی
نمونهگیری در مدلهای انتشار نیازمند حلقههای تکرار شونده برای حذف نویز است که با بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که جایگاهش را در فضای معنایی مشخص میکند — و تنسورهای شرطی کار میکند. طراحی دستوری PyTorch و گرافهای محاسباتی پویا باعث میشود پیادهسازی و عیبیابی این فرآیندهای چندمرحلهای بصورت شهودی انجام شود. در مقابل، جریانهای کامپایل گراف در TensorFlow سختگیرانهتر هستند و هزینهی عیبیابی را برای تیمهای مهندسی بالا میبرند.
رهبری پژوهشی نیز این تسلط را تثبیت کرده است. بر اساس بررسی منابع متعدد، بیش از ۹۰٪ مقالات هوش مصنوعی زاینده و وزنهای باز (Open Weights) — یعنی مدلهایی که دستور پختشان علناً منتشر شده — در arXiv و Hugging Face اولویت را به پیادهسازیهای PyTorch میدهند. این یعنی تیمها میتوانند جدیدترین دستاوردهای پژوهشی را بلافاصله پس از انتشار به کار بگیرند.
اگرچه TensorFlow برای تیمهایی که زیرساختهای قدیمی برای آموزش یا سرویسدهی دارند همچنان گزینه معتبری است، اما در حوزه مدلهای انتشار، فاقد جامعترین مثالها و پشتیبانی اکوسیستم است. برای پروژههای جدید، ترکیب torch + diffusers + Accelerate برای آموزش و استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند و شبیه به خودِ آشپزی است، نه دورهی آموزش آشپز — توصیه میشود. این تلاش برای بهینهسازی زیرساختها در راستای کاهش هزینههای عملیاتی است، مشابه آنچه سامانه Scion در آنتروپیک برای مدیریت بهینه منابع زیرساختی به دست آورده است.
فراتر از فریمورکها: چرخش به مدلهای فضای حالت
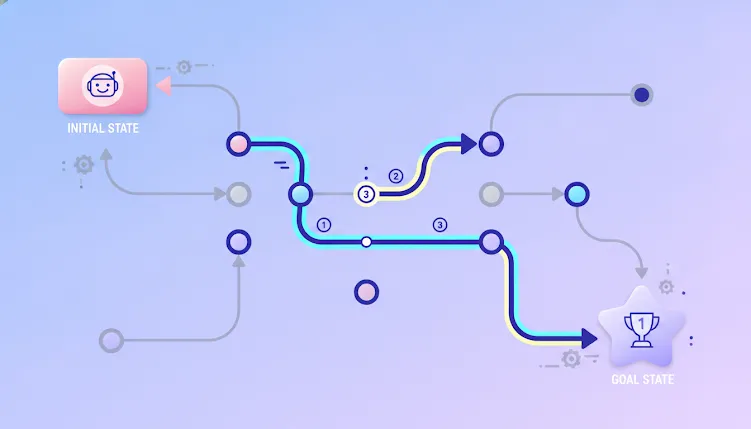
بحثهای فنی همچنین به یک تمایز حیاتی میان هوش مصنوعی کلاسیک و مدلسازی توالیهای مدرن اشاره داشت. جستوجوی فضای حالت کلاسیک، مسائل را به عنوان حالتهای گسسته و انتقالاتی برای یافتن مسیر هدف میبیند.
جزئیات جستوجوی فضای حالت کلاسیک
در این پارادایم بنیادی، مسئله به صورت مجموعهای از حالتهای گسسته و عملگرها تعریف میشود. برای مثال در یک هزارتو، هر مربع یک حالت است و حرکت بین آنها یک اقدام. اجزای کلیدی عبارتند از:
- فضای حالت: گراف یا درخت تمام پیکربندیهای ممکن سیستم.
- حالت اولیه و آزمون هدف: نقطه شروع و تابعی که تایید میکند هدف محقق شده است یا خیر.
- اقدامات/انتقالات: حرکات مجاز که حالت S را به حالت S' میبرد.
- هزینه مسیر: مجموع هزینههای رسیدن به یک حالت خاص.
استراتژیهای جستوجو به دو دسته تقسیم میشوند: جستوجوی بدون اطلاع (Blind) مانند BFS برای بهینگی در هزینههای برابر، یا DFS برای بهرهوری حافظه؛ و جستوجوی آگاهانه (Heuristic) که جستوجوی A* با تابع ارزیابی f(n) = g(n) + h(n) نمونهای بارز از آن است.
مدلهای فضای حالت مدرن (SSMs)
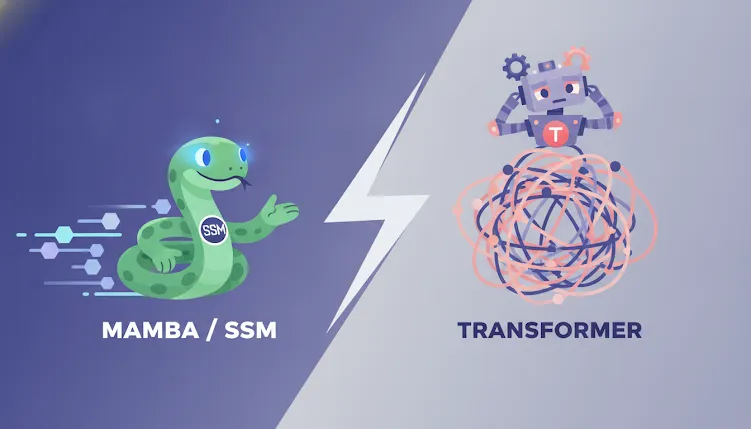
مدلهای فضای حالت مدرن مانند Mamba و S4 متفاوت عمل میکنند. آنها انتقال حالتهای توالی پیوسته را در زمان خطی O(L) مدلسازی میکنند. این یک مزیت محاسباتی عظیم در برابر پیچیدگی درجه دوم O(L2) در مکانیزم توجه (Attention) ترنسفورمرهای سنتی است، بهویژه برای پردازش توالیهای بسیار طولانی.
برای مدیران فنی و مدیران محصول، این انتخابها مستقیماً روی شاخصهای کلیدی عملکرد (KPI) اثر میگذارد. استفاده از استک پیشنهادی PyTorch، diffusers و Accelerate چرخههای تکرار را کاهش و سرعت کدنویسی را افزایش میدهد. این بهرهوری در تحلیلهای Pull Request گیتهاب مشهود است، جایی که جریانهای کاری سادهتر به ادغام سریعتر کدها و خطاهای کمتر منجر میشود. این رویکرد بهینهسازی در سطح نرمافزاری، مکمل پیشرفتهای سختافزاری است؛ برای مثال اتوماسیون Floorplanning توسط Synopsys و TSMC نشان میدهد که چگونه هوش مصنوعی در حال بازتعریف نحوه طراحی تراشههای بهینهتر برای همین مدلهاست.
گام بعدی شما
- اگر در حال شروع پروژه تولید تصویر یا ویدیو هستید، مستقیماً با کتابخانه
diffusersو PyTorch 2.x شروع کنید تا ازtorch.compileبرای افزایش سرعت بهره ببرید. - برای کاهش هزینههای سختافزاری در آموزش، ابزار Accelerate را برای توزیع بار روی چندین GPU بررسی کنید.
- اگر با توالیهای بسیار طولانی سر و کار دارید، معماریهای SSM مانند Mamba را جایگزین ترنسفورمرهای سنتی کنید تا از پیچیدگی محاسباتی O(L2) رها شوید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو