۱۴ توکن در ثانیه؛ این سرعت فعلی تولید متن در مدل Qwen3.8 27B روی یک مک استودیو M3 Ultra است که دقیقاً نیمی از سرعت نسخه قبلی (Qwen3.6) است. این افت عملکرد نتیجه مستقیم یک معماری توجه ترکیبی جدید است که هستههای پردازشی فعلی هنوز برای آن بهینه نشدهاند.
پذیرش مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — از حالت کنجکاوی به کاربرد عملی تغییر کرده است. کاربران دیگر فقط با باتها گپ نمیزنند، بلکه برای حفظ حریم خصوصی و کاهش تأخیر، خط لولههای ابری را با جایگزینهای محلی عوض میکنند. بر اساس پوششهای قبلی ما دربارهی شکاف پهنای باند بین مک استودیو M5 Ultra و سیستمهای DGX Spark، تمرکز اکنون از محدودیتهای سختافزاری خام به نحوه استفاده معماریهای خاص از حافظه یکپارچه منتقل شده است.
مشخصات مدل و زمینه فنی
مدل Qwen3.8-27B یک مدل متراکم با ۲۷.۳ میلیارد پارامتر است. این مدل از طراحی توجه ترکیبی استفاده میکند که در فایلهای GGUF با تگ معماری qwen35 شناسایی میشود؛ تگی که برای سازگاری با محیطهای اجرایی فعلی حیاتی است.
این مدل چندوجهی (Multimodal) — شبیه به ما که با چند حس دنیا را میخوانیم — است و درک تصویر و ویدیو را بهصورت داخلی پشتیبانی میکند. مدل مذکور تحت لایسنس Apache 2.0 منتشر شده و دارای یک پنجره زمینه (Context Window) — مثل میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — عظیم با ظرفیت ۲۶۲,۱۴۴ توکن است.
بر اساس مستندات رسمی، این مدل در آزمون SWE-bench Pro امتیاز ۶۱.۷ و در GPQA Diamond امتیاز ۸۹.۲ را کسب کرده است. این اعداد تا یک سال پیش در انحصار آزمایشگاههای پیشرو بود. با این حال، علاقه جامعه کاربران از بنچمارکها به کاربردهای دنیای واقعی تغییر کرد. کاربران اولیه گزارش دادند که این مدل در خط لولههای کدنویسی جایگزینی ایدهآل برای APIهای پولی است و در نویسهخوانی نوری (OCR) از برخی سرویسهای تجاری ابری پیشی گرفته است. در همین راستا، برخی کاربران توانستهاند با استفاده از مکمینیهای ۱۶ گیگابایتی و اولاما، این مدل را به جایگزینی برای گیتهاب کوپایلت تبدیل کنند. یکی از نظرات محبوب در r/LocalLLaMA آن را به عنوان «اولین مدل محلی که حس نمیشود فقط یک اسباببازی باشد» توصیف کرده است.
پارادوکس عملکرد
به گزارش وبسایت terminalbytes.com در ۲۸ اوت ۲۰۲۶، کاهش سرعت لزوماً به معنای انتظار بیشتر برای کاربر نیست. اگرچه Qwen3.8 27B در تولید هر توکن کندتر است، اما در خروجی نهایی بسیار بهینهتر عمل میکند.
در تستهای رودررو روی مک استودیو M3 Ultra با ۲۵۶ گیگابایت حافظه یکپارچه، میانگین پنج اجرای مجزا با دستور ollama run --verbose روی پرامپتهای فنی (پاسخهای ۲۰۰ تا ۵۰۰ کلمهای) ثبت شد. هر دو مدل از کوانتای پیشفرض Ollama (Q4_K_M) با حجم حدود ۱۷ گیگابایت روی دیسک استفاده کردند:
- qwen3.6:27b: سرعت تولید ۲۸.۶ توکن در ثانیه؛ پردازش پرامپت ۹۵.۰ توکن در ثانیه؛ نوسان بسیار کم بین اجراها (۲۸.۵ تا ۲۸.۸).
- qwen3.8:27b: سرعت تولید ۱۴.۰ توکن در ثانیه؛ پردازش پرامپت ۹۳.۱ توکن در ثانیه؛ نوسان بیشتر بین اجراها (۱۳.۲ تا ۱۵.۴).
در این آزمایشها، مدل قدیمی Qwen3.6 برای پاسخ به یک سؤال بین ۱,۹۵۰ تا ۳,۳۴۰ توکن تولید میکرد (پرحرف بود). در مقابل، Qwen3.8 همان پاسخ را در ۸۹۰ تا ۱,۰۹۰ توکن ارائه داد.
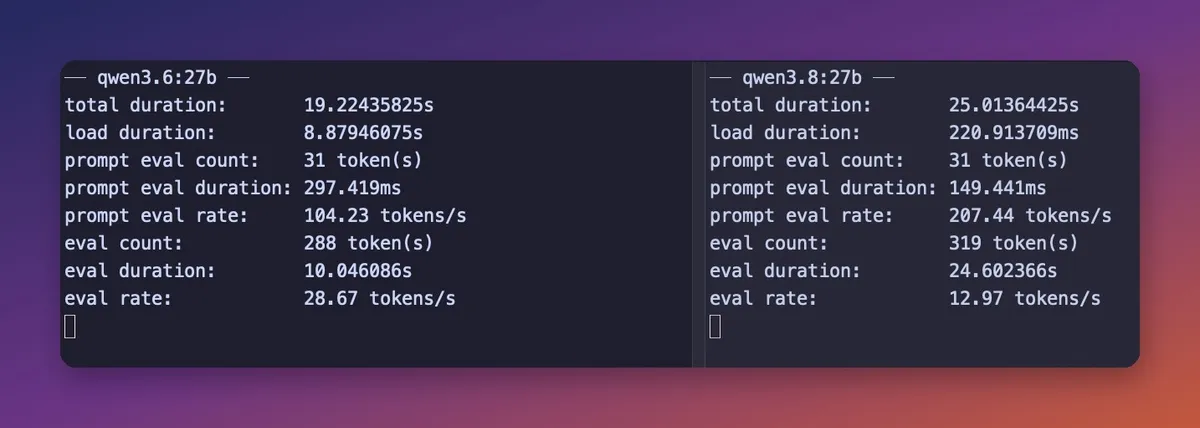
از نظر ریاضی، یک پاسخ ۲۰۵۸ توکنی با سرعت ۲۸.۶ توکن در ثانیه، ۷۲ ثانیه زمان میبرد، در حالی که یک پاسخ ۹۵۵ توکنی با سرعت ۱۴.۲ توکن در ثانیه، تنها ۶۷ ثانیه زمان میبرد. مدل جدید کندتر حرف میزند، اما سریعتر کار را تمام میکند.
بهرهبرداری از سختافزار
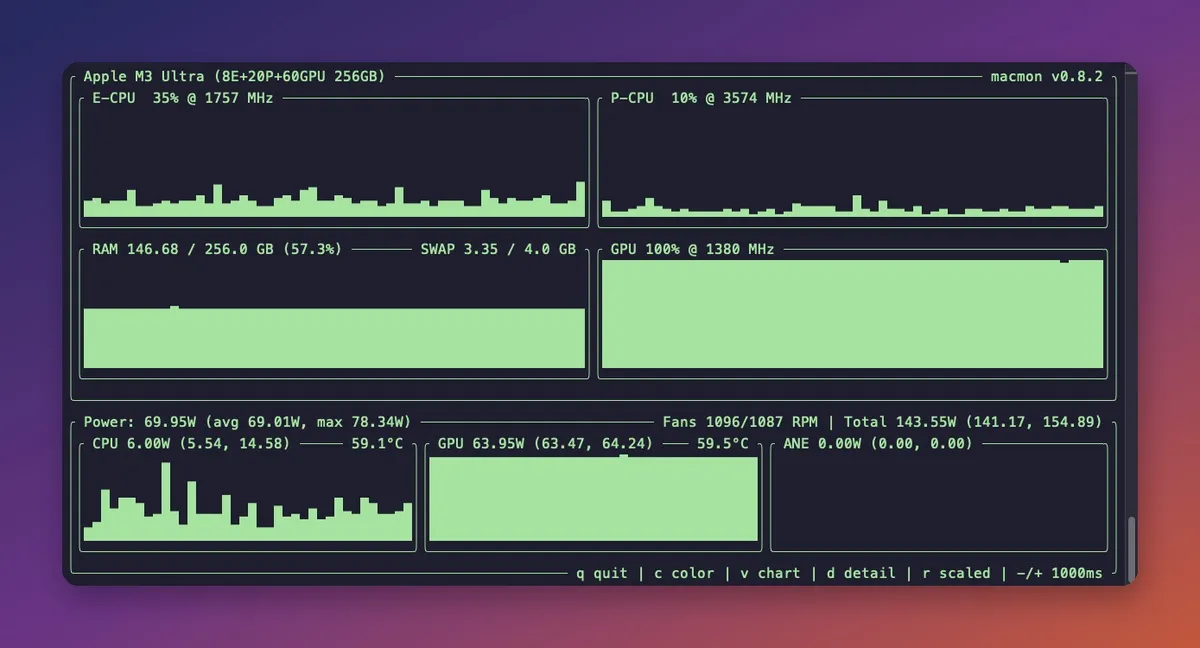
در تراشههای اپل، بار استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، مثل خودِ آشپزی و نه دوره آموزش آشپز — از طریق Metal به GPU میرسد و CPU را تقریباً بیکار میگذارد. هنگام تولید متن، GPU با ۱۰۰٪ ظرفیت و مصرف ۶۳.۹۵ وات کار میکند، در حالی که CPU تنها ۶ وات مصرف میکند.
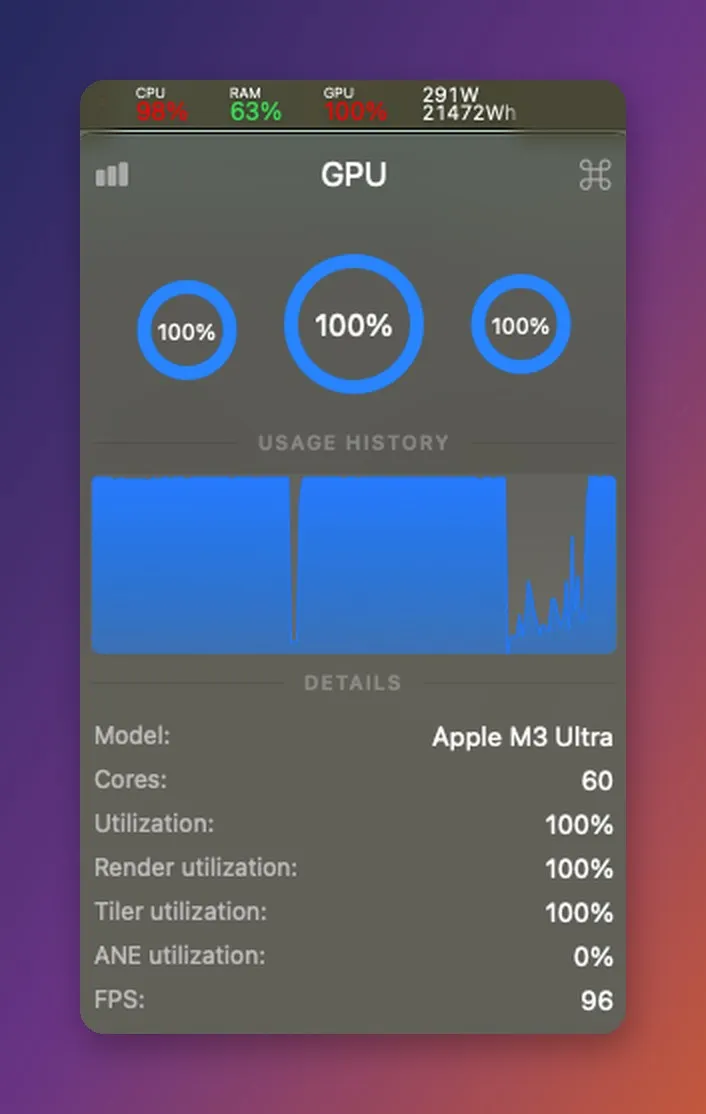
مصرف برق کل سیستم هنگام درگیر شدن تمام ۶۰ هسته GPU به ۲۹۱ وات میرسد. این موضوع تأیید میکند که برای مدلهای متراکم مثل Qwen3.8، گلوگاه اصلی محاسبات GPU و پهنای باند حافظه است، نه توان پردازنده.
آزمایش کوانتای ۱-بیتی
علاقه جامعه کاربران به کوانتای (Quantization) ۱-بیتی Unsloth افزایش یافته که حجم مدل ۲۷ میلیاردی را به ۶.۷ گیگابایت میرساند. این نسخه که به «کوانتای آسیبدیده» معروف شده، اجازه میدهد مدل روی تقریباً هر مینیپیسی مدرن با ۱۶ گیگابایت رم اجرا شود.
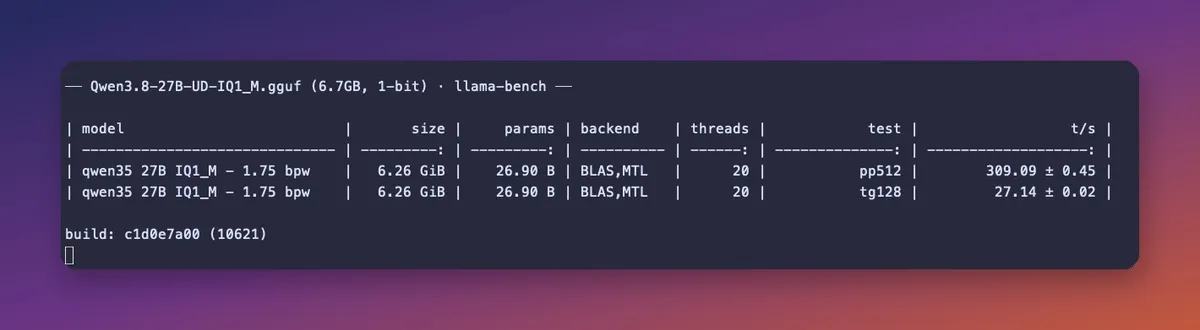
تستها شکاف عمیقی در قابلیتها نشان میدهند: بازیابی حقایق دستنخورده باقی مانده، اما قاطعیت مدل از بین رفته است. مدل ۱-بیتی میتواند به درستی تشخیص دهد که کانبرا پایتخت استرالیا است و سازش بین سیدنی و ملبورن در پسزمینه آن را توضیح دهد. اما در نوشتن دستورات ساده bash شکست میخورد؛ ممکن است دستور درستی تولید کند اما سپس ۴۰۰ توکن را صرف تردید به خود کند بدون اینکه هرگز به پاسخ نهایی برسد.
طبق مستندات Unsloth، کوانتای ۱-بیتی برای کارهای عاملمحور (Agentic) یا فراخوانی ابزار مناسب نیست چون دقت در وظایف طولانی فرو میپاشد. برای این کارها، کوانتای Q2_K_XL (۹.۸ گیگابایت) حداقل توصیه شده است.
نیازمندیهای رم و مسیرهای سختافزاری
اجرای Qwen3.8 27B بسته به سطح کوانتای، به حافظه مشخصی نیاز دارد. کاربران باید حجم فایل را بهعلاوه چند گیگابایت برای زمینه و پروژکتور بینایی در نظر بگیرند. در تحلیلهای فنی ما، داشتن ۲۴ گیگابایت VRAM به عنوان نقطه ورود واقعی برای اجرای بهینه این مدل معرفی شده است:
- UD-IQ1_M (1-bit): فایل ۶.۷ گیگابایتی؛ حداقل ۱۶ گیگابایت رم. روی هر مینیپیسی مدرن اجرا میشود.
- UD-Q2_K_XL (2-bit): فایل ۹.۸ گیگابایتی؛ حداقل ۱۶ گیگابایت رم. روی هر مینیپیسی مدرن اجرا میشود.
- UD-Q4_K_XL / Q4_K_M (4-bit): فایل ۱۶ تا ۱۷.۶ گیگابایتی؛ حداقل ۳۲ گیگابایت رم. مناسب مینیپیسیهای میانرده.
- UD-Q6_K (6-bit): فایل ۲۲ گیگابایتی؛ ۳۲ گیگابایت (در مرز) تا ۴۸ گیگابایت رم. برای پیکربندیهای با رم بالا.
- Q8_0 (8-bit): فایل ۲۹ گیگابایتی؛ ۴۸ تا ۶۴ گیگابایت رم. مناسب Strix Halo یا حافظه یکپارچه مک.
- BF16: فایل ۵۴.۷ گیگابایتی؛ ۹۶ تا ۱۲۸ گیگابایت رم. مناسب مک استودیو یا Strix Halo.
برای کاربرانی که از سختافزار اپل دوری میکنند، پلتفرم AMD Strix Halo هدف فعلی است. تراشه Ryzen AI Max+ 395 در کوانتای Q4_K_M سرعت ۲۰.۴ توکن در ثانیه و پردازش پرامپت ۲۹۲ توکن در ثانیه را ثبت کرده است. البته با استفاده از روشهای بهینهسازی خاص، دستیابی به سرعت ۵۰ توکن بر ثانیه روی GPUهای ۲۴ گیگابایتی نیز امکانپذیر شده است.
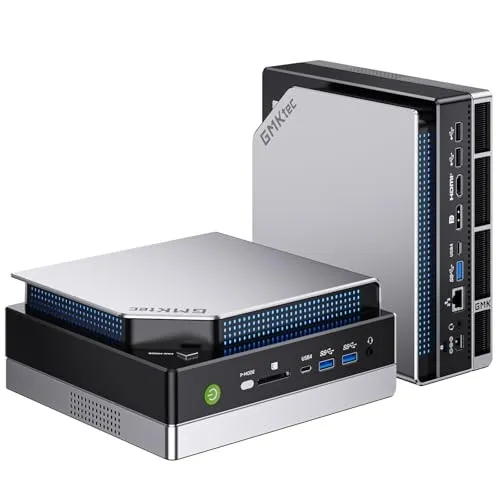
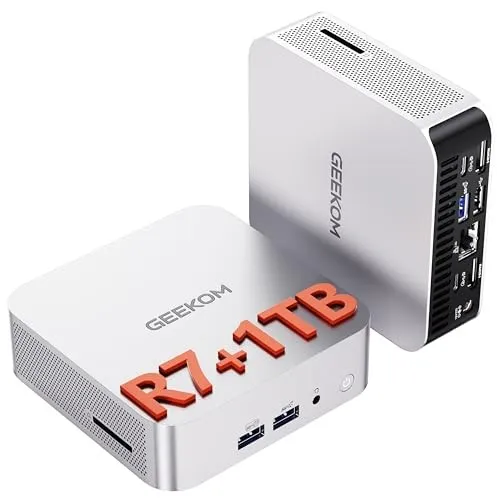
کاربرانی با بودجه محدود میتوانند به GEEKOM A6 (Ryzen 7 6800H, 32GB) یا GMKtec M6 Ultra با رم DDR5 برای کوانتای Q4 نگاه کنند، هرچند استنتاج روی CPU بهشدت کندتر خواهد بود و احتمالاً در محدوده تکرقمی توکن در ثانیه قرار میگیرد.
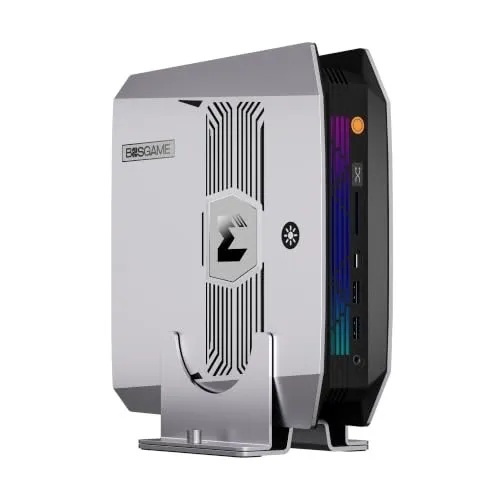
برای نیازهای سطح بالا، GMKtec EVO-X2 با ۶۴ گیگابایت رم گزینهای اقتصادی با قیمت ۱۹۹۹ دلار است، در حالی که BOSGAME M5 با ۱۲۸ گیگابایت رم اجازه اجرای نسخههای Q8 و BF16 را میدهد.
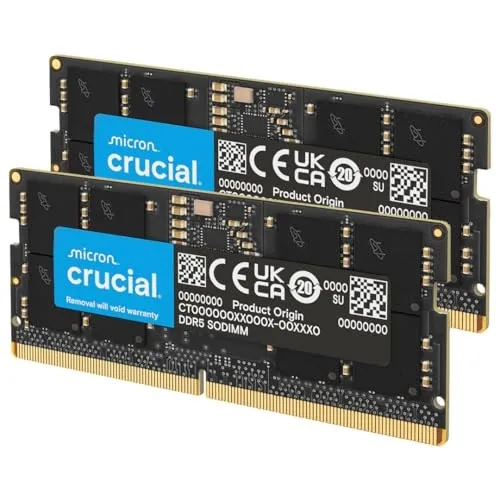
یک هشدار بازار: قیمت رمهای DDR5 SODIMM در حال حاضر متورم است و کیتهای ۶۴ گیگابایتی اغلب بین ۷۵۰ تا ۸۷۰ دلار قیمت دارند. خرید مینیپیسی با رم پیشفرض در حال حاضر بهصرفهتر از ارتقای بعدی است.
استقرار و نکات فنی
کاربران میتوانند مدل را سریعاً از طریق اولاما (Ollama) نسخه ۰.۳۲.۱۲ یا جدیدتر با دستور ollama run qwen3.8:27b اجرا کنند. برای مشاهده آمار از فلگ --verbose و برای حذف مقدمههای استدلالی و دریافت پاسخ سریعتر از --think=false استفاده کنید.
کاربران لاماسیپلاسپلاس (llama.cpp) باید از بهروز بودن بیلد خود مطمئن شوند. نسخههای قدیمی خطای unknown model architecture: 'qwen35' میدهند چون طراحی توجه ترکیبی به هستههای بهروز نیاز دارد. دستور brew update && brew upgrade llama.cpp معمولاً این مشکل را حل میکند. این الزام برای تمام فرانتاندهای مبتنی بر llama.cpp از جمله LM Studio، Jan و koboldcpp صدق میکند.
کاربرد در دنیای واقعی
فراتر از بنچمارکها، این مدل در اتوماسیونهای پسزمینه میدرخشد. پنجره زمینه ۲۶۲,۱۴۴ توکنی اجازه میدهد فیدهای RSS یک هفته را از طریق یک جاب launchd در یک گزارش صبحگاهی فشرده کند.
قابلیتهای چندوجهی آن شکستهای OCR را حل میکند. مدل میتواند PDFهای اسکنشده را بخواند و آنها را طبق قرارداد نامگذاری YYYY-MM-vendor-what-it-is تغییر نام دهد، حتی در چیدمانهای بصری پیچیده که OCRهای سنتی را دچار خطا میکند. همچنین برای خلاصهسازی رشتهتوییتها یا فورومهای تا ۴۰۰ کامنت با تفکیک نظر هر کاربر استفاده میشود.
جایگاه رقابتی
در مقایسه با Gemma 4، این دو مدل اهداف متفاوتی دارند. مدل 26B-A4B در Gemma 4 یک MoE پراکنده است که برای چتهای تعاملی روی سختافزارهای معمولی بسیار سریعتر است. اما جامعه کاربران در حال حاضر Qwen3.8 را برای کدنویسی و گردشکارهای عاملمحور بهطور قابلتوجهی برتر میداند.
این تغییر نشان میدهد که برای دستیارهای پسزمینه، هوشمندی و قابلیت اطمینان بر سرعت خام توکنها اولویت دارد. هدف، مدلی است که بهاندازه کافی باهوش باشد تا وظیفه را بدون نشت داده به APIهای ابری انجام دهد.
اگر در حال ساخت یک استک محلی AI هستید، منتظر انتشار Qwen3.8-Flash-Next باشید. این مدل MoE با ۱۸۰ میلیارد پارامتر و حجم حدود ۱۱۰ گیگابایت در کوانتای Q4، به حافظه یکپارچه ۱۲۸ گیگابایتی نیاز دارد و مرزهای توانایی مینیپیسیها و مک استودیوهای فعلی را جابجا میکند.
گام بعدی شما
- اگر از مک استودیو یا مینیپیسیهای جدید استفاده میکنید، مدل Qwen3.8 را با کوانتای Q4_K_M تست کنید تا تفاوت ایجاز در پاسخها را حس کنید.
- برای اتوماسیون اسناد PDF، قابلیتهای بینایی این مدل را جایگزین OCRهای سنتی کنید.
- اگر به دنبال اجرای مدل روی رمهای محدود (۱۶ گیگابایت) هستید، از کوانتای Q2_K_XL بهجای ۱-بیتی استفاده کنید تا از فروپاشی دقت در کارهای طولانی جلوگیری شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ برای درک محدودیتهای حافظه در مدلهای بزرگتر، به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو