اگر امروز برای پردازش اسناد حجیم به APIهای گرانقیمت متکی هستید، احتمالاً به زودی هزینههای زیرساختی خود را به شدت کاهش خواهید داد. مدل Qwen3.8-27B از تیم Alibaba Cloud دقیقاً در نقطهای قرار گرفته است که شکاف میان اجارهی APIهای متری (Metered API) و مالکیت سختافزار شخصی را پر میکند. در حالی که استارتاپها معمولاً باید بین این دو گزینه یکی را انتخاب کنند، این مدل اجازه میدهد یک واحد پردازش گرافیکی (GPU) ردهبالا، مدلی در سطح تولید را با پنجره متنی (Context Window) — شبیه به میز کاری بسیار بزرگ که جای چندین کتاب قطور را دارد، نه فقط چند ورق — به اندازه یک میلیون توکن (Token) میزبانی کند.
این تغییر رویکرد از یک «نوآوری جذاب» به یک «زیرساخت کاربردی»، بازتابدهنده یک روند گستردهتر در اکوسیستم مدلهای با وزنهای باز است. دو سال پیش، عبارت «مدل با وزنهای باز» به معنای یک اسباببازی بود که شما دانلود میکردید تا فقط یک نکته فنی را ثابت کنید. اما امروز، این مدلها به وابستگیهای حیاتی در محیط تولید تبدیل شدهاند که مستقیماً بر صورت سود و زیان (P&L) یک شرکت تأثیر میگذارند. همانطور که در تحلیل قبلی ما دربارهی کاهش هزینههای مدلهای زبانی برای تیمهای Node.js از طریق اولویتبندی دستهای تیکتها اشاره کردیم، تمرکز صنعت اکنون از کاهش سادهی تعداد درخواستها به سمت انتخاب معماری مناسب برای سختافزارهای موجود تغییر کرده است.
این تحول، آغاز یک سری ۳۰ روزه برای بررسی مدلهای وزنهای باز (Open Weights) — یعنی مدلهایی که دستور پخت آنها علناً منتشر شده و نه فقط غذای آماده — و ابزارهای پیرامون آنها و نقاطی است که در آن سودآوری میکنند. روز اول را به Qwen3.8-27B اختصاص دادیم چون دقیقاً در نقطه تلاقی عملکرد و دسترسی قرار دارد. این مدل در واقع نسخهای بهینهشده و اقتصادی از خانواده مدلهای جدید علیباباست؛ در حالی که مدل Qwen3.8-Max با ۲.۴ تریلیون پارامتر برای پردازشهای عظیم و پیچیده طراحی شده، نسخه ۲۷ میلیاردی بر دسترسیپذیری تمرکز دارد.
برای اکثر توسعهدهندگان، تعداد ۲۷ میلیارد پارامتر (Parameter) یک نقطه استراتژیک است. طبق بررسیهای فنی، این بزرگترین کلاس اندازهای است که معمولاً بدون نیاز به خوشههای پیچیده و توزیع مدل بین چندین گره (Multi-node serving)، روی یک GPU جای میگیرد. این موضوع هزینههای عملیاتی مربوط به مدیریت خوشههای GPU را حذف میکند اما در عین حال، ظرافت و دقت لازم برای انجام کارهای پیچیده را حفظ میکند. این مسئله اقتصادِ «چه کسی میتواند مدل را اجرا کند» را تغییر میدهد، نه فقط اینکه مدل «چقدر خوب» عمل میکند.
مشخصات فنی و هزینه
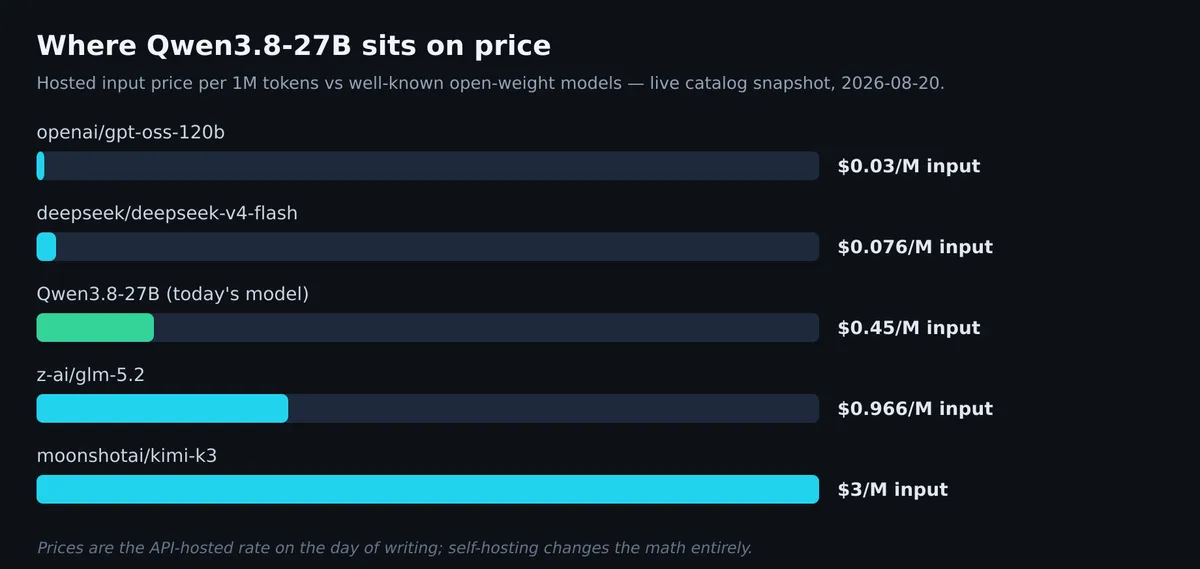
به نقل از دادههای متادیتای ارائه شده توسط OpenRouter، پروفایل اقتصادی این مدل بهگونهای طراحی شده تا قیمتهای APIهای پرچمدار را به چالش بکشد و به تیمها اجازه دهد مدلسازی کنند که آیا اجاره یک GPU بهصرفهتر از پرداخت هزینه به ازای هر درخواست API است یا خیر:
- قیمت ورودی: ۰.۴۵ دلار بهازای هر میلیون توکن
- قیمت خروجی: ۳.۲۰ دلار بهازای هر میلیون توکن
- پنجره متنی: ۱,۰۰۰,۰۰۰ توکن
این پنجره متنی عظیم برای این کلاس از مدلها شگفتانگیز است. این یعنی مدل بهگونهای ساخته شده که میتواند کل یک کدبیس، قراردادهای حقوقی طولانی یا تاریخچههای گستردهی چت را بدون نیاز به «ژیمناستیکهای تکهبندی» (Chunking gymnastics) در حافظه نگه دارد.
بررسیهای عملکردی
به جای تکیه بر بنچمارکهای ایستا و تئوریک، سه آزمون واقعی (Probe) روی کدنویسی، استدلال و خروجی ساختیافته اجرا شد و متن پاسخها برای تأیید قابلیت اطمینان بررسی گردید.
آزمون کدنویسی
از مدل خواسته شد تابع merge_intervals را بنویسد و یک یادداشت تکجملهای درباره پیچیدگی زمانی آن ارائه دهد. خروجی مدل، بازههای همپوشان را بهدرستی مرتب و ادغام کرد؛ هیچ خطای «یکی-کمتر/یکی-بیشتر» (off-by-one) وجود نداشت و تمام حالتهای لبهای (Edge cases) برای ورودیهای خالی بهدرستی مدیریت شدند. مدل در نهایت با این جمله پاسخ داد: «O(n log n) است زیرا مرتبسازی بازهها بر مرحله ادغام خطی غلبه میکند»، که پاسخی کاملاً درست و با استدلال دقیق بود.
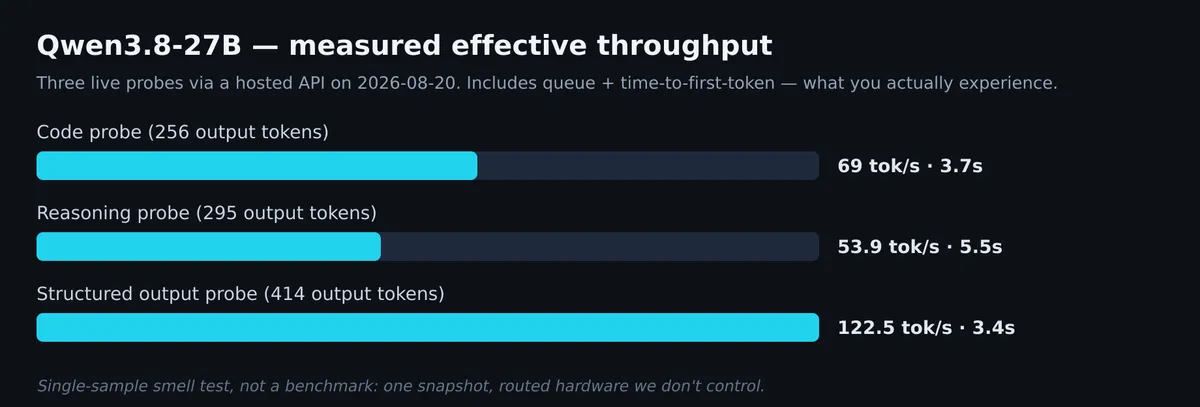
- تأخیر: ۳.۷ ثانیه
- تولید: ۲۵۶ توکن
- توان عملیاتی: ۶۹ توکن در ثانیه
آزمون استدلال
این یک مسئله ریاضی از نوع «پمپ و تخلیه» بود که نیاز به محاسبه نرخ پر شدن خالص در حالی که هر دو پمپ فعال هستند، محاسبه حجم باقیمانده و زمان لازم برای اتمام کار تنها با یک پمپ فعال داشت. محاسبات ریاضی در هر مرحله درست بود: نرخ خالص ۳۰ لیتر در دقیقه، ۶۰۰ لیتر پس از ۲۰ دقیقه، ۱,۸۰۰ لیتر باقیمانده و ۲۰ دقیقه دیگر با نرخ ۹۰ لیتر در دقیقه برای رسیدن به پاسخ نهایی.
- تأخیر: ۵.۵ ثانیه
- تولید: ۲۹۵ توکن
- توان عملیاتی: ۵۳.۹ توکن در ثانیه
آزمون خروجی ساختیافته
بحرانیترین تست برای محیط تولید، استخراج نام فروشنده، تاریخ و مبلغ کل از یک رشته متنی فاکتور به صورت JSON سختگیرانه بود. شیء بازگشتی کاملاً معتبر بود و دقیقاً با طرح (Schema) درخواستی مطابقت داشت. هیچ علامت Markdown (مانند ```json)، هیچ مقدمه توضیحی و هیچ کامنت اضافی در خروجی وجود نداشت. این ویژگی اجازه میدهد خروجی مستقیماً به یک پارسر (Parser) در مراحل بعدی منتقل شود بدون اینکه نیاز به پاکسازی با Regex باشد.
- تأخیر: ۳.۴ ثانیه
- تولید: ۴۱۴ توکن
- توان عملیاتی: ۱۲۲.۵ توکن در ثانیه
چه کسانی بیشترین سود را میبرند؟
قابلیتهای مدل تنها زمانی مفید است که با یک شغل و محدودیت خاص تطبیق داده شود. Qwen3.8-27B برای چهار گروه کاربردی است:
- میزبانی شخصی با تمرکز بر حریم خصوصی: کسانی که سیستمهای پرسشوپاسخ روی اسناد داخلی، جستجوی سازمانی یا عاملهایی برای تحلیل قراردادها و لاگهایی دارند که هرگز نباید از شبکه خارج شوند. پنجره یک میلیون توکنی اجازه میدهد کل یک مجموعه داده (Corpus) در حافظه فعال بماند، بهجای استفاده از خط لولههای شکننده تولید بازیابیافزا (RAG) که از تکههای ۴ هزار توکنی دوخته شدهاند.
- استارتاپهای حساس به هزینه API: تیمهایی که بودجههای زیادی را صرف APIهای پرچمدار برای استخراج ساختیافته، بررسی کد یا استدلالهای داخلی میکنند. با قیمتهای ۰.۴۵ و ۳.۲۰ دلار بهازای هر میلیون توکن، دلیل واقعی برای میزبانی شخصی کارهایی مثل تحلیل فاکتورها، استخراج رکورد از لاگها و دیجیتالی کردن فرمها وجود دارد.
- متخصصان تنظیم دقیق: یک مدل متراکم (Dense) ۲۷ میلیاردی، هدفی رایج برای تنظیم دقیق از طریق روش لورا (LoRA) یا تنظیم دقیق کامل است. این مدل بهاندازه کافی بزرگ است تا پس از انطباق، ظرافتهای زبانی را حفظ کند، اما بهاندازه کافی کوچک است که برای اجرا به یک خوشه GPU نیاز نداشته باشد. این مدل یک پایه توانمند برای کسانی است که نمیخواهند یک مدل را از صفر آموزش دهند.
- سازندگان عاملهای با زمینه بلند: پنجره یک میلیون توکنی که در متادیتا تأیید شده، امکان اجرای کارهایی را فراهم میکند که در مدلهای کوچکتر جا نمیشوند؛ مانند بررسی کد در کل یک مخزن (Whole-repo code review)، مقایسههای حقوقی بین چندین سند یا حافظه نشست (Session memory) که کل یک روز کاری را بدون نیاز به لایه خلاصهسازی پوشش دهد.
موازنه عملیاتی
این مدل برای تیمهایی که به دنبال سقف مطلق عملکرد استدلالی بدون توجه به هزینه هستند، مناسب نیست. همچنین برای کسانی که میخواهند از بارِ میزبانی، نظارت (Monitoring) و بهروزرسانی وزنها دوری کنند، گزینه مناسبی نیست. قیمت پایینتر هر توکن، در واقع یک معامله است: شما هزینه کمتر را در ازای تلاش عملیاتی برای مدیریت استک استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند — به دست میآید.
باید توجه داشت که این سه آزمون تنها یک «تست دود» (Smoke test) بودند و یک مجموعه بنچمارک کامل محسوب نمیشوند. اگرچه نتایج تمیز بودند، اما اینها شواهدی از صلاحیت در الگوهای رایج هستند، نه دلیلی بر بینقص بودن در وظایف خصمانه (Adversarial) یا بسیار تخصصی.
علاوه بر این، در حالی که متادیتا ادعای پنجره یک میلیون توکنی را دارد، این موضوع هنوز تحت فشار شدید بازیابی (Retrieval pressure) در انتهای بازه متنی بهطور مستقل تأیید نشده است. کاربران باید قبل از شرطبندی روی کل بازه پنجره متنی برای یک پروژه تولیدی، اسناد طولانی خود را تست کنند.
انتقال به میزبانی محلی با تکامل ابزارهای پیرامون این وزنها در حال آسانتر شدن است. در قسمت بعدی، از مدل فاصله میگیریم و به سراغ ابزاری میرویم که اکثر مردم برای اجرای محلی از آن استفاده میکنند: اولاما (Ollama) و اینکه چگونه تجربه «فقط یک فایل GGUF دانلود کن و اجرا کن» را تغییر داده است.



گفتگو