اگر امروز برای اجرای مدلهای استدلالی سنگین با تأخیرهای طولانی دستوپنجه نرم میکنید، مدل Beam میتواند قواعد بازی را تغییر دهد. این مدل ثابت میکند که میتوان ظرفیت یک غول ۵۰۱ میلیارد پارامتری را در کالبد سرعت یک مدل ۲۳ میلیارد پارامتری جای داد.
به نقل از مستندات منتشر شده در ۱۶ اکتبر ۲۰۲۶، مدل Beam محصول آزمایشگاه آمریکایی Reflection است. این مدل یک مدل با وزنهای باز (Open-weights) از نوع ترکیب خبرهها (Mixture of Experts یا MoE) است که بهطور خاص برای وظایف عاملمحور (Agentic tasks) و کدنویسی در مقیاس پیشرو طراحی شده است.
bیشتر مدلهای باز، توسعهدهندگان را مجبور به انتخاب بین ظرفیت و سرعت میکنند. شما یا از یک مدل کوچک استفاده میکنید که سریع است اما فاقد استدلال عمیق است، یا از یک مدل عظیم که در زمان استنتاج (Inference) بسیار کند عمل میکند. Beam تلاش میکند این سقف را با استفاده از معماری MoE پراکنده (Sparse) بشکند، بهطوری که در هر توکن، تنها بخشی از شبکه فعال باشد.
این عرضه در حالی صورت میگیرد که صنعت به سمت هوش مصنوعی عاملمحور (Agentic AI) حرکت میکند؛ سیستمهایی که نه تنها چت میکنند، بلکه از ابزارها استفاده کرده و وضعیتهای بلندمدت را برای حل مسائل پیچیده مهندسی مدیریت میکنند. Reflection با ارائه مدلی در این مقیاس تحت لایسنس Apache 2.0، تیمهایی را هدف قرار داده است که به قابلیتهای سطح پیشرو روی سختافزار خصوصی، زیرساختهای داخلی یا ابر شخصی خود نیاز دارند.
معماری و بهرهوری حافظه
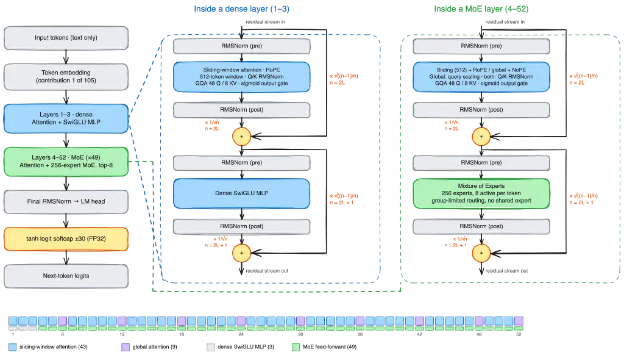
مدل Beam یک مدل MoE پراکنده با ۵۰۱ میلیارد پارامتر کل است، اما در هر توکن تنها ۲۳ میلیارد پارامتر فعال هستند. این مدل شامل ۵۲ لایه با اندازه پنهان (Hidden size) ۵,۱۲۰ است. سه لایه نخست بهصورت متراکم (Dense) با ساختار SwiGLU MLP هستند، در حالی که ۴۹ لایه باقیمانده بلوکهای MoE هستند که هر کدام شامل ۲۵۶ خبره میباشند. هر خبره یک SwiGLU MLP با اندازه میانی ۲,۵۶۰ است که حدود ۳۹ میلیون پارامتر را در بر میگیرد. این خبرهها در مجموع ۹۸.۴٪ از کل پارامترهای مدل را تشکیل میدهند.
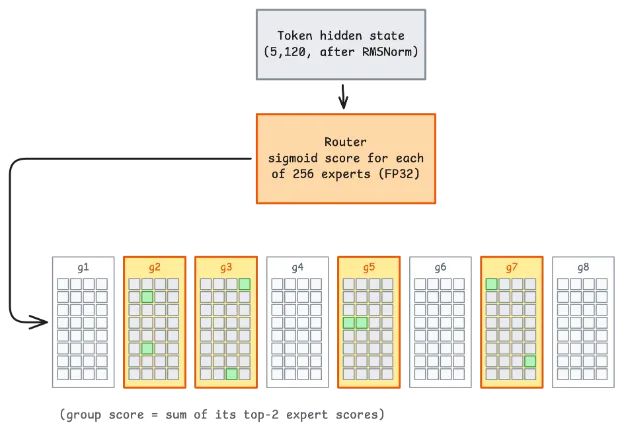
سیستم مسیریابی (Routing) از طرح محدودسازی گروهی DeepSeek-V3 پیروی میکند. مسیریاب تمام ۲۵۶ خبره را با یک تابع سیگموئید امتیازدهی کرده و آنها را به ۸ گروه ۳۲تایی تقسیم میکند. سپس ۴ گروه برتر (که بر اساس مجموع دو امتیاز اول هر گروه رتبهبندی شدهاند) را نگه میدارد و در نهایت ۸ خبره برتر را از داخل این گروهها انتخاب میکند. خروجی خبرهها با وزنهای نرمالشدهی مسیریاب ترکیب شده و در عدد ۲.۵ ضرب میشوند.
برای مدیریت اثر شدید این مدل بر حافظه، Reflection سه فرمت نقطه بازرسی (Checkpoint) ارائه داده است:
- BF16: نسخه با دقت کامل که در فرمت safetensors به حدود ۱ ترابایت حافظه نیاز دارد.
- FP8: بهینهشده برای پردازندههای گرافیکی NVIDIA Hopper و Ampere.
- NVFP4: یک فرمت دقت ۴ بیتی برای پردازندههای NVIDIA Blackwell که حجم مدل را به حدود ۲۸۰ گیگابایت کاهش میدهد. در این فرمت، اکثر پارامترها ۴ بیتی ذخیره میشوند، اما برخی برای حفظ دقت در حالت BF16 باقی میمانند.
پنجره متنی یک میلیون توکنی
یکی از برجستهترین ویژگیهای Beam، پنجره متنی (Context Window) به اندازه یک میلیون توکن است. برای جلوگیری از انفجار حافظه در حافظه پنهان (Cache)، مدل از یک مکانیزم توجه ترکیبی (Hybrid Attention) استفاده میکند.
در این ساختار، ۴۳ لایه از ۵۲ لایه مدل، از توجه پنجرهای لغزان (Sliding-window attention) روی ۵۱۲ توکن قبلی استفاده میکنند. تنها ۹ لایه جهانی (هر ششمین لایه و لایه آخر) به کل متن توجه دارند. این ترفند باعث میشود رشد حافظه پنهان (KV Cache) از ۲۰۸ کیلوبایت در هر توکن به تنها ۳۶ کیلوبایت کاهش یابد که تقریباً یکششم نرخ معمول است.
مکانیزمهای توجه و مقیاسبندی
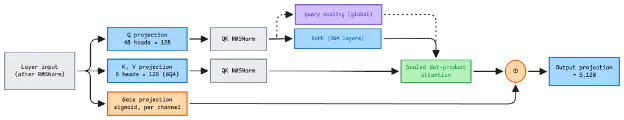
مدل Beam بسته به نوع لایه، موقعیتها را متفاوت مدیریت میکند. لایههای پنجرهای لغزان از RoPE (جایگذاری موقعیتی چرخشی) استفاده میکنند زیرا موقعیت نسبی در پنجرههای کوتاه حیاتیتر است. لایههای جهانی از هیچ رمزگذاری موقعیتی استفاده نمیکنند؛ در عوض، آنها از «مقیاسبندی پرسوجوی سافتمکس مقیاسپذیر» بهره میبرند که در آن هر پرسوجو در یک اسکالر ضرب میشود: (1 + (pos + 1) / 2048) ** 0.1.
این مکانیزم مانند یک کنترل دمای عمل میکند و تضمین میکند که سافتمکس با افزایش طول متن، به جای تخت شدن، دقت خود را حفظ کند. سیستم توجه از توجه پرسوجوی گروهی (GQA) با ۴۸ سر پرسوجو و ۸ سر کلید-مقدار استفاده میکند و از RMSNorm روی پرسوجوها و کلیدها بهره میبرد. یک گیت سیگموئید یادگرفتهشده، هر کانال از هر سر را قبل از تصویرسازی خروجی مقیاسبندی میکند.
نوآوری در جریان باقیمانده (Residual Stream)
تیم Reflection اتصالات باقیمانده را بازطراحی کرده تا مقیاس شبکه در تمام عمق ثابت بماند. در ترنسفورمرهای استاندارد، جریان با افزایش عمق رشد میکند زیرا خروجی هر زیرلایه با وزن ۱ اضافه میشود.
در Beam، جاسازی ورودی (Input embedding) به عنوان گام ۱ شمرده میشود. در گام k، خروجی زیرلایه با وزن 1/sqrt(k) اضافه شده و جریان موجود با وزن sqrt((k-1)/k) حفظ میشود. چون مجموع مربعات این وزنها برابر با یک است، جریان در مقیاسی ثابت میماند. پس از ۱۰۴ مرتبه اضافه شدن، هر خروجی زیرلایه و جاسازی ورودی، وزن یکسانی در حالت پنهان نهایی دارند.


برای تضمین دقت، پیادهسازی مدل برخی محاسبات خاص را در دقت FP32 تثبیت کرده است: مسیریاب، ضرب SwiGLU، نرمالسازیها، RoPE، مقیاسبندی پرسوجو و لوجیتهای نهایی که از یک tanh softcap در ±۳۰ عبور میکنند.
عملکرد و بنچمارکها
طبق گزارش فنی منتشر شده در huggingface.co، مدل Beam در کدنویسی عاملمحور و استدلال در دقتهای BF16، FP8 و NVFP4 نتایج قدرتمندی نشان داده است:
کدنویسی عاملمحور و ترمینال:
- SWE Bench Pro v2-Hard: از ۷۶.۵٪ (BF16) تا ۷۸.۶٪ (NVFP4)
- SWE Bench Verified: از ۸۱.۶٪ (BF16) تا ۸۰.۷٪ (NVFP4)
- Terminal Bench v2.1: از ۸۰.۱٪ (BF16) تا ۷۸.۲٪ (NVFP4)
- DeepSWE v1.1: از ۴۳.۳٪ (BF16) تا ۴۲.۷٪ (NVFP4)
- SWEBench Multilingual: از ۷۸.۳٪ (BF16) تا ۷۷.۵٪ (NVFP4)
- SWE Atlas Codebase QnA: از ۳۱.۸٪ (BF16) تا ۳۱.۴٪ (NVFP4)
استدلال و قابلیتهای عمومی:
- AIME 2026: از ۹۷.۷٪ (BF16) تا ۹۷.۵٪ (NVFP4)
- GPQA Diamond: از ۹۰.۶٪ (BF16) تا ۸۹.۳٪ (NVFP4)
- LiveCodeBench: از ۸۸.۳٪ (BF16) تا ۸۷.۴٪ (NVFP4)
- HLE (با ابزارها): ۵۱.۱٪ در تمام دقتها
- HLE (بدون ابزار): از ۳۶.۰٪ (BF16) تا ۳۴.۸٪ (NVFP4)
- SciCode: از ۴۹.۲٪ (BF16) تا ۴۶.۹٪ (NVFP4)
- CriPT AA: از ۱۶.۳٪ (BF16) تا ۱۵.۴٪ (NVFP4)
- LongBench v2: از ۶۷.۵٪ (BF16) تا ۶۷.۲٪ (NVFP4)
- IFBench: از ۷۹.۶٪ (BF16) تا ۷۹.۲٪ (NVFP4)
- AA-LCR: از ۷۸.۲٪ (BF16) تا ۷۸.۷٪ (NVFP4)
- AA Omniscience (index): از ۱۰.۸ (BF16) تا ۹.۸ (NVFP4)
فراخوانی ابزار و جستوجو:
- MCP Atlas: از ۸۰.۸٪ (BF16) تا ۸۰.۵٪ (NVFP4)
- DeepSearchQA (با مدیریت متن): از ۸۰.۵٪ (BF16) تا ۸۱.۱٪ (NVFP4)
- BrowseComp (با مدیریت متن): از ۷۶.۸٪ (BF16) تا ۷۵.۶٪ (NVFP4)
- Tau3 Banking: از ۳۶.۱٪ (BF16) تا ۳۵.۴٪ (NVFP4)
- AutomationBench (بخش عمومی): از ۳۹.۳٪ (BF16) تا ۳۹.۸٪ (NVFP4)
این مدل پنج سطح استدلال متمایز را پشتیبانی میکند: "low"، "medium" (پیشفرض)، "high"، "xhigh" و "max". همچنین دارای قابلیت preserve_thinking برای حفظ استدلال در متن در طول نوبتهای گفتگو و یک گرامر اختصاصی برای فراخوانی ابزارها است.
سختافزار و استقرار
اجرای Beam به توان محاسباتی قابلتوجهی نیاز دارد. برای نقطه بازرسی NVFP4، Reflection چهار GPU مدل B200 (مجموع ۷۲۰ گیگابایت HBM3e) را توصیه میکند تا فضای کافی برای فعالسازها و حافظه KV باقی بماند. یک عدد B200 دارای ۱۸۰ گیگابایت HBM3e است؛ دو عدد B200 (۳۶۰ گیگابایت) میتوانند وزنها را نگه دارند اما فضای کمی برای متون طولانی باقی میگذارند.
سایر گزینههای سختافزاری عبارتند از:
- گره کامل 8xB200
- دو عدد B300 (هر کدام ۲۸۸ گیگابایت)
- ۸ عدد RTX Pro 6000
- ۱۶ عدد GPU H200 (برای BF16، جایی که هر GPU حدود ۷۸ گیگابایت از وزنها را نگه میدارد)
مدل Beam از روز اول با vLLM، SGLang و transformers سازگار است. همچنین شامل یک هارنس سفارشی مبتنی بر Rust برای حداکثر عملکرد است و از رمزگشایی گمانهزنانه DFlash2 پشتیبانی میکند. در DFlash2، یک مدل پیشنویس (Drafter) تا ۱۵ توکن جلوتر را پیشنهاد میدهد و Beam آنها را در یک پاس رفت (Forward pass) بررسی میکند.
جزئیات پیادهسازی
برای کسانی که از طریق transformers استقرار میدهند، مدل از یک قالب پاسخ در توکنایزر استفاده میکند. متد parse_response این قالب را میخواند تا خروجی خام را به استدلال، پاسخها و فراخوانیهای ابزار تقسیم کند و نیاز به Regexهای سفارشی را از بین میبرد. آرگومانهای فراخوانی ابزار در یک گرامر سبک XML نوشته میشوند و پارسر از طرحهای ابزار (Tool schemas) برای تبدیل این آرگومانها به انواع تعریفشده استفاده میکند.
تنظیمات چند-GPU از یک طرح موازیسازی خبره (Expert-parallel plan) استفاده میکنند. این طرح هر خبره را روی یک دستگاه قرار میدهد در حالی که لایههای توجه، لایههای متراکم، جاسازیها و سر LM (حدود ۸ میلیارد پارامتر یا ۱۶ گیگابایت در BF16) را روی تمام دستگاهها تکثیر میکند. تعداد دستگاهها باید مقسومی از ۲۵۶ خبره باشد.
پسآموزش و شخصیسازی
Reflection دستورالعملهایی برای هر دو روش تنظیم نظارتشده (SFT) و یادگیری تقویتی (RL) ارائه کرده است. با استفاده از TRL و آداپتورهای LoRA از طریق PEFT، تیمها میتوانند Beam را بدون بهروزرسانی تمام ۵۰۱ میلیارد پارامتر تطبیق دهند.
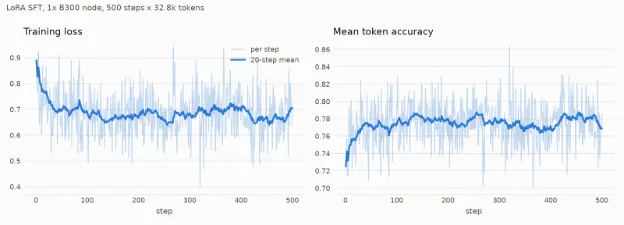
در یک آزمایش، Beam روی Multilingual-Thinking تنظیم شد. پس از یک اپوک (Epoch)، مدل در ۱۶ مورد از ۱۶ پرامپت آزمونی به زبان درخواستی استدلال کرد، در حالی که مدل پایه تنها در ۳ مورد موفق بود. این تنظیمات روی یک گره با ۸ عدد GPU B300 به سرعت ۱۹,۰۰۰ توکن در ثانیه رسید. همچنین یک اجرای ۵۰۰ مرحلهای روی زیرمجموعه استدلالی open-r1/Mixture-of-Thought انجام شد.
برای RL، تیم با RadixArk همکاری کرد تا GRPO (بهینهسازی سیاست نسبی گروهی) را از طریق Miles پیادهسازی کند. این امکان آموزش RL را بهصورت تمام-پارامتر یا مبتنی بر LoRA فراهم میکند.
پیکربندیهای آموزش GRPO:
- GRPO تمام-پارامتر (BF16): نیاز به ۹۶ عدد H200 (۶۴ برای آموزش، ۳۲ برای rollout) یا ۶۴ عدد H200 هممکان دارد.
- GRPO لورا (BF16): نیاز به ۳۲ عدد H200 (۱۶ آموزش، ۱۶ rollout) دارد.
- GRPO تمام-پارامتر (متن ۱۲۸ توکنی): نیاز به ۴۸ عدد H200 (۳۲ آموزش، ۱۶ rollout) دارد.
این فرآیند شامل نمونهبرداری از ۳۲ پرامپت با ۸ پاسخ برای هر کدام، امتیازدهی به پاسخهای باکسشده در برابر برچسبها (با جریمه نرم برای پاسخهای محدود به طول) و بهروزرسانی از طریق Adam با نرخ ثابت 1e-6 است. گرههای آموزش به ۲ ترابایت NVMe برای استریم وضعیت بهینهساز نیاز دارند. گرادینتها در BF16، وزنهای اصلی در FP32 و گشتاورها در BF16 هستند.
دموهای کاربردی عاملمحور
برای اثبات کاربرد مدل، تیم چندین دمو را با استفاده از هارنس کدنویسی Pi ساخت:
- BeamSpeak: یک اپلیکیشن نوار منوی بومی macOS برای تبدیل گفتار به متن محلی. این برنامه از MLX و مدل Parakeet v3 برای تبدیل محلی صدا و چسباندن آن در مکان مکاننما با استفاده از مجوزهای Accessibility استفاده میکند. این برنامه دارای یک دکمه ضبط فشرده، میانبرهای ⌘⇧Space و محدودیت ضبط دو دقیقهای است.
- مقیاسبندی چندعاملی: مطالعهای با استفاده از ProgramBench که در آن عاملها برنامهها را از روی فایلهای اجرایی بازسازی میکنند. تیم یک عامل واحد، پنج همتا دائمی از طریق Git و یک عامل رهبر با زیر-عاملهای ناهمگام را مقایسه کرد. مدل تفویض عامل رهبر در سقف ۸ میلیون توکن، پیشرفت برتری در وظایفی مانند jq، xsv، FIGlet و hexyl نشان داد.
- تقطیر مدل تصمیمگیر: Beam برای تبدیل یک سیاست تریاژ حوادث به یک مجموعه داده مصنوعی از ۲.۳ هزار حادثه استفاده شد. این دادهها برای تنظیم یک مدل Qwen3.5-0.8B از طریق Unsloth به کار رفتند. مدل تصمیمگیر حاصل به دقت ۷۶.۲۵٪ رسید (در مقابل ۴.۶۹٪ در حالت zero-shot) و تأخیر را از ۱,۲۱۸.۰۶ میلیثانیه به ۱۰۲.۵۸ میلیثانیه کاهش داد.
تحلیل: تغییر به سمت مدلهای پیشرو محلی
مدل Beam نشاندهنده یک حرکت استراتژیک برای دموکراتیزه کردن وزنهای «مقیاس پیشرو» است. تا کنون، مدلهایی با بیش از ۵۰۰ میلیارد پارامتر عمدتاً در اختیار ارائهدهندگان APIهای بسته بود. Reflection با انتشار وزنها و دستورالعملهای استنتاج، کلاس جدیدی از «هوش مصنوعی حاکمیتی» (Sovereign AI) را برای سازمانها فعال میکند.
برای توسعهدهنده، مهمترین نکته، پنجره متنی ۱ میلیون توکنی در ترکیب با بهرهوری MoE است. این امر به یک عامل اجازه میدهد تا کل یک کدبیس را جذب کرده و بدون تأخیرهای معمول مدلهای این اندازه، روی آن استدلال کند. پشتیبانی از NVFP4 همچنین سیگنالی است مبنی بر اینکه عصر بعدی هوش مصنوعی باز، بهطور جداییناپذیری با سختافزار Blackwell گره خورده است.
Reflection با ارائه ۱۰,۰۰۰ دلار اعتبار Hub برای بهترین پروژههای مبتنی بر Beam، جامعه را تشویق میکند. پروژههای واجد شرایط شامل ساخت دمو در Spaces، کوانتیزه کردن مدل برای سختافزارهای جدید، تولید مجموعههای داده مصنوعی، ساخت محیطهای RL یا اشتراکگذاری بنچمارکهای دقیق است.
اگر در حال ساخت جریانهای کاری عاملمحور هستید، گام بعدی تست سطوح استدلال Beam روی کدبیس خاص خود از طریق ارائهدهندگان استنتاج Hugging Face یا استقرار نقطه بازرسی NVFP4 روی یک کلاستر B200 است.



گفتگو