تصور کنید صاحب یک کافه یا سالن زیبایی هستید و یک مشتری عصبانی در گوگل برای شما یک ستاره گذاشته است؛ حالا یک دستیار هوش مصنوعی به شما پاسخی پیشنهاد میدهد که به اشتباه وعده استرداد وجه میدهد، در حالی که سیاست فروشگاه شما هرگز چنین چیزی نیست. این دقیقاً همان نقطهای است که ReplyDesk وارد عمل میشود تا نرخ «وعدههای بدون پشتوانه» را در سناریوهای پرفشار به ۱۴٪ کاهش دهد. این ابزار برای صاحبان کسبوکارهای کوچک — مانند تعمیرگاهها، سالنهای زیبایی، دندانپزشکان، کافهها، لولهکشها و فروشگاههای کوچک — طراحی شده است که برای حفظ یک حضور حرفهای در پروفایلهای تجاری گوگل (Google Business Profiles) دستوپنجه نرم میکنند، اما نمیخواهند ساعتها وقت خود را صرف نوشتن دستی پاسخها کنند.
بسیاری از صاحبان کسبوکارهای کوچک بین دو راه سخت گیر کردهاند: یا نظرات مشتریان را نادیده بگیرند یا از دستیارهای هوش مصنوعی کلیشهای استفاده کنند که لحنی شبیه به بانکها دارند. این ابزارها معمولاً جملاتی بیروح و تکراری مثل «از اینکه وقت گذاشتید و بازخورد ارزشمند خود را به اشتراک گذاشتید سپاسگزاریم، ما تلاش میکنیم تا...» تولید میکنند که مشتریان بهسرعت متوجه مصنوعی بودن آن میشوند. همانطور که پیشتر بررسی کردیم که چگونه دانشجویان از ابزارهایی مانند Google AI Studio برای ساخت بازیهای تخصصی استفاده میکنند، ReplyDesk نیز روح مشابهی از هوش مصنوعی کاربردی را برای یک مسئله تجاری حساس به کار میگیرد: مدیریت اعتبار مشتری. هدف اینجاست که پیشنویسی تولید شود که شبیه به لحن یک صاحب کسبوکار واقعی باشد اما بهشدت به سیاستهای واقعی فروشگاه پایبند بماند. این رویکرد بر اهمیت نظارت انسانی تأکید دارد، مشابه آنچه در بررسی مزایای بازبینی انسانی در برابر تولید آنی متن برای فروشندگان آنلاین مشاهده کردیم.
به نقل از مستندات فنی منتشر شده در ۱۷ اکتبر ۲۰۲۶، ReplyDesk صرفاً یک لایه ساده روی پرامپتها (Prompt Wrapper) نیست، بلکه سیستمی تخصصی است که یک مدل زبانی کوچک با وزنهای باز (Open-weights) را با یک لایه حافظه برای حقایق فروشگاه ترکیب میکند. این معماری تضمین میکند که اگر فروشگاهی خدمات بازبینی رایگان ارائه نمیدهد، هوش مصنوعی بهطور تصادفی چنین وعدهای به یک مشتری عصبانی ندهد.
زیرساخت فنی این پروژه بر پایه Next.js 16، React 19 و Tailwind 4 بنا شده و از drizzle-orm و bun استفاده میکند. برای بخش هوش مصنوعی، توسعهدهنده از Tinker برای تنظیم دقیق (Fine-tuning) — یعنی شبیه به وقتی که به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — و سرویسدهی آن از طریق یک نقطه اتصال سازگار با OpenAI استفاده کرده است. کل هزینه توسعه، شامل چهار دور آموزش، تقریباً ۷.۷۰ دلار بود. حدود ۴ دلار از این مبلغ صرف سه دور اول آموزش و ارزیابیهای آنها شد و باقیمانده هزینه مربوط به دادههای آموزشی نسخه چهارم (v4 teacher data)، آموزش و تستها بود.
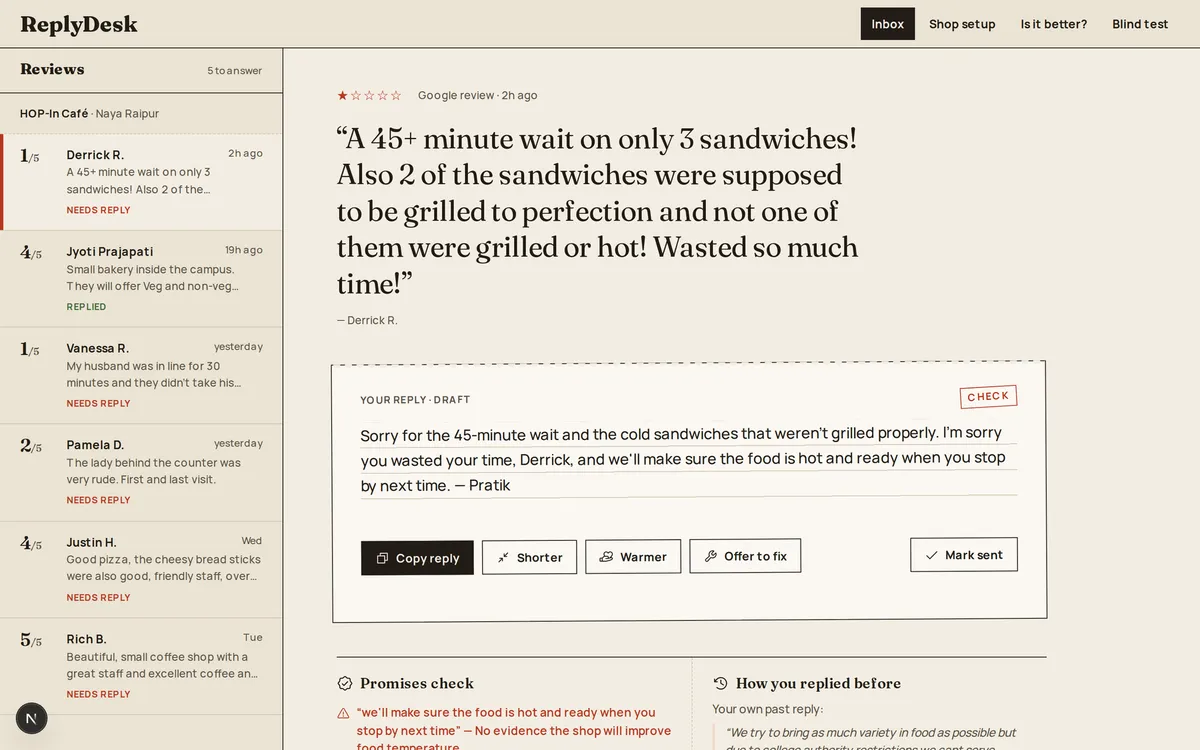
تجربه کاربری برنامه در چهار صفحه اصلی سازماندهی شده است تا صاحب فروشگاه را در این مسیر راهنمایی کند:
- Inbox: جایی که صاحب کار نظر مشتری، پیشنویس تولید شده توسط هوش مصنوعی، نتایج بررسی وعدهها و پاسخهای مشابه از سایر فروشگاهها را مشاهده میکند.
- Shop Setup: جایی که صاحب کار نوع فروشگاه خود را تعریف میکند، حقایق خاص فروشگاه را ذخیره میکند و پاسخهای قدیمی خود را آپلود میکند تا مدل بتواند لحن او را یاد بگیرد.
- Is it better?: یک صفحه ارزیابی زنده که مستقیماً از پایگاهداده میخواند تا عملکرد مدل را نمایش دهد.
- Blind Test: یک مقایسه رودررو که در آن کاربران بین دو پاسخ متفاوت به یک نظر واحد، یکی را انتخاب میکنند.
نکته حیاتی این است که سیستم هرگز بهطور خودکار پاسخی را منتشر نمیکند. صاحب کسبوکار باید متن را ویرایش، کپی و سپس در پروفایل تجاری گوگل منتشر کند تا نظارت انسانی بر تصویر عمومی کسبوکار حفظ شود.
بر اساس بررسیهای فنی، مهندسی پرامپت ساده در این پروژه شکست خورد. توسعهدهنده دریافت که حتی با وجود یک دفترچه قوانین مفصل و طولانی، مدل در ۳۱٪ از موارد هنگام مواجهه با نظرات یکستاره و عصبانی، وعده استرداد وجه میداد. برای حل این مشکل، سازنده یک خط لوله دادههای مصنوعی با استفاده از مجموعه دادههای Google Local Reviews از آزمایشگاه McAuley در UCSD ایجاد کرد.
این فرآیند با ۵۹۰,۰۵۴ جفت داده از چهار ایالت (وایومینگ، ورمونت، مونتانا و ایداهو) شروع شد. توسعهدهنده دادهها را به ۵۰,۹۵۴ جفت باکیفیت فیلتر کرد. فیلترها باعث حذف قالبهای تکراری، ترجمههای ماشینی، جزئیات تماس و فروشگاههای زنجیرهای شدند و تنها پاسخهای انگلیسی در بازه ۶۰ روزه که با نظر مشتری در شش نوع فروشگاه اشتراک کلمات داشتند، حفظ شدند.
مسیر رسیدن به مدل نهایی شامل چهار نسخه متمایز بود که هر کدام یک شکست خاص را حل میکردند:
- v1: روی تمام جفتهای پاک آموزش دید اما عادتهای بدی گرفت، مانند بحث کردن با مشتریان (مثلاً: «کمرون، شما واضحاً گیج شدهاید. ما شما را در فروشگاه ندیدیم.»).
- v2: پاسخهایی که بحث میکردند یا از عبارات کلیشهای محض استفاده میکردند حذف شدند. نتیجه مودبانه بود اما بیش از حد بیروح و خستهکننده شد.
- v3: پاسخهای طولانیتر که به جزئیات خاص نظر مشتری اشاره میکردند حفظ شدند. اگرچه لحن آن بیشتر شبیه صاحب کار بود، اما تنها در ۵۹٪ موارد به جزئیات مشتری اشاره میکرد و در تستهای کور (Blind Tests) شکست خورد.
- v4: نسخه نهایی که با استفاده از روش «استاد-شاگرد»، یک دفترچه قوانین را به دادههای آموزشی تبدیل کرد.
جزئیات خط لوله v4 به شرح زیر است:
- استادها: دو مدل باز بزرگتر، یعنی gpt-oss-120b و Qwen3.6-35B-A3B، برای تولید پاسخهای باکیفیت به ۲,۵۰۰ نظر (با دو تلاش برای هر کدام) استفاده شدند.
- قوانین: به این مدلهای استاد، یک راهنمای سبک سختگیرانه و سه پاسخ واقعی از صاحبان کسبوکار در همان صنف و با همان سطح ستاره داده شد. نیمی از نظرات شامل ۱ تا ۳ «حقیقت فروشگاه» (مثلاً: «بازبینی رایگان ظرف ۷ روز») بودند.
- فیلتر: کدهای برنامهنویسی هر پاسخی را که بیش از حد طولانی یا کوتاه بود، جزئیات بازبین را نادیده گرفته بود، از عبارات کلیشهای استفاده کرده بود، بحث کرده بود، امضای رسمی داشت یا وعده استرداد وجه، تخفیف، هدیه رایگان یا تماس تلفنی (که در حقایق فروشگاه نبود) داده بود، حذف کردند.
- شاگرد: مدل Qwen3.5-4B سپس روی این مجموعه دادههای گلچینشده (۲,۵۸۴ ردیف آموزشی، ۲ اپوک) با استفاده از LoRA rank 32 و دستورالعمل supervised tinker-cookbook تنظیم شد. در این حالت، Loss تنها روی پاسخ اعمال شد و قابلیت استدلال (Reasoning) از طریق
reasoning_effort: falseغیرفعال گردید.
نتایج نشاندهنده جهشی بزرگ در قابلیت اطمینان نسبت به پرامپتنویسی استاندارد است. در آزمونی روی ۱۵۰ نظر واقعی یک و دو ستاره که تقاضای استرداد وجه داشتند، مدل v4 در ۶۹٪ موارد تمام قوانین را رعایت کرد، در حالی که مدل با پرامپت کوتاه تنها ۵٪ و مدل با پرامپت طولانی ۴۹٪ موفق بود.
مهمتر از آن، «بررسی وعده» (Promise Check) — یک مرحله تأیید مجزا با استفاده از gpt-oss-20b — تأیید کرد که مدل تنظیمشده تنها در ۱۴٪ موارد وعدههای بدون پشتوانه داده است، در حالی که نسخه مبتنی بر پرامپت طولانی در ۳۱٪ موارد شکست خورد. این ثابت میکند که تنظیم دقیق (Fine-tuning) میتواند «عادت» مدل را به گونهای تغییر دهد که پرامپتنویسی قادر به آن نیست. برای استانداردسازی چنین ارزیابیهایی و حذف توهمات، ابزارهایی مانند روباریک JudgeMyAI راهکارهای دقیقی برای سنجش پاسخهای مدل ارائه میدهند.
سایر معیارهای کلیدی در ۳۰۰ نظر آزمایشی عبارتند از:
- رعایت قوانین: مدل v4 با ۸۷٪ با مدل پرامپت-طولانی برابر شد، در حالی که مدل پرامپت-کوتاه تنها به ۲۷٪ رسید.
- ذکر جزئیات: نرخ ذکر جزئیات مشتری در v4 به ۹۱٪ رسید که جهشی عظیم نسبت به ۵۹٪ در v3 است.
- بهرهوری: مدل v4 در هر فراخوانی از ۱۶۷ توکن پرامپت استفاده میکند، در حالی که مدل پرامپت-طولانی به ۳۴۸ توکن نیاز داشت؛ این امر هزینه هر پاسخ را به ۰.۰۰۰۱ دلار کاهش داد.
برای اعتبارسنجی مستقل، یک مدل داور (gpt-oss-120b) مدل v4 را با سایر نویسندگان در ۱۰۰ نظر مقایسه کرد. v4 در ۸۱٪ موارد v3 را شکست داد و در ۷۶٪ موارد از صاحبان واقعی کسبوکار بهتر عمل کرد. در حالی که در حالت کلی با مدل پرامپت-طولانی برابر شد (۵۵٪)، اما در «تست سخت» نظرات متقاضی استرداد وجه، v4 در ۷۹٪ موارد در مقایسه رودررو پیروز شد.
برای جلوگیری از توهم (Hallucination) — یعنی وقتی مدل با اطمینان چیزی میگوید که وجود ندارد — ReplyDesk از یک سیستم جستوجوی ترکیبی از طریق Tiger Cloud استفاده میکند که Postgres 18 را با pg_textsearch (BM25) و vectorscale (DiskANN) اجرا میکند. این سیستم جستوجوی کلیدواژهای و بردار معنایی (Embedding) را با استفاده از Reciprocal Rank Fusion در یک دستور SQL واحد ترکیب میکند تا مرتبطترین پاسخهای قبلی و حقایق فروشگاه را بازیابی کند. این تلاش برای اتصال مدل به حقایق، یادآور راهکار Geminate برای پایان توهم در RAG است که از پرسشهای واقعی برای اعتبارسنجی استفاده میکند.
به دلیل اتمام اعتبار Hugging Face، تبدیل پرسوجو به بردار (Query Embedding) بهصورت محلی در مرورگر و با استفاده از bge-small-en-v1.5 در یک Web Worker اجرا میشود. اگر Embedding بارگذاری نشده باشد، سیستم به طور خودکار به حالت BM25 بازمیگردد.
- ارتباط جستوجو: در آزمونی روی ۱۲۰ نظر، جستوجوی ترکیبی در ۳ نتیجه اول به ۷۲٪ ارتباط دست یافت، در حالی که BM25 به تنهایی ۶۵٪ و جستوجوی برداری به تنهایی ۷۱٪ بود.
- حافظه Backboard: هر فروشگاه یک دستیار Backboard دارد که حقایق در آن به عنوان حافظه ذخیره میشوند. یک باگ کشف شد که برنامه تقریباً هر حقیقتی را بدون توجه به ارتباط ارسال میکرد. این مشکل با مرتبسازی بر اساس امتیاز و نگه داشتن تنها ۳ حقیقت نزدیکترین، حل شد که باعث شد درصد یافتن حقایق مورد نیاز از ۳۱٪ به ۴۴٪ افزایش یابد.
لایه نهایی ایمنی توسط Groq (gpt-oss-20b) مدیریت میشود. این لایه تمام وعدههای موجود در پیشنویس را لیست کرده و با حقایق فروشگاه تطبیق میدهد. اگر وعدهای بدون پشتوانه باشد، سیستم آن را با برچسب «Check» علامتگذاری کرده و خط مربوطه را هایلایت میکند. اگر Groq شکست بخورد، یک بررسی کلیدواژهای جایگزین میشود. این مکانیسم مانع از آن میشود که هوش مصنوعی مثلاً ادعا کند «مطمئن میشوم سرعت خدمات ما برای همه افزایش یابد»، در صورتی که این موضوع در حقایق ثبتشده فروشگاه نباشد.
از نظر اقتصادی، استفاده از یک مدل ۴ میلیارد پارامتری باعث میشود هزینه هر پاسخ تقریباً ۰.۰۰۰۱ دلار باشد. برای فروشگاهی با ۶۰ نظر در ماه، هزینه سرویسدهی کمتر از یک سنت است. این امر یک مدل کسبوکار پایدار ایجاد میکند که در آن اشتراک ماهانه ۳ تا ۵ دلاری تقریباً تماماً سود خالص است. این بهرهوری تنها به دلیل وزنهای باز (Open Weights) ممکن شده است. اگر توسعهدهنده به یک API بسته متکی بود، حاشیه سود تابع تغییرات قیمت ارائهدهندگان بزرگ میشد. همچنین به دلیل کوچک بودن مدل، در صورت حذف ارائهدهنده میزبانی، مدل میتواند روی یک لپتاپ یا یک GPU ارزان اجرا شود.
تحلیل نهایی نشان میدهد که ReplyDesk یک تغییر حیاتی در نحوه تفکر ما درباره قابلیت اطمینان هوش مصنوعی ایجاد میکند. سالها تمرکز صنعت بر «مهندسی پرامپت» برای هدایت مدلها بود. اما این پروژه ثابت میکند که برای محدودیتهای حساس — مانند وعدههای مالی — پرامپتنویسی مانند یک سطل سوراخ است.
با استفاده از مدلهای باز بزرگ برای تقطیر (Distillation) یک رفتار «کامل» در یک مدل کوچک، توسعهدهنده در واقع یک «عادت» را در هوش مصنوعی برنامهریزی کرده است. این رویکرد اجازه میدهد یک مدل 4B در وظایف خاص و محدود، عملکرد مدل 120B مبتنی بر پرامپت را شکست دهد. برای یک صاحب کسبوکار، این یعنی هوش مصنوعی از یک «دستیار خلاق» که ممکن است دروغ بگوید، به یک «ابزار قابل اعتماد» تبدیل میشود که دفترچه قوانین را اجرا میکند.
تکامل این پروژه توسط بازخوردهای دنیای واقعی پیش رفت. اولین کاربر، پراتیک (Pratik) از کافه HOP-In در نزدیکی IIIT Naya Raipur، دادههای حیاتی را فراهم کرد. در یک تست کور ۲۰ دور، پراتیک ۱۵ بار مدل 4B مبتنی بر پرامپت را به ۴ بار مدل تنظیمشده v3 ترجیح داد. او پاسخهای طولانیتر و مفصلتر را ترجیح میداد، که نشان داد v3 بیش از حد کوتاه است. این بازخورد مستقیم، کاتالیزوری برای ایجاد v4 بود که ذکر جزئیات را از ۵۹٪ به ۹۱٪ رساند.
در حال حاضر پروژه در مرحله تست کور است. اهداف آینده شامل اتوماسیون دریافت نظرات و ادغام با API پروفایل تجاری گوگل برای انتشار مستقیم است. توسعهدهنده همچنین قصد دارد قیمتگذاری واقعی را از ۳ دلار در ماه شروع کند تا ببیند آیا صاحبان فروشگاه حاضر به پرداخت برای این سرویس هستند یا خیر. شما میتوانید در تست A/B شرکت کنید یا مکانیسم آن را در replydesk-shop.vercel.app بررسی کنید.
گام بعدی شما
- اگر صاحب کسبوکار هستید، از ابزارهای SLM برای اتوماسیون پاسخها استفاده کنید اما لایه تایید انسانی را حذف نکنید.
- برای کاهش نرخ توهم در مدلهای کوچک، به جای پرامپتهای طولانی، روی تولید دادههای مصنوعی با مدلهای بزرگتر (Distillation) تمرکز کنید.
- سیستمهای جستوجوی ترکیبی (Hybrid Search) را برای اتصال مدل به حقایق دنیای واقعی پیادهسازی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو