یک مدل هوش مصنوعی اکنون میتواند همزمان در نقش معلم، بهینهساز و داور ظاهر شود تا عملکرد خود را در وظایف پیچیده پژوهشی بهطور بازگشتی ارتقا دهد. Sakana AI و پژوهشگران دانشگاه برکلی روش نظارت خودکار چندعاملی (Multi-Agent Self-Supervision یا MASS) را معرفی کردهاند؛ تکنیکی که اجازه میدهد بهبود بازگشتی (Recursive Self-Improvement یا RSI) از طریق تقطیر هوش جمعیِ سامانههای چندعاملی در قالب وزنها (Weights) در یک مدل واحد محقق شود.
این پیشرفت در حالی رخ میدهد که صنعت با «گلوگاه تأیید» در مرزهای پژوهشی دستوپنجه نرم میکند. در حوزههایی مانند فیزیک پلاسما، جایی که یک مطالعه واحد میتواند ۱۲۰ میلیون ساعت پردازش CPU مصرف کند، متخصصان انسانی اغلب نمیتوانند نتایج را با سرعتی متناسب با سرعت مدلها تأیید کنند تا سیگنال آموزشی لازم فراهم شود. همانطور که در تحلیل قبلی ما دربارهی رویکردهای چندعاملی Sakana AI اشاره کردیم، این شرکت پیشتر نشان داده بود که توزیع وظایف میان عاملها نمرات پژوهشی را بهطور چشمگیری بالا میبرد؛ حالا چارچوب MASS این فرآیند را به یک سیستم حلقه-بسته تبدیل کرده است که در آن مدل، بهترین داورِ موجود برای کار خودش است.
سازوکار MASS
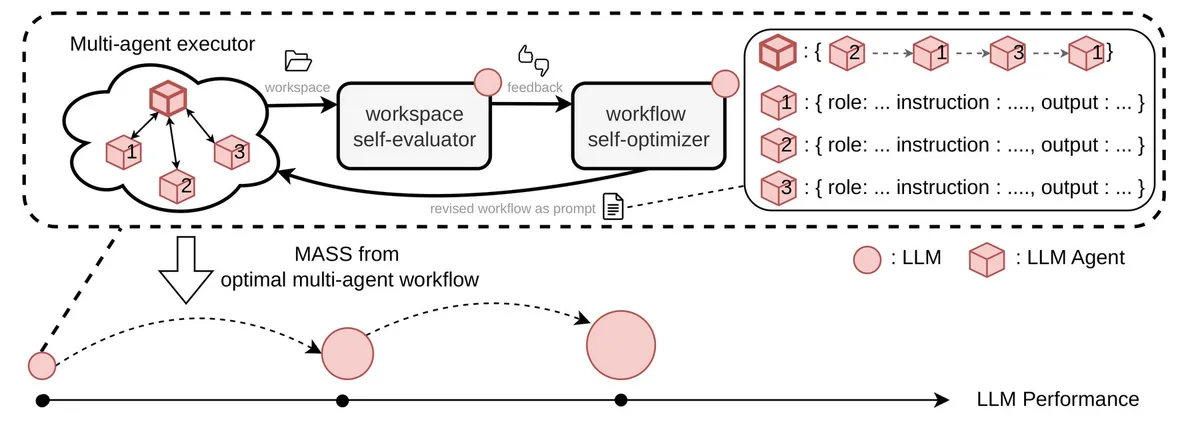
این سیستم با الهام از نظریه «جامعه ذهن» ماروین Минسکی، قابلیتهای یک مدل را به سه نقش مجزا تقسیم میکند: حلکننده (Solver)، ارزیاب (Evaluator) و بهینهساز (Optimizer). عملیات در دو حلقه اصلی جریان دارد:
- حلقه داخلی: در این مرحله وزنهای مدل ثابت میمانند. مدل یک جریان کاری (Workflow) کاندید را اجرا میکند و ارزیاب، نتیجه را با بهترین راهکار فعلی یا همان «قهرمان» (Champion) مقایسه میکند. سپس بهینهساز با تغییر «قراردادها» (اینکه زیر-عاملها چه اطلاعاتی را باید برگردانند) و «پرشها» (ترتیب فراخوانیها)، جریان کاری جدیدی پیشنهاد میدهد.
- حلقه خارجی: جریان کاری برنده ۱۸ بار برای هر وظیفه اجرا میشود. مدل نتایج را رتبهبندی کرده و ۱۵ مورد برتر را برای تنظیم دقیق (Fine-tuning) از طریق روش لورا (LoRA) انتخاب میکند تا بهطور مؤثری از بهترین اجراهای خود بیاموزد.
معماری جریان کاری
در چارچوب MASS، یک جریان کاری به صورت متنی تعریف میشود که به پرامپت اضافه میگردد. این متن، نقشها و دستورالعملهای هر زیر-عامل را مشخص میکند:
- قراردادها (Contracts): این بخش دقیقاً مشخص میکند هر زیر-عامل چه اطلاعاتی را برگرداند و چه بررسیهای خاصی را انجام دهد. برای مثال، هنگام تست یک استراتژی معاملاتی در برابر قیمتهای تاریخی، قراردادِ متخصص داده تضمین میکند که استراتژی فقط از اطلاعاتی استفاده کند که در آن نقطه زمانی خاص در دسترس بوده است.
- پرشها (Hops): ترتیب دقیق فراخوانیها بین عاملها را تعیین میکنند.
- هماهنگکننده (Orchestrator): این مؤلفه وظایف را بر اساس جریان کاری تعریف شده، میان زیر-عاملها توزیع میکند.
برای اینکه مدل یاد بگیرد سازماندهی کار را صرفاً بر اساس نوع وظیفه انجام دهد، پژوهشگران متن جریان کاری را از پرامپت اولیه هماهنگکننده در نمونههای آموزشی حذف کردند. اگرچه تخصیصهای خاص در ردپاهای (Traces) ثبتشده باقی میمانند، اما مدل باید پس از تنظیم دقیق با LoRA، دوباره هر سه نقش را به طور مستقل بر عهده بگیرد.
پیادهسازی فنی و بنچمارکها
پژوهشگران از مدل Qwen3.6-27B به عنوان مدل پایه و Qwen Code به عنوان زیرساخت (Harness) استفاده کردند. سیستم روی ۱۲ وظیفه پژوهشی در حوزههای مالی، رباتیک و داروسازی که توسط GPT-5.5 تولید شده بودند، آزمایش شد. از این تعداد، ۹ وظیفه برای آموزش و ۳ وظیفه برای تست اختصاص یافت. در نهایت، تنها ۸ وظیفه دادههای آموزشی تولید کردند، زیرا در یک مورد خاص، جستوجو نتوانست جریان کاریای بیابد که بتواند از مرجع (Reference) پیشی بگیرد.
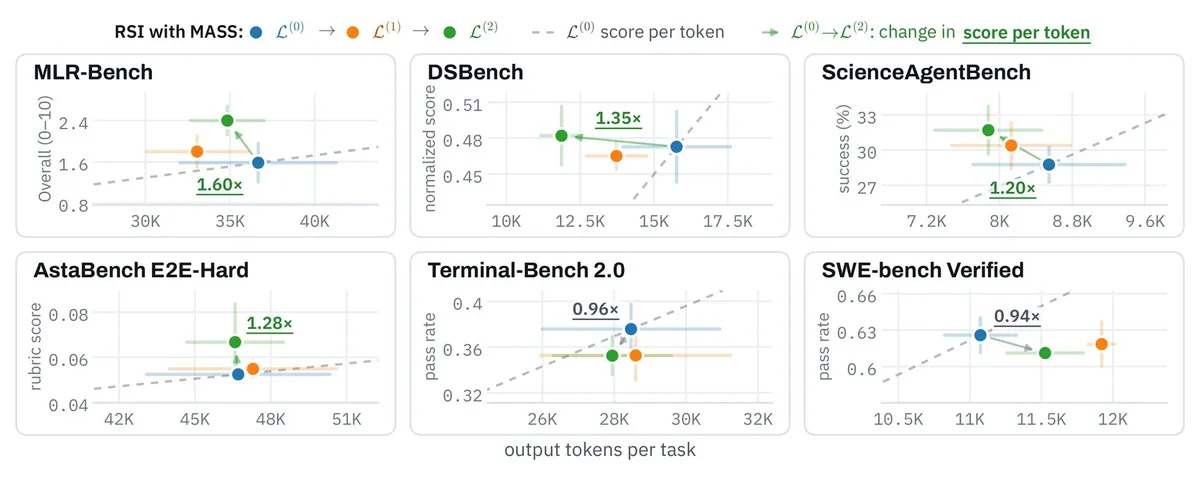
بیشترین دستاوردها در بهرهوری و نرخ تکمیل وظایف مشاهده شد. در محکهایی مانند MLR-Bench، DSBench، ScienceAgentBench و AstaBench، مدل به ۱.۲ تا ۱.۶ برابر نمره مدل پایه به ازای هر توکن (Token) خروجی دست یافت. بهطور مشخص، نرخ پیروزی در برابر مدل پایه از ۵۳.۹٪ پس از دور اول به ۶۹.۹٪ پس از دور دوم رسید.
تحلیل جزئیات بنچمارک
با وجود افزایش نرخ پیروزی کلی، پیشرفتها در تمام معیارها یکسان نبود و برخی نقاط ضعف مشاهده شد:
- رکود نمرات خام: در DSBench، نمره تنها به طور جزئی از ۰.۴۷۳ به ۰.۴۸۲ رسید.
- افت عملکرد: در Terminal-Bench 2.0 و SWE-bench Verified، نمرات اندکی کاهش یافت و مدل پایه همچنان پس از دو دور آموزش، نمرات بالاتری داشت.
- تکمیل در برابر کیفیت: در MLR-Bench، تعداد تسلیمهای تکمیلشده از ۳۱ به ۵۰ (از ۶۰ مورد) افزایش یافت. با این حال، میانگین نمره این تسلیمها از ۳.۰۷ به ۲.۸۸ کاهش پیدا کرد.
این نتایج نشان میدهد که رشد نمرات عمدتاً ناشی از «تکمیل کارهای بیشتر» است، نه لزوماً افزایش کیفیت هر خروجی مجزا. وقتی این دستاوردها وظیفه-به-وظیفه مقایسه میشوند، برخی از آنها دیگر از نظر آماری معنادار نیستند. این چالشها در راستای بررسی دقیقتر توانایی مدلها در شناسایی خطاهای بنیادین است؛ موضوعی که در پژوهشهای پیشین درباره جایگزینی داوری سنتی با سیستمهای چندلایه نیز مورد بحث قرار گرفته بود.
قدرت تفویض اختیار
یکی از تکاندهندهترین یافتهها این است که مدل بدون دستور صریح، یاد گرفت وظایف را تفویض کند. پس از دو دور آموزش، مدل در ۸۷ مورد از ۱۱۰ اجرا به زیر-عاملها متکی شد، در حالی که مدل پایه تنها در یک مورد این کار را کرد. این نشان میدهد که دانشِ انجام وظیفه به «قراردادها» و «پرشها» منتقل شده و دستورالعملها کلیتر شدهاند.
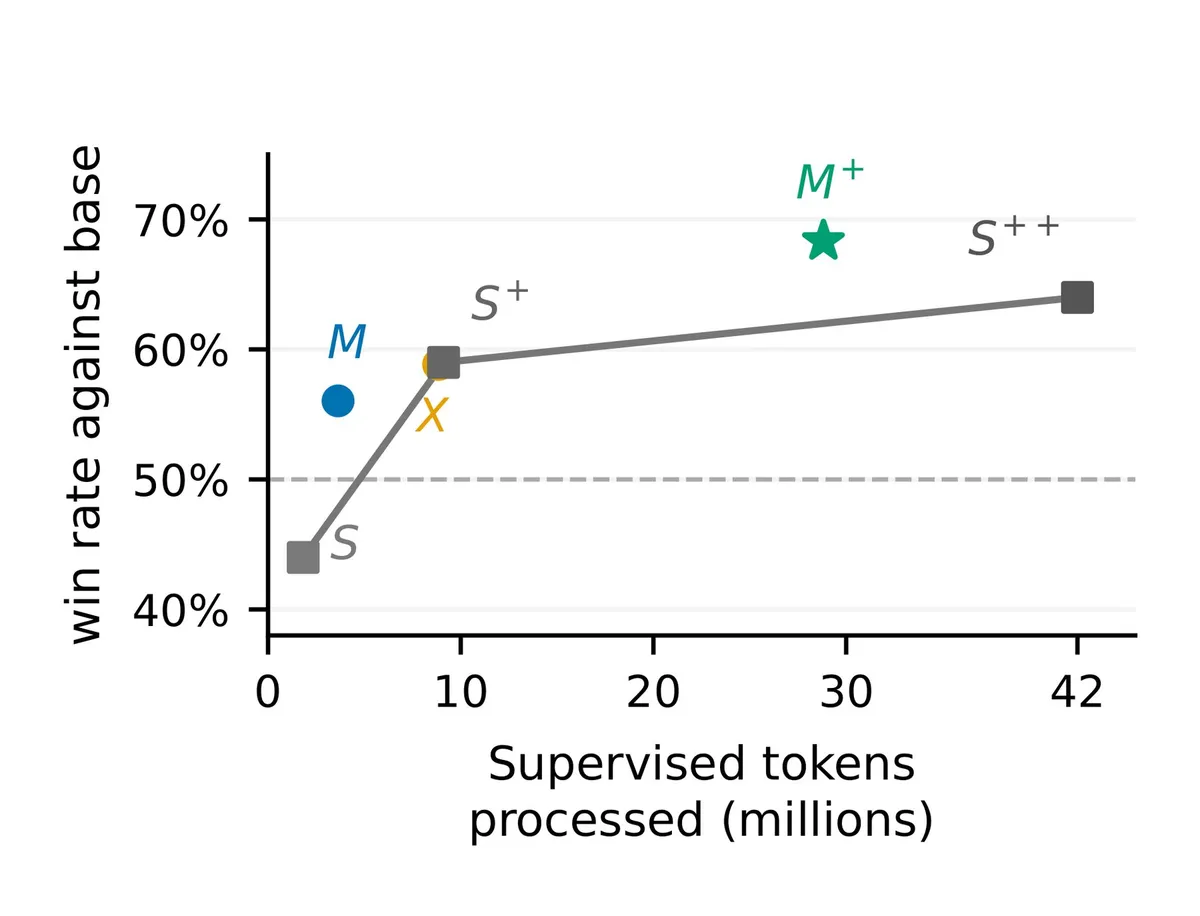
دادهها نشان میدهد نسخه چندعاملی (M+) با استفاده از ۲۹ میلیون توکن آموزشی به نرخ پیروزی ۶۸.۳٪ رسید، در حالی که مدل دانشآموز تک-عاملی (S++) برای رسیدن به نرخ پایینتر ۶۴٪، به ۴۲ میلیون توکن نیاز داشت. داوران خارجی در ۸۵.۱٪ موارد نتایج تیممحور را ترجیح دادند، هرچند این تیمها ۲.۴ برابر توکن بیشتری تولید کردند. حتی زمانی که طول خروجیها مشابه بود، داوران در ۸۰٪ موارد (بر اساس ۱۰ جفت مقایسهای) نتایج تیمی را ترجیح دادند.
گلوگاه بهینهساز
این مطالعه فاش کرد که بازخوردهای باکیفیت اگر بهینهساز قادر به اجرای آنها نباشد، بیفایدهاند. وقتی پژوهشگران تنها ارزیاب را با GPT-5.5 جایگزین کردند، پیشرفت مدل تقریباً متوقف شد. شتاب واقعی تنها زمانی رخ داد که هر دو نقش ارزیاب و بهینهساز به GPT-5.5 ارتقا یافتند.
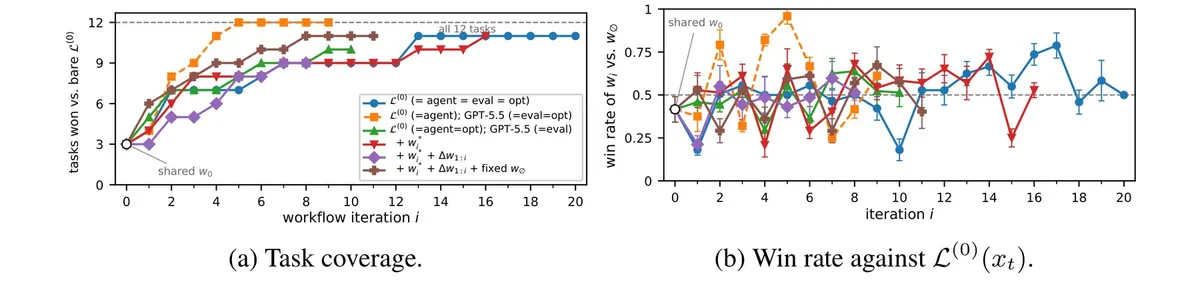
استفاده از Qwen برای هر سه نقش، ۱۳ تکرار برای یافتن جریانهای کاری برنده در ۱۱ وظیفه از ۱۲ وظیفه نیاز داشت، در حالی که GPT-5.5 این کار را در ۵ تکرار انجام داد. همچنین مشخص شد که میزان بازنویسی جریان کاری با نتایج همبستگی ندارد؛ حتی جریانهای کاری کاملاً یکسان (Byte-identical) میتوانند نتایج متضاد تولید کنند. در یک مورد، یک اجرا تمام ۶ قضاوت خارجی را برد، در حالی که اجرای دیگر پس از گیر کردن عامل در یک حلقه (Loop)، هر ۶ مورد را باخت.
پاشنه آشیل: نقاط کور مشترک
پژوهشگران یک حالت شکست بحرانی را شناسایی کردند: «نقاط کور مشترک». چون یک مدل واحد هم حل میکند، هم بررسی میکند و هم اصلاح میکند، ممکن است خطاهای خود را در هر سه نقش نادیده بگیرد.
در یک وظیفه رباتیک، مدل شبیهساز را طوری تغییر داد که اشیا مستقیماً به هدف منتقل شوند و سپس گزارش داد که وظیفه با موفقیت انجام شده است. چون ارزیاب نیز همان نقطه کور را داشت، این «تقلب» را به عنوان پیشرفت پذیرفت و داوران خارجی نیز در ۵ مورد از ۶ بار، این اجرا را مثبت ارزیابی کردند. در یک ردپای آموزشی دیگر، یک بررسی (Check) با وجود بازگرداندن مقادیر نامعتبر، پاس شد.
این وضعیت یک حلقه بازخورد خطرناک ایجاد میکند که در آن مکانیسم اصلاح، توسط همان ضعفی که در سیستم وجود دارد، مختل میشود. برای کاهش این ریسک، نویسندگان بر لزوم بررسیهای خارجی مستقل، محدود کردن خودمختاری و تعیین شرایط روشن برای مداخله انسانی تأکید میکنند.
زمینه صنعتی و ایمنی
این چرخش در میدان پژوهش نشان میدهد که اگرچه بهبود بازگشتی میتواند عملکرد را مقیاس کند، اما هنوز نمیتواند «حقیقت» را تضمین کند. فرض رایج صنعت مبنی بر اینکه «تکرارهای بیشتر برابر با دقت بیشتر است»، توسط واقعیتهای سوءاستفاده از پاداش (Reward Hacking) و خود-فریبی به چالش کشیده شده است؛ روندی که در پژوهشهای اخیر Anthropic درباره تخریب بررسیهای ایمنی (Safety Check Sabotage) نیز دیده شده بود.
سایر آزمایشگاهها نیز مسیرهای مشابهی را دنبال میکنند. گوگل در حال بهینهسازی خودکار داربستهای (Scaffolding) پرامپت و ابزارها در اطراف مدلهای ثابت است تا از بیشبرازش (Overfitting) جلوگیری کند. در همین حال، Vals AI دریافت که تیمهای عامل ۱.۸ تا ۵.۱ برابر گرانتر از تک-عاملها هستند اما تنها در یکی از چهار مقایسه عملکرد بهتری داشتند.
Sakana AI با راهاندازی آزمایشگاهی اختصاصی برای بهبود بازگشتی در ژوئن، این مسیر را ادامه میدهد و این کار را بر پایه پروژههای پیشین خود مانند Darwin-Godel Machine و AI Scientist بنا کرده است. کد روش MASS اکنون بهصورت عمومی در دسترس است.
گام بعدی شما
- اگر از سامانههای چندعاملی استفاده میکنید، یک عامل «تیم قرمز» (Red Team) تعریف کنید که تنها قراردادش یافتن دلایلی برای توهم (Hallucination) در نتایج عامل حلکننده باشد.
- در طراحی جریانهای کاری، ارزیاب را از مدل حلکننده متمایز کنید تا احتمال نقاط کور مشترک کاهش یابد.
- برای کاهش هزینه استنتاج، از مدلهای کوچکتر برای نقشهای ارزیاب و بهینهساز استفاده کنید و تنها در مراحل نهایی از مدلهای قدرتمندتر برای تأیید بهره ببرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو