یک مدل هوش مصنوعی اکنون میتواند همزمان معلم، شاگرد و منتقد خودش باشد تا سقف دانش انباشتهشده توسط انسان را بشکند. در ۱۱ اکتبر ۲۰۲۶، شرکت Sakana AI جزئیات چارچوبی به نام نظارت خودکار چندعاملی (Multi-Agent Self-Supervision یا MASS) را منتشر کرد که بهبود بازگشتی خودکار (Recursive Self-Improvement یا RSI) را بدون نیاز به برچسبهای انسانی یا قوانین تأیید خارجی ممکن میسازد.
بیشتر آموزشهای فعلی بر دادههای ایستا یا بازخوردهای انسانی متکی هستند؛ موضوعی که وقتی هوش مصنوعی به مرز تخصص انسان میرسد، به یک گلوگاه تبدیل میشود. در حوزههایی مثل داروسازی پیشرفته یا رباتیک، متخصصان انسانی بسیار کمیاباند یا هزینه آزمایشها برای نظارت مستمر بیش از حد بالاست. ارزیابی یک کشف پیشنهادی ممکن است نیازمند شواهد یا آزمایشهایی باشد که زمان تولید آنها بسیار بیشتر از زمان تولید خودِ پیشنهاد است. طبق اعلام Sakana AI، MASS با تبدیل خروجیهای جمعی مدل به سیگنال اصلی رشد، این مشکل را حل میکند. این رویکرد مشابه جوامع انسانی است که توانمندیهای خود را از طریق تقسیم کار و انتقال دستاوردهای آموختهشده گسترش میدهند.
زمینه: قیاس با هوش جمعی
شرکت Sakana AI از نحوه تکامل دانش بشری الهام گرفته است. در طول تاریخ، از جوامع شکارچی-گردآورنده و سکونتگاههای کشاورزی گرفته تا جوامع صنعتی و شبکههای اطلاعاتی جهانی، انسانها تواناییهای خود را با تقسیم کار، ترکیب ایدهها و انتقال آموختهها به نسلهای بعد گسترش دادهاند. این رویکرد به نوعی با دیدگاههای جدید درباره تعامل انسان و ماشین همسو است، مشابه آنچه در مدل هوش مصنوعی همزیست دیپمایند برای جایگزینی تکینگی مدلهای تکساحتی پیشنهاد شده است.
این الگو در تاریخ علم نیز دیده میشود. توماس کوهن در کتاب ساختار انقلابهای علمی تأکید کرد که دانشمندان یاد میگیرند مسائل را از طریق مثالهای مشترک شناسایی و حل کنند. دستاوردهای یک جامعه علمی تبدیل به زیربنایی میشود که اعضای آن جامعه بر اساس آن، یاد میگیرند کارهای جدیدی انجام دهند. MASS همین منطق را در هوش مصنوعی پیاده میکند: کار جمعی یک تیم، نمونههای آموزشی را برای مدلی فراهم میکند که اعضای آن تیم از آن به اشتراک میبرند.
فلسفه RSI همگن
Sakana AI معتقد است برای پیشروی فراتر از دانش انباشتهشده توسط بشریت، خودِ مدل (بهعنوان هدف بهینهسازی یا Optimizee) ممکن است بهترین بهینهساز (Optimizer) و ارزیاب (Evaluator) موجود باشد. این منجر به ایجاد یک بهبود بازگشتی خودکار همگن (Homogeneous RSI) میشود؛ جایی که مدلِ در حال بهبود، همزمان نقش اصلاحکننده و داور را نیز ایفا میکند.
این روش بهطور خاص برای وظایف پژوهشی «غیرقابلتأیید» (Non-verifiable) طراحی شده است. در این متن، «غیرقابلتأیید» به این معنا است که هیچ سیگنال خودکار مبتنی بر قانون (Rule-based) در دسترس نیست و کل حلقه یادگیری صرفاً توسط یک سیگنال خودارزیابی هدایت میشود که صحت آن در ابتدا نامشخص است.
چرخه RSI همگن: سه نقش در یک کالبد
بر اساس تحلیل فنی Sakana AI، سامانه MASS یک سیستم «همگن» است که در آن یک مدل زبانی مشترک، سه نقش متمایز را ایفا میکند. تفاوت این سیستم با سیستمهای ناهمگن در این است که مجری، بهینهساز و ارزیاب همگی یک مدل واحد هستند:
- عامل (مجری/Optimizee): حلکننده مسئله است. این عامل یک فضای کاری شامل نتایج، نمودارها و یک گزارش پژوهشی نهایی تولید میکند.
- بهینهساز گردشکار (معمار): از بازخوردهای ارزیاب استفاده میکند تا نحوه تقسیم کار بین عاملها، تبادل نتایج و نحوه بررسی کارهای یکدیگر را بازبینی و اصلاح کند.
- ارزیاب (داور): دو فضای کاری را با هم مقایسه میکند، تشخیص میدهد کدامیک هدف را بهتر برآورده کرده و دلیل این قضاوت را توضیح میدهد.
این ساختار یک حلقه بسته میسازد که در آن مدل، استراتژیهای هماهنگی خود را بهینه کرده و سپس وزنهای خود را بر اساس بهترین نتایجی که کشف کرده است، تنظیم دقیق (Fine-tuning) میکند. برای اندازهگیری پیشرفت بدون اتکا به سیگنالهای احتمالاً سوگیرانه مدل، پژوهشگران از GPT-5.5 و Claude Opus 4.8 بهعنوان داوران خارجی استفاده کردند که ارزیابیهای آنها از حلقه MASS مخفی نگه داشته شده بود.
حلقه داخلی: تکامل تیم
فرآیند با یک «حلقه داخلی» آغاز میشود که بر بهینهسازی گردشکار متمرکز است، در حالی که وزنهای مدل ثابت میمانند. گردشکار در واقع یک برنامه مکتوب است که به پرامپت وظیفه اضافه میشود و به مدل اجازه میدهد سازماندهی خود را بازبینی کند. این برنامه از چهار جزء تشکیل شده است:
- نقش (Role): مسئولیتی که به هر زیرعامل اختصاص مییابد (مثلاً آمادهسازی دادهها).
- دستورالعمل (Instruction): کارهای مشخصی که زیرعامل باید به طور دقیق انجام دهد.
- قرارداد (Contract): اطلاعات و مصنوعاتی که عامل باید بازگرداند، شامل بررسیهای الزامی.
- گام (Hop): ترتیب فراخوانی زیرعاملها، شامل هرگونه بازگشت به مراحل قبلی.
بهعنوان مثال، در یک گردشکار مالی تکاملیافته، توالی از «دادهها» $\rightarrow$ «ویژگیها» $\rightarrow$ «مدلسازی» $\rightarrow$ «تست بازگشتی» $\rightarrow$ «حسابرسی» $\rightarrow$ «تطبیق» $\rightarrow$ «گزارش» حرکت میکند. در اینجا «قرارداد داده» بهطور مشخص یک validation_report را میطلبد که شامل بررسیهای بولی (Boolean) برای no_future_leakage (عدم نشت دادههای آینده)، train_end_before_val_start (پایان آموزش پیش از شروع اعتبارسنجی) و val_end_before_test_start (پایان اعتبارسنجی پیش از شروع تست) باشد. این کار تضمین میکند که تصمیمات تاریخی از اطلاعات آینده استفاده نکنند و عاملهای بعدی پیش از ادامه کار، شواهد لازم را دریافت کنند.
برای هر وظیفه، سیستم یک گردشکار «قهرمان» (Champion) را حفظ میکند که بر اساس قضاوتهای فعلی مدل، بهترین مورد یافت شده است. حلقه داخلی سه مرحله دارد:
- اجرا: تیم طبق گردشکار کاندید، یک فضای کاری تولید میکند.
- ارزیابی: ارزیاب این فضای کاری را با فضای کاری قهرمان مقایسه کرده و توضیح میدهد کدام بهتر است. کاندید برنده تبدیل به قهرمان جدید میشود.
- بازبینی: بهینهساز از تاریخچه بازخوردها برای پیشنهاد گردشکار بعدی استفاده میکند.
پرامپت سیستمِ بهینهساز بهطور ویژه بر «قراردادها» و «گامها» تأکید میکند و جستوجو را به سمت نحوه تبادل اطلاعات و زمان دریافت آنها توسط عاملها هدایت میکند.
حلقه خارجی: تقطیر هوشمندی
پس از یافتن بهینهترین گردشکار، «حلقه خارجی» وزنهای واقعی مدل را بهروز میکند. از آنجایی که کیفیت پژوهشهای طولانیمدت بین اجراهای مختلف متفاوت است، سیستم گردشکار قهرمان را ۱۸ بار برای هر وظیفه با بذرهای تصادفی (Random Seeds) مختلف اجرا میکند.
با استفاده از مدل برادلی-تری (Bradley–Terry) برای تبدیل ترجیحات جفتبهجفت به امتیاز، سیستم فضاهای کاری حاصل را رتبهبندی کرده و ۱۶ مسیر (Trajectory) برتر را حفظ میکند (۱۵ مورد برای آموزش و یک مورد برای اعتبارسنجی). هر مسیر تمام پیامها، فراخوانیهای ابزار و نتایج ابزارها توسط هماهنگکننده و زیرعاملها را ثبت میکند.
نکته حیاتی این است که در مرحله تنظیم دقیق از طریق لورا (LoRA)، متن گردشکار از پرامپت اولیه هماهنگکننده حذف میشود. این کار مدل را مجبور میکند تا نحوه سازماندهی کار را از خودِ مسئله یاد بگیرد و توانایی هماهنگی کارهای پیچیده را بهصورت غریزی درونی کند، نه اینکه صرفاً یک اسکریپت ارائه شده را دنبال کند. در اینجا خروجیهای مدل بهعنوان اهداف آموزشی (Training Targets) عمل میکنند، در حالی که پرامپتهای وظیفه و نتایج ابزارها، زمینه (Context) را فراهم میکنند.
دستاوردهای کمی و عملکرد
Sakana AI این روش را با مدل Qwen3.6-27B در محیط qwen-code روی ۱۲ وظیفه پژوهشی سنتتیک در حوزههای مالی، رباتیک و داروسازی آزمایش کرد. این وظایف توسط GPT-5.5 تولید شده بودند. ۹ وظیفه برای آموزش و ۳ وظیفه برای تست کنار گذاشته شدند. یک وظیفه آموزشی حذف شد زیرا هیچ گردشکاری نتوانست از مرجع آن پیشی بگیرد.
نتایج یک مسیر صعودی واضح را نشان میدهد:
- نرخ پیروزی: در وظایف تست، نرخ پیروزی نسبت به مدل پایه از ۵۳.۹٪ پس از دور اول به ۶۹.۹٪ پس از دور دوم رسید. مدل دور دوم همچنین در ۶۰.۸٪ مقایسهها بر مدل دور اول پیروز شد. در وظایف آموزشی، نرخ پیروزی پس از دو دور به ۸۲.۵٪ رسید.
- مقیاسبندی محکها: در محکهای عمومی شامل MLR-Bench، DSBench، ScienceAgentBench و AstaBench، امتیاز بهازای هر توکن خروجی به ۱.۲ تا ۱.۶ برابر سطح مدل پایه رسید. با این حال، انتقال مهارت یکنواخت نبود؛ در Terminal-Bench 2.0 به ۰.۹۶ برابر و در SWE-bench Verified به ۰.۹۴ برابر رسید. پژوهشگران گمان میکنند این مشکل با افزودن وظایف مهندسی نرمافزار به دادههای آموزشی قابل حل باشد.
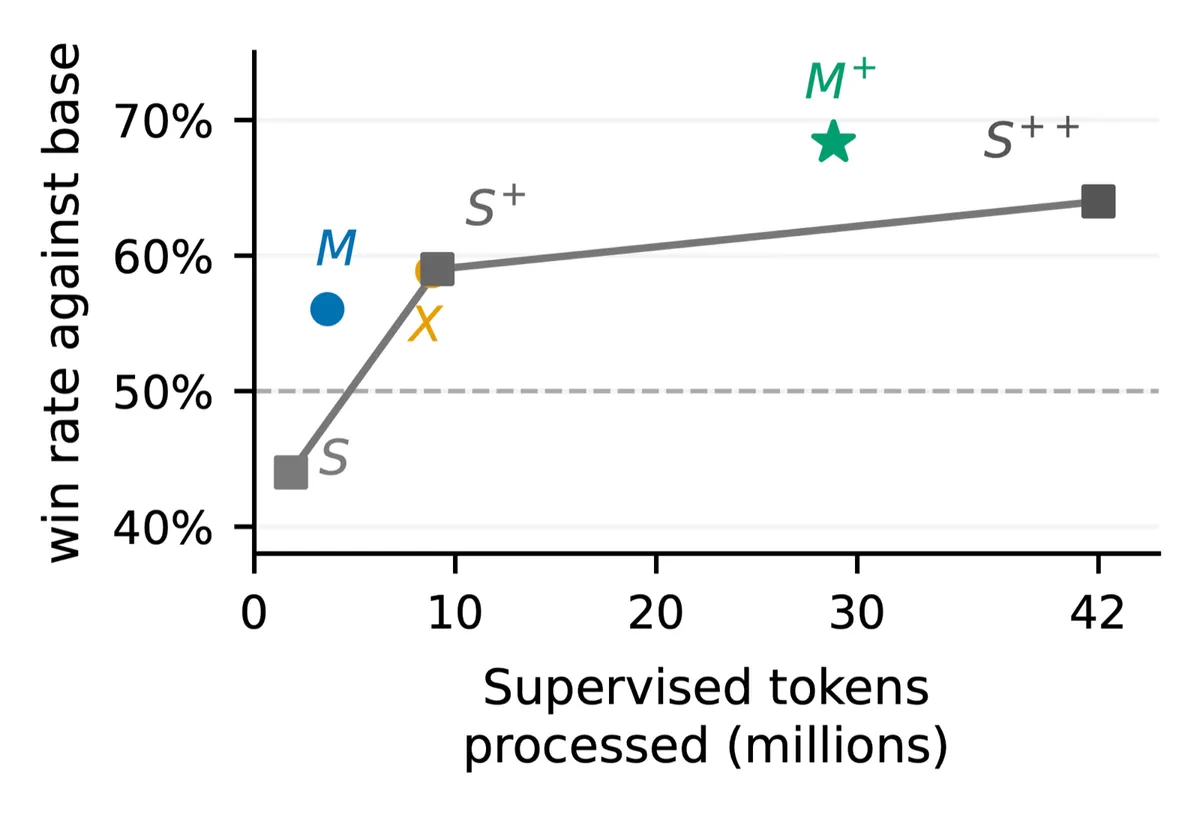
- کارایی: رویکرد چندعاملی سیگنال یادگیری متراکمتری فراهم کرد. مدل MASS (M+) با استفاده از ۲۸.۸ میلیون توکن نظارتشده به نرخ پیروزی ۶۸.۳٪ رسید، در حالی که یک شاگرد تکعاملی (S++) برای رسیدن به نرخ پایینتر ۶۴.۰٪، به ۴۲ میلیون توکن نیاز داشت. این نشاندهنده کاهش ۳۱ درصدی در توکنهای نظارتشده مورد نیاز است.
تعمیم نقشها و جریان اطلاعات
یکی از مهمترین یافتهها «تعمیم نقش» (Role Generalization) است. با وجود اینکه مدل فقط روی مسیرهای حل مسئله آموزش دیده بود، تواناییاش در بهینهسازی گردشکار و ارزیابی کار نیز بهبود یافت. این امر تضمین میکند که حلقه RSI پایدار و قابل تکرار است.
برای آزمایش این موضوع، پژوهشگران گردشکارهای کشفشده توسط مدل دور اول را به مدل پایه دادند. مدل پایه هنگام اجرای این گردشکارهای دور اول، در ۶۴٪ مقایسهها بر مدل پایه که از گردشکارهای جستوجوی پایه خود استفاده میکرد، پیروز شد. علاوه بر این، میزان توافق ارزیاب با داوران خارجی قدرتمند در طول سه چرخه از ۷۳٪ به ۹۳٪ افزایش یافت.
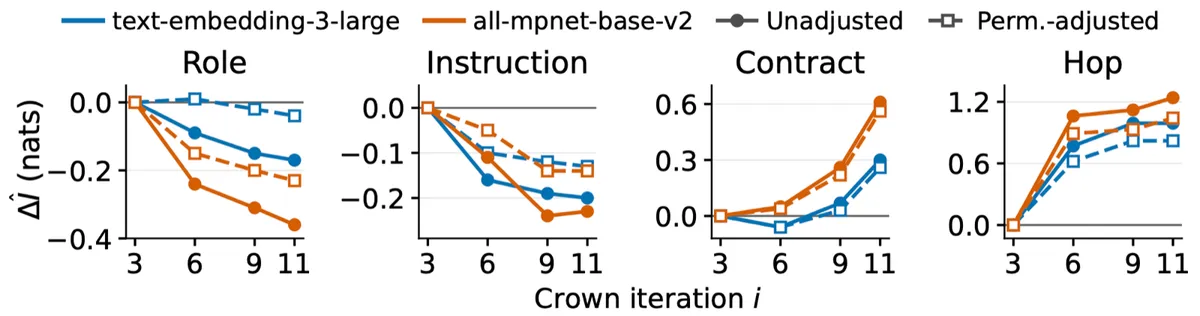
تحلیل گردشکارهای قهرمان نشان داد که نحوه رمزگذاری اطلاعات توسط هوش مصنوعی تغییر کرده است. پژوهشگران اطلاعات متقابل (Mutual Information) بین جاسازیهای (Embeddings) اجزای گردشکار و توصیفات وظیفه را با استفاده از text-embedding-3-large و all-mpnet-base-v2 تخمین زدند.
- تکرارهای اولیه: بر نقشهای کلی (مانند «دانشمند داده دقیق») و دستورالعملهای عمومی متکی بودند.
- تکرارهای بعدی: تا تکرار یازدهم، اطلاعات مربوط به وظیفه به سمت «قراردادها» و «گامها» منتقل شد.
این نشان میدهد که بهینهساز اجزا را بهگونهای تکامل میدهد که مستقل از یکدیگر باشند و در عین حال جریان اطلاعات را از طریق قراردادها بهینه کند. پژوهشگران این وضعیت را «کشف یک بردار پایه برای فضای مهار» (Basis vector for the harness space) توصیف میکنند.
گلوگاه بهینهساز
شرکت Sakana AI مطالعات ابلیشن (Ablation) انجام داد تا ضعیفترین حلقه در RSI را پیدا کند. آنها دریافتند که بهینهساز گلوگاه بحرانیتری نسبت به ارزیاب است:
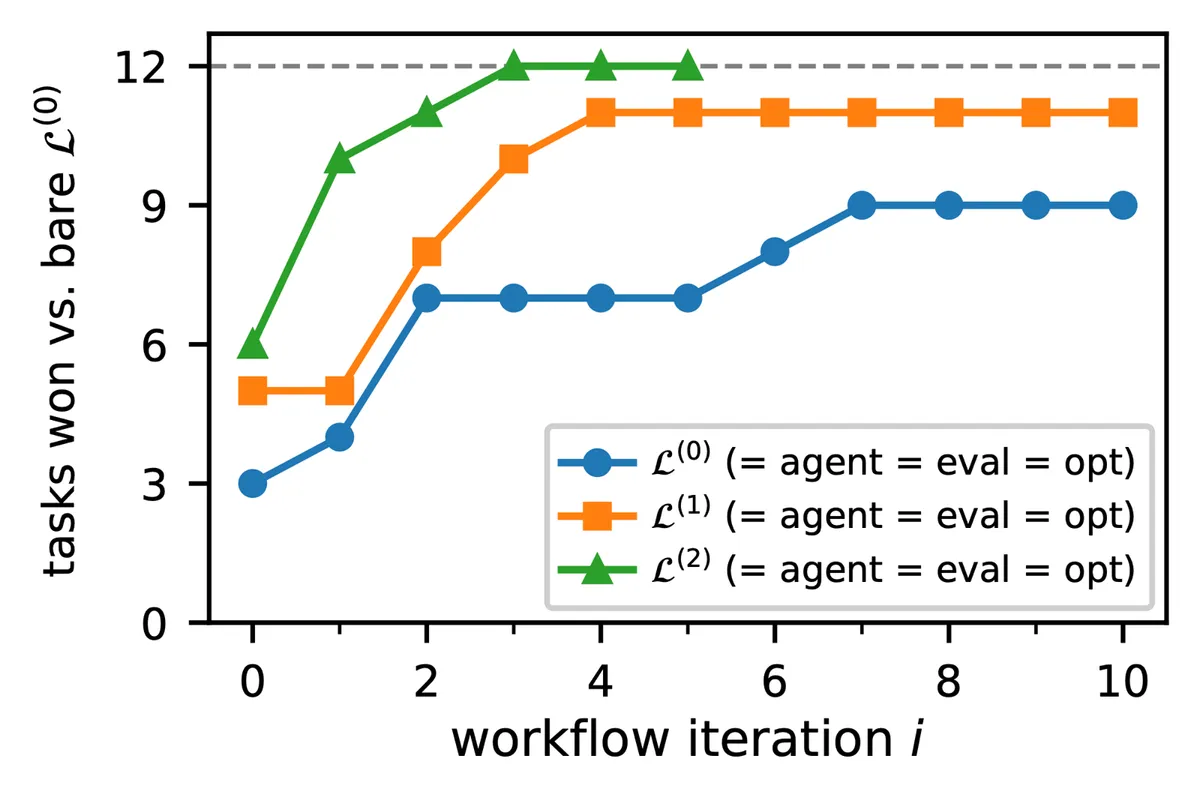
- فقط ارزیاب: جایگزینی ارزیاب مدل پایه با GPT-5.5 سود حداقلی داشت.
- ارزیاب + بهینهساز: جایگزینی هر دو با GPT-5.5 به سیستم اجازه داد تا در تنها ۵ تکرار، گردشکارهای برنده را برای تمام ۱۲ وظیفه پیدا کند.
- حلقه همگن: حلقه کاملاً همگن در نهایت به ۱۱ وظیفه از ۱۲ وظیفه رسید، اما سرعت آن بهطور قابلتوجهی کمتر بود.
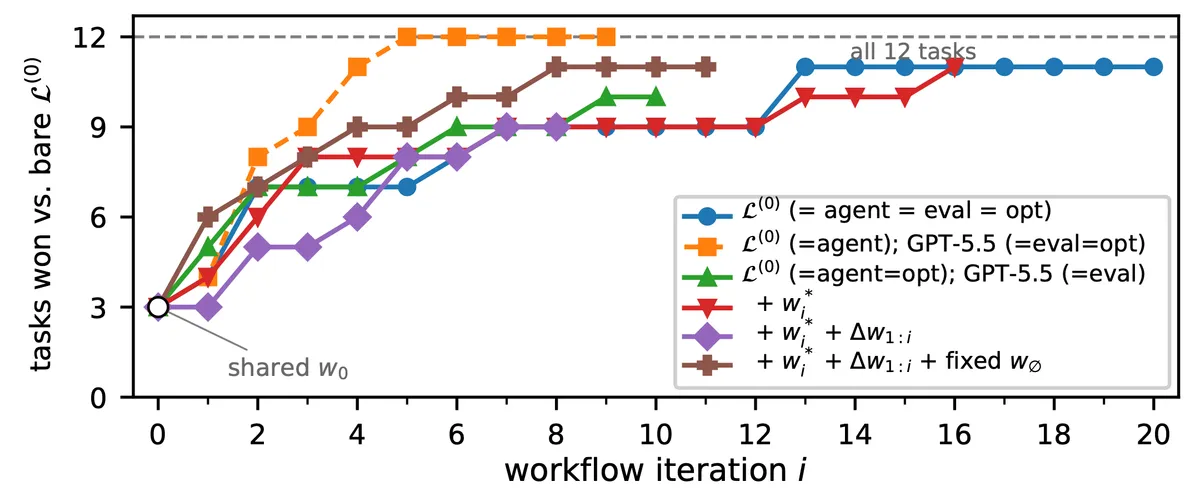
این نشان میدهد که اگرچه یک ارزیاب قوی بازخورد باکیفیتی میدهد، اما یک بهینهساز ضعیف نمیتواند آن را هضم کند. بنابراین، در بودجههای محدود، اولویت باید با تقویت بهینهساز باشد نه ارزیاب.
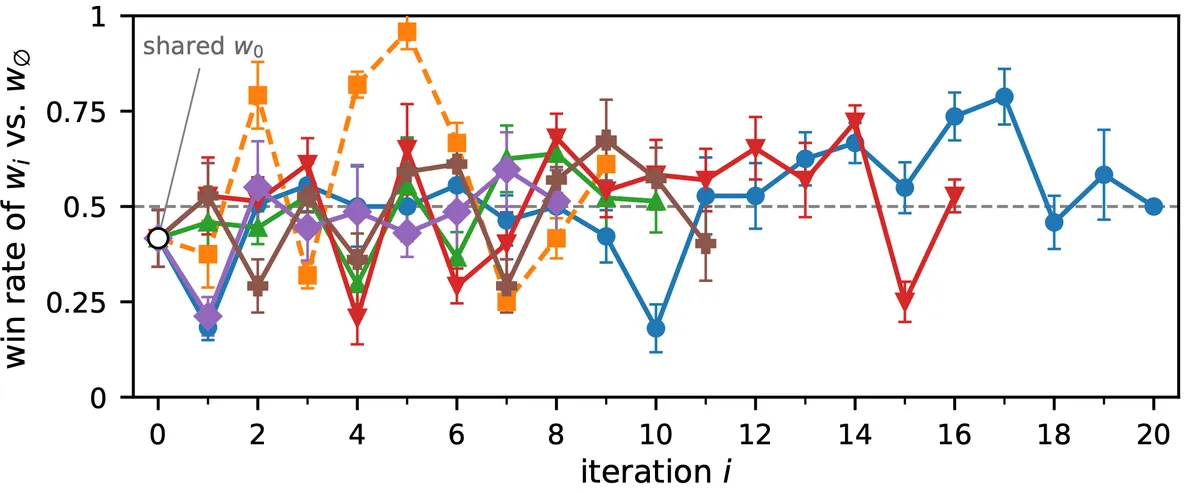
با این حال، فرآیند جستوجو همچنان نویز دارد. پژوهشگران پس از تکرارهای قوی، افتهای شدید عملکرد را مشاهده کردند که نشان میدهد بهینهسازی در فضای متنی ممکن است به یک «زمانبند نرخ یادگیری» (Learning-rate scheduler) نیاز داشته باشد تا پایداری حفظ شود و از پسرفتها جلوگیری شود.
«لحظه اودیسهای» و ریسکهای ایمنی
این قابلیت نشاندهنده چیزی است که پژوهشگران آن را «لحظه اودیسهای» مینامند؛ نقطهای که هوش مصنوعی باید بدون یک ناظر قویتر یاد بگیرد و دانشی را دنبال کند که «فراتر از دورترین مرز تفکر انسانی» است. در حالی که این توانایی قدرتمند است، یک ریسک ایمنی حیاتی را معرفی میکند: «نقطه کور مشترک» (Shared Blind Spot). این چالشهای نظارتی دقیقاً همان دغدغههایی است که در مطالبات OpenAI برای رهبری استانداردهای فنی جهت تضمین ایمنی سیستمهای بازگشتی مطرح شده است.
اگر مدل در استدلال خود دچار یک نقص بنیادی باشد، ممکن است نتیجهای معیوب را بهعنوان یک بهبود تشخیص دهد و آن خطا را در نسخه بعدی خود ادغام کند. بدون یک ناظر خارجی قویتر، این خطاها میتوانند بهصورت بازگشتی تقویت شوند. این «پاشنه آشیل» بهبود بازگشتی خودکار است: همان ضعفی که میتواند هم رفتار سیستم و هم مکانیسم اصلاحی آن را بهطور همزمان مختل کند.
این موضوع نشان میدهد که با حرکت به سمت RSI خودمختار، چالش اصلی از افزایش توانایی به حفظ نظارت معنادار تغییر میکند. شناسایی این نقاط ضعف برای کنترل سیستمهای توانمندتر، هدایت بررسیهای مستقل و تعیین شرایط برای مداخله انسانی ضروری است. پژوهشگران اشاره میکنند که اگرچه ردپاهای استدلالی (Chain-of-thought) میتوانند به آشکار شدن رفتارهای نادرست کمک کنند، اما شواهد ناقصی ارائه میدهند و حفظ نظارت را به یک پرسش مرکزی ایمنی برای لحظه اودیسهای هوش مصنوعی تبدیل میکنند.
گام بعدی شما
- بررسی معماریهای چندعاملی برای کاهش نیاز به دادههای برچسبدار در پروژههای تخصصی.
- تحلیل اثر حذف دستورالعملهای صریح (Workflow) در مرحله تنظیم دقیق برای درونیسازی مهارتهای سازماندهی در مدل.
- مطالعه متدهای ارزیابی متقاطع (Cross-Evaluation) برای شناسایی نقاط کور در مدلهای خودبهبهبود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو