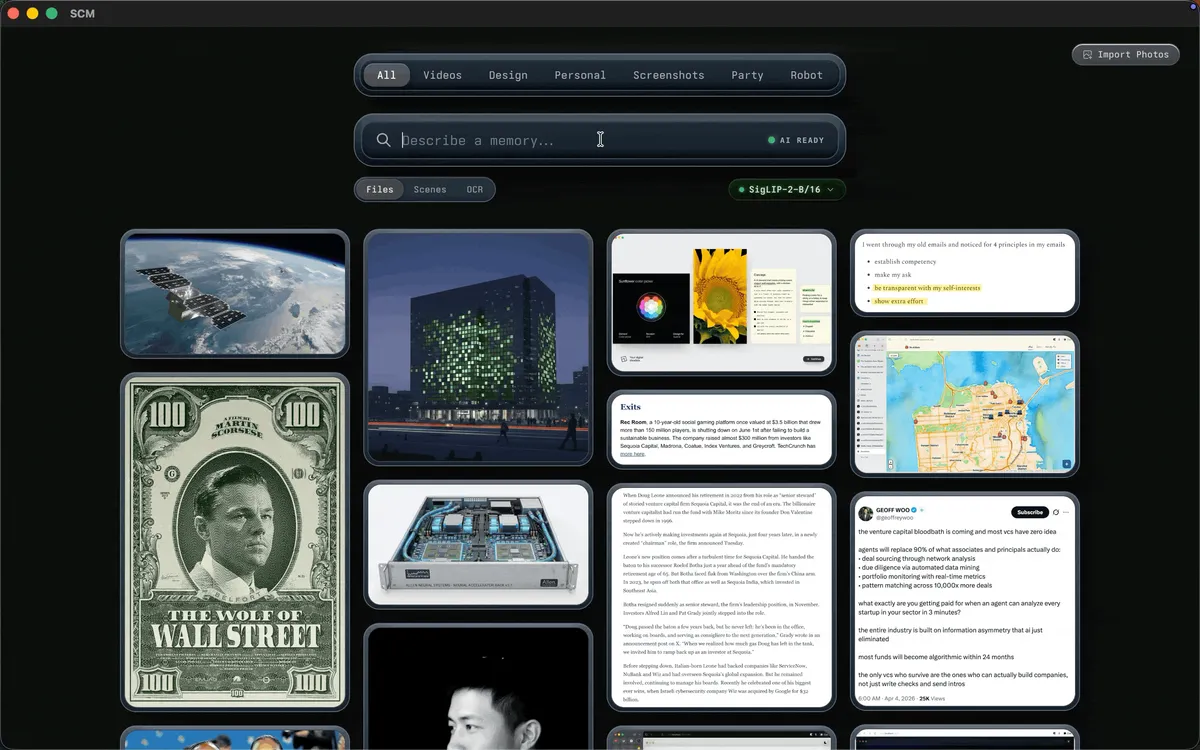
تصور کنید میخواهید لحظهای را پیدا کنید که سگی روی ساحل میدود، اما نه نام فایل را به یاد دارید و نه تاریخ آن را. حالا کاربران macOS میتوانند با استفاده از زبان طبیعی، تکتک فریمهای ویدیوهای خود را بدون ارسال حتی یک بایت داده به سرورهای ابری جستوجو کنند.
SCM (Screen Memories) که در ۴ اکتبر ۲۰۲۶ منتشر شد، با انتقال تمام فرآیند استنتاج (Inference) — که شبیه لحظهٔ نهایی آشپزی است، نه دورهی آموزش آشپز — به سختافزار کاربر، نیاز به آپلود دادهها را بهطور کامل حذف کرد. اکثر ابزارهای جستوجوی رسانه به نام فایلها یا متادیتای پایه تکیه میکنند که وقتی شما یک جزئیات بصری را به یاد میآورید اما عنوان را فراموش کردهاید، شکست میخورند. SCM این پارادایم را تغییر میدهد و محتوای واقعی بصری و شنیداری فایلها را بردارسازی میکند. این یعنی شما میتوانید یک خاطره را توصیف کنید — مثلاً «سگی که روی ساحل میدود» — و ابزار، لحظه دقیق وقوع آن را در میان هزاران فایل پیدا کند.
همانطور که در تحلیلهای پیشین ما دربارهی حریم خصوصی در مدلهای محلی اشاره کردیم، حذف واسطههای ابری تنها یک ویژگی نیست، بلکه یک ضرورت امنیتی است. SCM این پارادایم را با تحلیل عمیق محتوا پیاده میکند تا کاربر بتواند توصیفی از یک خاطره را بنویسد و ابزار، دقیقترین لحظه را در میان هزاران فایل بیابد.
جستوجوی بصری و زمانی عمیق
این سیستم تنها فایل درست را پیدا نمیکند، بلکه دقیقترین نما (Shot) را هدف میگیرد. SCM ویدیوها را به صحنههای مجزا تقسیم کرده و آنها را بردارسازی میکند تا کاربر مستقیماً به یک کد زمانی (Timecode) خاص بپرد.
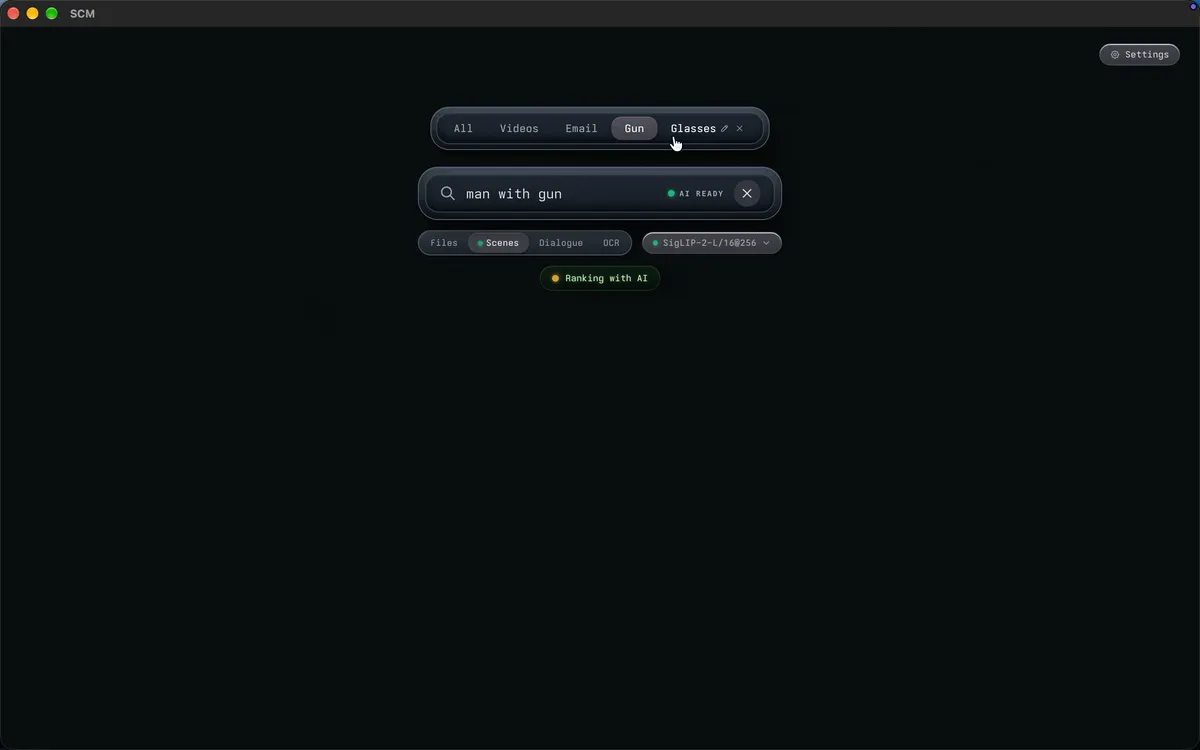
برای جلوگیری از نمایش نتایج بیربط و پر شدن شبکه از دادههای نامفهوم، یک «دروازه نویز» (Noise Gate) برای مواردی با سطح اطمینان پایین، پاسخ «عدم تطابق صحنه» برمیگرداند. هر ویدیو حداکثر ۳ صحنه را به نتایج میفرستد. وقتی کاربر یک ویدیو را از طریق تطابق صحنه باز میکند، اپلیکیشن مستقیماً به همان لحظه خاص میرود.
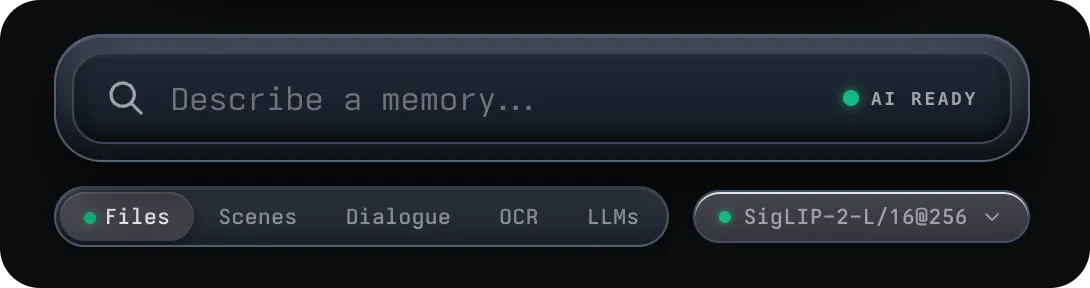
کاربران میتوانند بین چهار مدل بینایی از طریق ONNX Runtime جابهجا شوند تا تعادلی بین سرعت و دقت ایجاد کنند. مدل فعال برای هر کتابخانه بهطور مجزا انتخاب میشود و تغییر مدل باعث شروع فرآیند باز-بردارسازی (Re-embedding) کل کتابخانه در پسزمینه میشود. برای اینکه امتیازات شباهت در مدلهای مختلف صادقانه و دقیق باقی بماند، SCM از روش text-mean centering برای حذف سوگیریهای بردار متنی استفاده میکند:
- CLIP ViT-L/14@336: پیشفرض برای جستوجوی صحنههای واقعی (حدود ۴۸۰ تا ۵۷۰ میلیثانیه برای هر تصویر؛ حجم دانلود ۴۳۵ مگابایت).
- SigLIP-2-B/16: بهینه برای وارد کردن سریع حجم زیاد داده (۵۰ تا ۱۰۰ میلیثانیه برای هر تصویر؛ حجم دانلود ۴۱۲ مگابایت).
- SigLIP-2-L/16@256: دقت بالا (۱۰۲۴ بُعدی) برای اشیای کوچک، تابلوها و متنهای روی صفحه (حدود ۲۰۰ میلیثانیه برای هر تصویر؛ حجم دانلود ۸۵۰ مگابایت).
- SigLIP-B/16@384: حداکثر جزئیات برای تصاویر پیچیده (۴۸۰ میلیثانیه برای هر تصویر؛ حجم دانلود ۲۱۴ مگابایت).
حالتهای بازیابی چندوجهی
بر اساس مستندات گیتهاب، SCM از پنج حالت جستوجوی مجزا برای تضمین دقت در انواع رسانهها استفاده میکند:
- فایلها (Files): استفاده از رتبهبندی بصری همراه با تقویت نام فایل و عبارات برای یافتن عکس یا ویدیوهای کامل. نتایج بر اساس شباهت کسینوسی (Cosine Similarity) در برابر بردارهای تصویر امتیازدهی میشوند و یک «کف صداقت» (Honesty Floor) برای هر مدل کالیبره شده است. یک فیلتر تنوع برای حذف موارد تقریباً مشابه، از نمایش نتایج تکراری جلوگیری میکند. هر کاشی شامل یک نشان «دلیل تطابق» (مثلاً تطابق بصری یا تطابق نام فایل) و یک تولتیپ است که جزئیات امتیاز هر بخش را نشان میدهد. پرسوجوهای زبانهای CJK (چینی، ژاپنی، کرهای) بهصورت bigramهای همپوشان پردازش میشوند؛ به این معنی که جستوجوی «台北車站» (ایستگاه تایپه) با «台北» (تایپه) و «車站» (ایستگاه) نیز تطابق مییابد.
- صحنهها (Scenes): هدفگیری لحظات خاص در ویدیوها و بازگرداندن یک پوستر و کد زمانی.
- نویسهخوانی نوری (OCR): استفاده از Tesseract برای تطبیق متنهای واقعی موجود در تصاویر و فریمها در ۳۶ زبان (انگلیسی به علاوه ۳۵ زبان قابل فعالسازی). این حالت نام فایلها را نادیده میگیرد و نیازی به مدل بینایی ندارد، بنابراین حتی زمانی که موتور AI در حال گرم شدن است، فعال است. کلمات تطبیقیافته با جعبههای نارنجی در کاشیها و لایتباکس هایلایت میشوند.
- دیالوگ (Dialogue): استفاده از مدل Whisper برای تبدیل گفتار به متن، که امکان بازیابی دقیق قطعات گفتاری را فراهم میکند. این بخش در سه سطح عمل میکند: «جمله دقیق» (عبارت پیوسته)، «کلمات دقیق» (تمام کلمات در یک گفته یا پنجره زمانی ۸ ثانیهای) و «کلمات گفتهشده» (تمام کلمات در یک ویدیو). کلمات تطبیقیافته در قطعه گفتاری هایلایت میشوند.
- مدلهای زبانی (Ask): یک قابلیت اختیاری با استفاده از یک sidecar از llama.cpp (پیشفرض Qwen3 1.7B) برای گفتگو با متادیتای استخراجشده و دیالوگها.
ادغام LLM و حالت گفتگو
تا زمانی که در مسیر Settings → LLMs Chat فعال نشود، هیچ فایلی برای قابلیت LLM دانلود یا اجرا نمیشود. سیستم از یک sidecar از llama.cpp استفاده میکند که به loopback متصل است تا بر اساس شواهدی که قبلاً استخراج شدهاند (خطوط دیالوگ، متنهای OCR و کلمات کلیدی نام فایل) به سوالات پاسخ دهد. پاسخها بهصورت توکنبهتوکن استریم شده، دارای نمایش زنده سرعت توکن در ثانیه (tok/s) هستند و شامل ارجاعات شمارهگذاری شدهای میباشند که کاربر میتواند برای تایید منبع روی آنها کلیک کند.
کاربران میتوانند با دستورات پیشرو مانند /screenshots ، /videos یا /email دامنه دادهها را محدود کنند. سیستم بهگونهای طراحی شده که بسیار بهینه باشد؛ اگر هیچ شواهدی یافت نشود، فرآیند پیش از اجرای مدل متوقف (short-circuit) میشود. همچنین کاربران میتوانند از دکمه «Stop» برای نگه داشتن یک پاسخ ناقص استفاده کنند.
دو مدل اصلی در دسترس هستند:
- Qwen3 1.7B (پیشفرض): حدود ۱.۱ گیگابایت. برای گفتگوهای روزمره سریع که روی مکهای ۸ گیگابایتی جا میشود.
- Llama 3.2 3B: حدود ۲ گیگابایت. پاسخهای بلندمدت و قویتری ارائه میدهد اما به فضای حافظه بیشتری نیاز دارد.
معماری محلی و حریم خصوصی
حریم خصوصی، هسته معماری SCM است. این اپلیکیشن با electron-builder بستهبندی شده و از Bun به عنوان مدیریت بسته استفاده میکند. رندرر یک باندل app:// سندباکس شده با contextIsolation ، یک سندباکس سیستمعامل و یک CSP متصل به 'self' است.
تمام وزنهای مدلها، از جمله مدل CLIP حدود ۴۳۵ مگابایتی و ترنسکریپتهای Whisper، یکبار دانلود شده و بهصورت محلی در مسیر ~/Library/Application Support/scm (یا یک مسیر سفارشی MEMORIES_DATA_DIR) ذخیره میشوند. این دایرکتوری شامل فایل JSON ایندکس، فایلهای باینری بردار Float32، فایلهای جانبی صحنه/ترنسکریپت و تامنیلها است. تنها Workerهای فرآیند اصلی (main-process) دانلودها را از Hugging Face، CDN تسراکت و گیتهاب مدیریت میکنند و تمام فایلها در زمان دانلود با sha256 تایید میشوند.
برای مدیریت کتابخانه، SCM از هشینگ محتوا (SHA-256) استفاده میکند تا حتی در صورت تغییر نام فایل، تکراریها شناسایی و حذف شوند. همچنین قابلیت «پوشههای تحت نظارت» (Watched Folders) را دارد که محتوای جدید را از طریق fs.watch و یک همگامسازی در هر بار اجرا، بهطور خودکار وارد میکند. فایلهای مشکلدار تا ۳ بار تلاش میشوند و سپس نادیده گرفته میشوند. اپلیکیشن همچنین از «نسخههای بردارسازی» (Embedding Versions) پشتیبانی میکند که به کاربران اجازه میدهد تا ۱۰ اسنپشات از وضعیت قابل جستوجوی کتابخانه را برای بازیابی ذخیره کنند.
تبهای هوشمند و قابلیتهای خاص
SCM «تبهای هوشمند» را برای محدود کردن دامنه جستوجو معرفی کرده است. کاربران میتوانند هر پرسوجویی را با استفاده از دکمه پین زیر نوار جستوجو به عنوان یک تب ذخیره کنند (تا ۲۰ تب قابل تغییر نام). این تبها دقیقاً پرامپت و حالت خاص (Files/Scenes/OCR/Dialogue) را همانطور که ذخیره شده بودند، بازیابی میکنند.
تب ایمیل بهطور خاص قابل توجه است؛ این تب از OCR برای یافتن عکسهایی که حاوی آدرس ایمیل هستند استفاده میکند. تشخیص آن نسبت به خطاهای OCR مقاوم است و آدرسهایی را که Tesseract در جعبههای کلمات مختلف تکه تکه کرده است، دوباره سرهم میکند. این سیستم نویزهایی مانند موارد زیر را مدیریت میکند:
- "gmail,com" (استفاده از کاما بهجای نقطه)
- "gmail. com" (جدا شدن پسوند دامنه)
- ابهامزداییهای داخل کروشه مانند "[at] gmail [dot] com"
- آدرسهای دیکته شده مانند "allen at gmail dot com"
کاشیها یک نوار مخاطب برای کپی سریع یا ارسال ایمیل نمایش میدهند.
تب اسکرینشاتها از یک سیستم طبقهبندی اولویتدار استفاده میکند تا حتی با تغییر نام فایل، آنها را شناسایی کند. این رویکرد مشابه سازوکار مدلهای محلی برای اتوماسیون تصاویر در macOS است که بر پردازش هوشمند محتوای بصری در محیط محلی تأکید دارد. این سیستم سیگنالها را به این ترتیب بررسی میکند:
۱. اورراید دستی (از طریق راستکلیک).
۲. واژگان نام فایل (بیش از ۳۰ نام سیستمعامل محلی در ۲۰+ زبان).
۳. بررسی متادیتای PNG/JPEG (خواندن کلمه "screenshot" از تکههای متنی PNG یا EXIF UserComment).
۴. نشانههای پوشه منبع.
هر چیزی که با این معیارها تطابق نداشته باشد، در دسته «پروژهها» (Projects) قرار میگیرد.
خط لوله فنی و عملکرد
پردازش ویدیو توسط ffmpeg انجام میشود که مرزهای نماها (Shot boundaries) را اسکن میکند. کاربران میتوانند تراکم نمونهبرداری را در مسیر Settings → Video Search تغییر دهند. هر پیشفرض، زمان اندازهگیری شده و هزینه دیسک خود را نمایش میدهد:
- Eco: هر ۶۰ ثانیه یک نقطه (بودجه ۴ تا ۳۲ سگمنت).
- Balanced (پیشفرض): هر ۳۰ ثانیه یک نقطه (بودجه ۸ تا ۱۲۸ سگمنت).
- Detailed: هر ۱۵ ثانیه یک نقطه (بودجه ۱۲ تا ۲۵۶ سگمنت).
- Ultra: هر ۵ ثانیه یک نقطه (بودجه ۱۶ تا ۱۰۲۴ سگمنت).
- Ultra Pro: هر ۲.۵ ثانیه یک نقطه (بودجه ۲۴ تا ۲۰۴۸ سگمنت؛ نیازمند تایید کاربر).
برنامههای نما (Shot plans) بر اساس مسیر، اندازه، mtime و اثر انگشت تنظیمات برای هر فایل کش میشوند تا در وارد کردن مجدد، شناسایی دوباره انجام نشود. برای دیالوگها، کاربران میتوانند بین مدلهای Whisper tiny.en (حدود ۱۵۰ مگابایت) یا base.en (حدود ۳۰۰ مگابایت) انتخاب کنند. ویدیوهای کامل از میانگین سه فریم (۲۰٪، ۵۰٪ و ۸۰٪) برای بردارسازی استفاده میکنند، در حالی که GIFها از میانگین فریمهای میانی استفاده میکنند.
پشتیبانی از زبان و OCR
Tesseract در یک Worker مجزا، جدا از مدل بینایی اجرا میشود. انگلیسی همیشه فعال است و ۳۵ زبان دیگر در مسیر Settings → Photo Search قابل فعالسازی هستند. مجموعه پیشفرض شامل چینی ساده شده و سنتی، ژاپنی و کرهای است. هر بسته زبانی یکبار دانلود میشود (حدود ۲.۴ تا ۵ مگابایت؛ حدود ۱۷ مگابایت برای مجموعه پیشفرض) و سپس کاملاً آفلاین عمل میکند. جعبههای کلمات همراه با متن ذخیره میشوند تا تطابقها در جای خود هایلایت شوند و متنهای CJK بدون فاصله به هم متصل میشوند.
نصب و توسعه
این پروژه با رندر React و Vite ساخته شده و برای Apple Silicon و macOS 12+ بهینه شده است. نصب آن از طریق Homebrew با استفاده از یک tap (allenv0/homebrew-scm) و cask انجام میشود که بهطور خودکار پرچم قرنطینه macOS را پاک میکند تا مراحل دستی Gatekeeper دور زده شود. در این راستا، کنترلهای سختگیرانه macOS نقش مهمی در مدیریت دسترسیهای این ابزارها برای کاهش ریسکهای امنیتی ایفا میکنند.
دستورات نصب شامل موارد زیر است:brew tap allenv0/scmbrew trust allenv0/scmbrew install --cask allenv0/scm/scm
توسعهدهندگان میتوانند با bun run dev برای ساخت باندل رندر و اجرای Electron، یا bun start برای اجرا بدون بازسازی، از اپلیکیشن استفاده کنند. فرآیند ساخت شامل vite build برای رندر و electron-builder --mac برای بستهبندی است. نصبکنندههای نهایی مانند SCM-0.2.4.dmg و SCM-0.2.4.zip در پوشه dist-app/ خروجی داده میشوند.
تست و تضمین کیفیت
SCM شامل یک باتری تست جامع است. دستور bun run test:all هر دو مجموعه تست واحد (Unit) و تستهای دودهای (Smoke) را اجرا میکند. تستهای واحد هستههای خالص مانند رتبهبندی، توکنهای CJK و شناسایی MIME را پوشش میدهند. تستهای دودهای E2E داخل اپلیکیشن Electron از طریق متغیرهای محیطی ELECTRON_SMOKE_* اجرا میشوند و سناریوهایی از بررسی پروتکل بوت تا مهاجرت مدل را پوشش میدهند. بنچمارکهای استنتاج، غنیسازی و شناسایی، گزارشهای JSON را در فایلهای Markdown مینویسند.
رابط کاربری و جزئیات نهایی
اپلیکیشن دارای یک صفحه تنظیمات به سبک macOS با ۱۰ پنل مجزا است، از جمله کتابخانه، ظاهر، شبکه و میانبر جهانی. جزئیات بصری شامل افکت صفحه CRT برای لایتباکس، ۶ آیکون مختلف برای اپلیکیشن، حالت «فقط نوار منو» و یک تور راهنمای اولین اجرا است. سینیهای کارهای پسزمینه برای صحنهها، ترنسکریپتها و OCR شامل یک دکمه توقف جهانی هستند، در حالی که یک نوار وضعیت، نسخهگذاری و تعداد ویدیوهای ایندکسشده را ردیابی میکند.
این رویکرد به ایندکسگذاری محلی، این فرض را که جستوجوی عمیق رسانهای نیازمند محاسبات ابری است، به چالش میکشد. SCM ثابت میکند که یک «حافظه بصری» با کیفیت بالا میتواند کاملاً آفلاین روی یک لپتاپ خانگی وجود داشته باشد.
برای کاربران، این به معنای حذف کامل تضاد بین راحتی و حریم خصوصی است. دیگر نیازی نیست بین جستوجوی هوشمند و امنیت ویدیوهای خانوادگی خود یکی را انتخاب کنید.
برای شروع، کاربران مک میتوانند ابزار را از طریق Homebrew با دستور brew install --cask allenv0/scm/scm نصب کرده و شروع به ایندکسگذاری پوشههای محلی خود کنند.



گفتگو