اگر برای میزبانی عاملهای هوش مصنوعی با پنجرههای متنی بلند روی GPUهای شخصی تلاش میکنید، احتمالاً با «دیوار حافظه» برخورد کردهاید که سرعت سیستم را به شدت کاهش میدهد. SparseEngine، موتور استنتاج جدیدی که در ۱۳ اکتبر ۲۰۲۶ تحت مجوز Apache-2.0 منتشر شد، این مشکل را با تبدیل حافظه KV به یک لایه انتزاعی و قابل تعویض به جای یک ساختار ثابت حل میکند.
به نقل از مقاله منتشر شده در arXiv (کد ۲۶۰۹.۳۹۰۶۸v۱) توسط تیمی از مؤسسه فناوری هاربین، این پروژه اکنون در مخزن CURRENTF/SparseEngine در دسترس است. اکثر موتورهای استنتاج فعلی، مدیریت حافظه را به یک ساختار کش خاص گره میزنند؛ این بدان معناست که یک موتور مبتنی بر «صفحه» (page-based) ممکن است یک متد خاص از توجه پراکنده را پشتیبانی کند اما متد دیگری را مسدود کند. این رویکرد یادآور چالشهای مدیریت حافظه است که در بررسی تفاوتهای حافظه مجازی و تخصیص ایستا در KV-Cache به تفصیل تحلیل کردیم. این موضوع یک محیط صلب ایجاد میکند که در آن توسعهدهندگان باید بین کارایی یک موتور خاص و دقت یک متد خاص یکی را قربانی کنند.
حافظه GPU شما را مثل یک انبار تصور کنید. اکثر موتورها شما را مجبور میکنند از یک سیستم قفسهبندی خاص استفاده کنید؛ اگر بخواهید روش سازماندهی کالاها برای صرفهجویی در فضا تغییر دهید، باید کل انبار را تخریب کرده و دوباره بسازید. SparseEngine در مقابل، یک «قرارداد چرخه حیات» (lifecycle contract) جهانی ارائه میدهد که اجازه میدهد روشهای مختلف سازماندهی، بدون تغییر در زیرساخت، به سیستم متصل شوند. همانطور که در تحلیلهای قبلی ما درباره بهینهسازی حافظه در مدلهای بازمتن اشاره کردیم، حذف گلوگاههای سختافزاری کلید مقیاسپذیری عاملهای هوشمند است.
معماری انعطافپذیر
استنتاج برای گفتگوهای طولانی، بودجه محاسباتی را در دو بخش مصرف میکند: حافظه KV (KV Cache) — که وضعیت توجه برای هر توکن پردازششده را نگه میدارد — و محاسبات توجه که این دادهها را میخواند. متدهای توجه پراکنده با نگه داشتن تنها بخشی از این وضعیت، هر دو بخش را بهینه میکنند.
SparseEngine در هسته خود، زمانبندی (scheduling)، دستهبندی (batching) و کش پیشوند (prefix caching) را از نمایش واقعی حافظه KV جدا میکند. این ساختار اجازه میدهد ۱۵ متد مختلف در چهار دسته اصلی میزبانی شوند:
- توجه پراکنده پویا (Dynamic sparse attention): متدهایی که در لحظه تصمیم میگیرند کدام ورودیها باقی بمانند.
- حذف KV (KV eviction): تکنیکهایی مثل SnapKV یا H2O که تصمیم میگیرند کدام بخشهای حافظه دور ریخته شوند.
- کوانتیزاسیون KV (KV quantization): کاهش دقت وضعیت ذخیرهشده برای کم کردن حجم حافظه.
- فشردهسازی KV (KV compression): متراکم کردن نمایش وضعیت توجه.
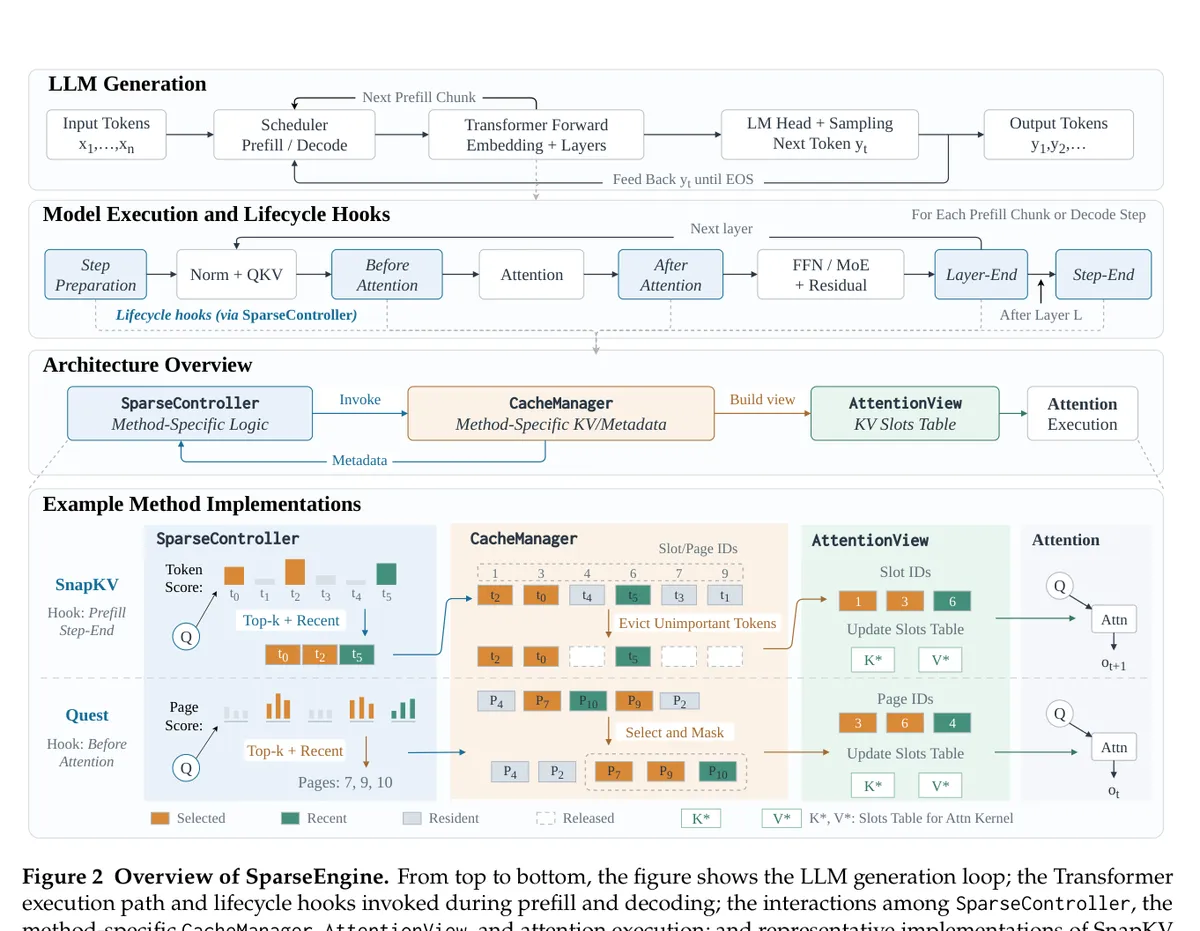
موتورهای موجود اغلب متدها را بر اساس ساختار حافظهشان محدود میکنند. در مقاله ذکر شده که موتورهایی مانند Vortex (عملیات متمرکز بر صفحه)، SPIN (بخشبندی خط لوله GPU-CPU) و Tangram (حفظ سر-محور یا head-wise) برای خانوادههای خاصی از متدها مناسب هستند اما فاقد انعطافپذیری کلیاند. SparseEngine این مرز را جابجا میکند. با استفاده از قلابهای (hooks) دقیق در مراحل پیشپُرکردن (prefill)، رمزگشایی (decoding) و انتقال بین گامها، این موتور اجازه میدهد هر متد جریان کاری خود را تعریف کند.
برای تیمهای عملیاتی، این یعنی تست استراتژیهای مختلف بدون بازنویسی کل پشته استقرار. یک جزئیات کلیدی در اینجا ChainCacheIndex است که یک جلسه را به حافظه KV لایهای، متادیتای متد و پیشوند توکنهای منطقی متصل میکند؛ این همان وضعیت ضروری است که یک متد حذف برای بازگشت به تاریخچه در نوبت بعدی نیاز دارد.
سنجش جهش در توان عملیاتی
طبق گزارش مقاله پژوهشی (arXiv:2609.39068v1)، میزان بهبود عملکرد قابل توجه است اما به شدت به اندازه دسته (batch size) و متد مورد استفاده بستگی دارد. تیم تحقیق از مدلهای Qwen3-30B-A3B در حالت FP8 و GLM-4.7-Flash در حالت BF16 روی سختافزارهای متنوع از NVIDIA H100 و H20 و RTX PRO 6000 تا GPUهای مصرفکننده مثل ۴۰۹۰ و ۵۰۹۰ استفاده کردند.
در استفاده از SnapKV و در بزرگترین اندازه دسته موفق، SparseEngine توان عملیاتی رمزگشایی مجموع را تقریباً ۱۰ برابر بیشتر از vLLM خام ثبت کرد. البته پژوهشگران اشاره میکنند که این یک مقایسه در «نقطه عملیاتی» است؛ یعنی حذف تهاجمی دادهها در SnapKV اجازه میدهد دستههای بسیار بزرگتری در یک بودجه حافظه ثابت جای بگیرند. این جهش در توان عملیاتی، رویکردی مشابه با معماری تفکیکشده Cerebras دارد که توان عملیاتی استنتاج را تا ۵ برابر افزایش داد تا محدودیتهای سختافزاری را دور بزند.
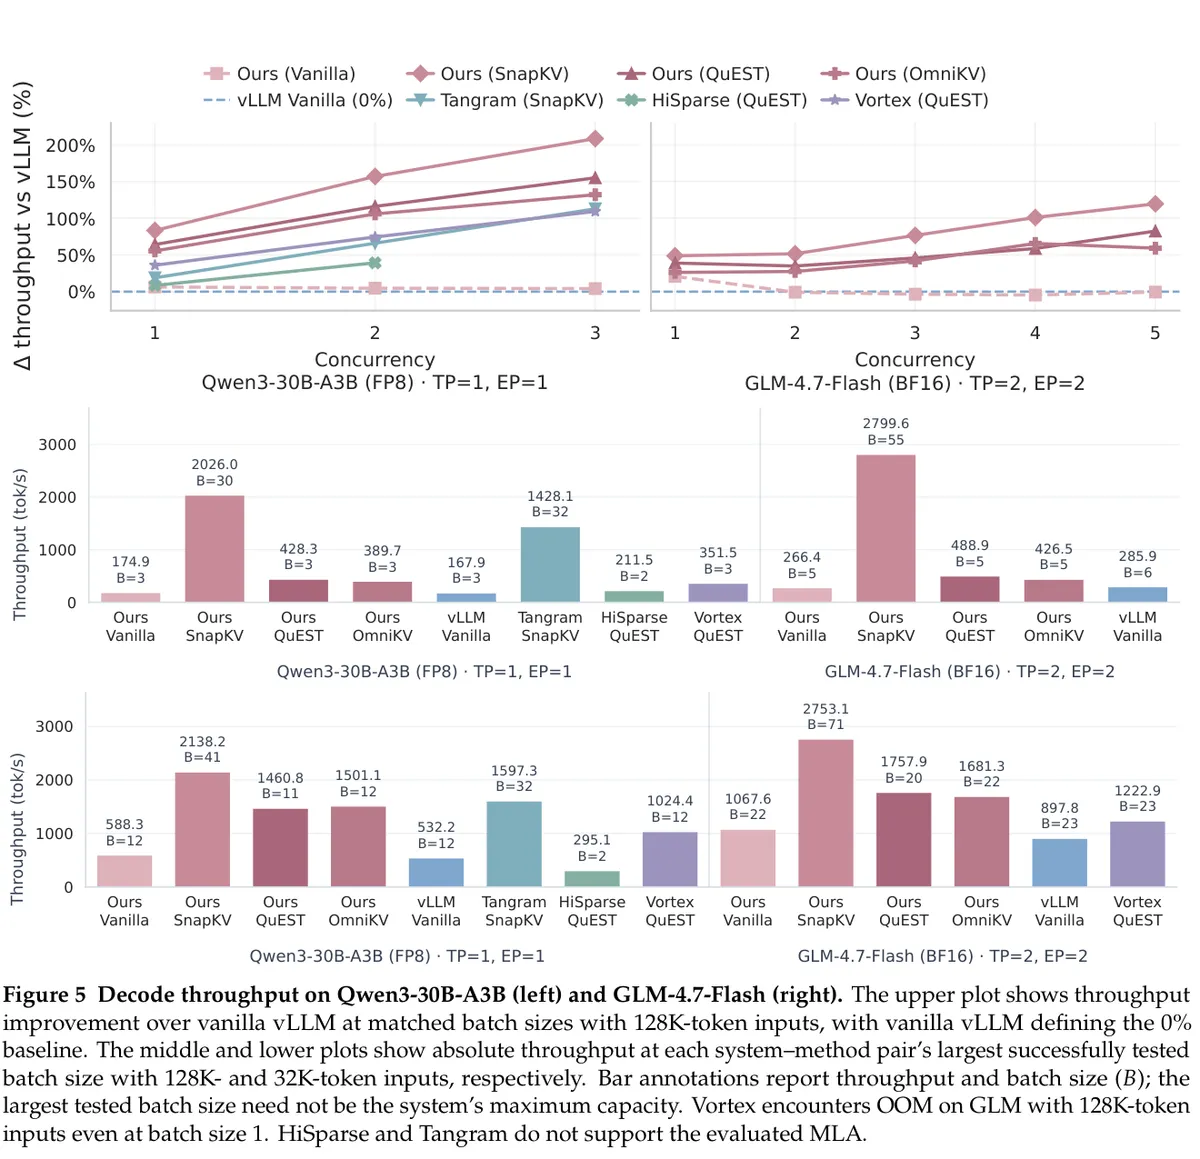
در اندازههای دسته یکسان، دستاوردها متواضعتر اما همچنان اثرگذار هستند. با استفاده از Quest و OmniKV، افزایش توان عملیاتی بین ۱.۵ تا ۲.۶ برابر بود.
نکات مهمی درباره این ارقام وجود دارد. برای مثال، Vortex در ورودیهای ۱۲۸ هزار توکنی حتی با اندازه دسته ۱، روی مدل GLM با خطای کمبود حافظه (OOM) مواجه شد. علاوه بر این، HiSparse و Tangram از مدل توجه نهفته چند-سر (multiple-head latent attention) که در مدل GLM استفاده شده، پشتیبانی نمیکنند. این موضوع تأکید میکند که مزیت کلی از توانایی موتور در نگه داشتن دستههای بزرگتر از طریق حذف تهاجمی دادهها میآید.
حل مشکل عاملهای چند-نوبتی
یکی از کاربردیترین اضافات، Chain Cache است. در گردشکارهای معمول عاملها، یک عامل کدنویس ممکن است هر بار با شروع نوبت جدید، کل زمینه را بازسازی کند چون حافظه بین نوبتها پاک میشود. Chain Cache اجازه میدهد یک متد حذف، از تاریخچه فشردهشده خود ادامه دهد.
در محک SWE-bench Lite با مدل GLM-4.7-Flash، متد SnapKV تحت Chain Cache توانست ۲۴.۷٪ از وظایف را حل کند که تقریباً با نرخ موفقیت توجه کامل (۲۵.۰٪) و متد Quest (۲۵.۳٪) برابری میکند. در مدل Qwen3-30B-A3B نیز SnapKV نرخ ۸.۳٪ را در برابر ۵.۳٪ توجه کامل ثبت کرد، هرچند حجم دادههای پایه برای رتبهبندی قطعی متدها کوچک بود.
شواهد بیشتر در اجرای Claw-Eval دیده میشود، جایی که OmniKV به امتیاز متوسط ۶۸.۰ رسید و نرخ pass@1 آن ۵۱.۱٪ بود که کمی از مرجع توجه کامل (امتیاز ۶۷.۴ و pass@1 ۵۰.۵٪) پیشی گرفت. برای سنجش کارایی سیستم، تیم از ردپای اختصاصی عاملی به نام Gasai استفاده کرد. در مدل Qwen3-30B-A3B در حالت FP8، ترکیب SnapKV با بودجه حافظه ۸ هزار توکن و Chain Cache، به شتاب ۲.۲۴ برابری در کل فرآیند (end-to-end) نسبت به vLLM دست یافت.
تیم همچنین قابلیت هرس پیشوند (prefix pruning) را معرفی کرد. این ویژگی به توسعهدهندگان اجازه میدهد بخشهای کمارزش تاریخچه — مثل نتایج تکراری ابزارها در یک گفتگوی طولانی — را حذف کنند در حالی که تطبیق پیشوند فعال بماند. نگه داشتن ۲۰٪ از توکنهای KV تراز شده در نتایج ابزارهای هدفمند با امتیازدهی جهانی، تنها باعث افت جزئی در موفقیت شد. جالب است که به تأخیر انداختن این هرس برای چهار دور نتایج ابزار با OmniKV، نرخ موفقیت وظایف را در ۳۰۰ تست به ۲۵.۰٪ بازگرداند، در حالی که برای vLLM این رقم ۲۳.۷٪ بود.
موازنه صحت و سرعت
SparseEngine تضاد بنیادی بین سرعت و دقت را از بین نمیبرد. ارزیابی روی AIME 2024 با یک مدل تفکر کوچک، تفاوتهای واضحی را نشان داد:
- StreamingLLM: صحت ۱۸.۳٪ با شتاب ۳.۳۶ برابری.
- PyramidKV: صحت ۵۳.۳٪ با شتاب ۱.۶۶ برابری.
- SnapKV (بودجه بالا): صحت ۸۵.۰٪ با شتاب ۱.۰۵ برابری.
با کوتاه شدن زمینهها، شتابها کمتر میشوند چون توجه سهم کمتری از کل زمان اجرا میگیرد. مقاله صراحتاً بیان میکند متدهایی که شتاب بیشتری ارائه میدهند، معمولاً دچار افت صحت بیشتری میشوند.
کیفیت روی LongBench V1 و V2 ردیابی شد، جایی که ارقام گزارش شده، تفاضل (delta) بین SparseEngine و پیادهسازی مرجع هر متد بود. این تأیید میکند که موتور، کیفیت متدی را که میزبانی میکند بازتولید میکند. برای تیمی که عاملها را مستقر میکند، عدد حاکم «بودجه صحت» است که حاضرند برای همزمانی بالاتر هزینه کنند. برای مثال در SWE-bench Lite با مدل GLM-4.7-Flash، متد H2O نرخ حل وظایف را به ۱۳.۰٪ کاهش داد در حالی که توجه کامل ۲۵.۰٪ بود.
پیامدهای استقرار
برای سازمانهایی که خوشههای GPU خود را مدیریت میکنند، این تغییر شکل استقرار را عوض میکند. حذف فیزیکی دادهها اجازه میدهد دستههای بزرگتری در هر GPU جای بگیرند، به این معنی که میتوانید با تعداد نسخههای (replicas) کمتر، درخواستهای همزمان بیشتری را مدیریت کنید.
این امر ردپای سختافزاری مورد نیاز برای میزبانی عاملهای با زمینه بلند را کاهش میدهد. بهجای مقیاسدهی افقی با GPUهای بیشتر، تیمها میتوانند با بهینهسازی مدیریت حافظه KV در هر درخواست، مقیاسدهی عمودی کنند.
اگر در حال ساخت یک پلتفرم هوش مصنوعی میزبانی-شخصی هستید، نکته کلیدی «قابلیت تعویض» است. با ظهور متدهای جدید توجه پراکنده، میتوانید آنها را بدون مختل کردن منطق دستهبندی پیوسته یا کش پیشوند، در SparseEngine ادغام کنید. در این زمینه، درک محدودیتهای سختافزاری اهمیت دارد؛ برای مثال، بررسی ما روی مکمینی نشان داد که دستهبندی پیوسته میتواند در شرایط خاص توان عملیاتی را کاهش دهد، لذا انتخاب متد مناسب در SparseEngine حیاتی است.
برای تست این ادعاها، تیمهای سرویسدهنده میتوانند به کد منتشر شده در گیتهاب دسترسی یابند. این مخزن عمدتاً با پایتون نوشته شده، تحت مجوز Apache-2.0 است و از ژانویه ۲۰۲۶ تا ۸ اکتبر ۲۰۲۶ فعال بوده و در زمان بررسی، ۸۳ ستاره و ۱۳ فورک داشت. پیشنهاد میشود با بنچمارک کردن حجم کاری خاص خود، بهینه ترین توازن را بین ۱۵ متد موجود و آستانه صحت مورد نیازتان پیدا کنید.
گام بعدی شما
- اگر از vLLM برای مدلهای با زمینه بلند استفاده میکنید، مخزن SparseEngine را برای تست متد SnapKV بررسی کنید تا میزان افزایش Batch Size را بسنجید.
- بودجه صحت (Accuracy Budget) پروژه خود را تعریف کنید تا متوجه شوید کدام یک از ۱۵ متد موجود با نیاز شما سازگار است.
- قابلیت Chain Cache را برای عاملهایی که در چندین نوبت با کاربر تعامل دارند فعال کنید تا از بازسازی costly زمینه جلوگیری شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو