اگر امروز در حال توسعه یک دستیار صوتی هستید، باید بدانید که رقابت در دقت تبدیل گفتار به متن به نقطهی اشباع رسیده است. حالا دیگر سؤال این نیست که کدام مدل دقیقتر است، بلکه سؤال این است که کدام مدل در دنیای واقعی کمتر گم میشود.
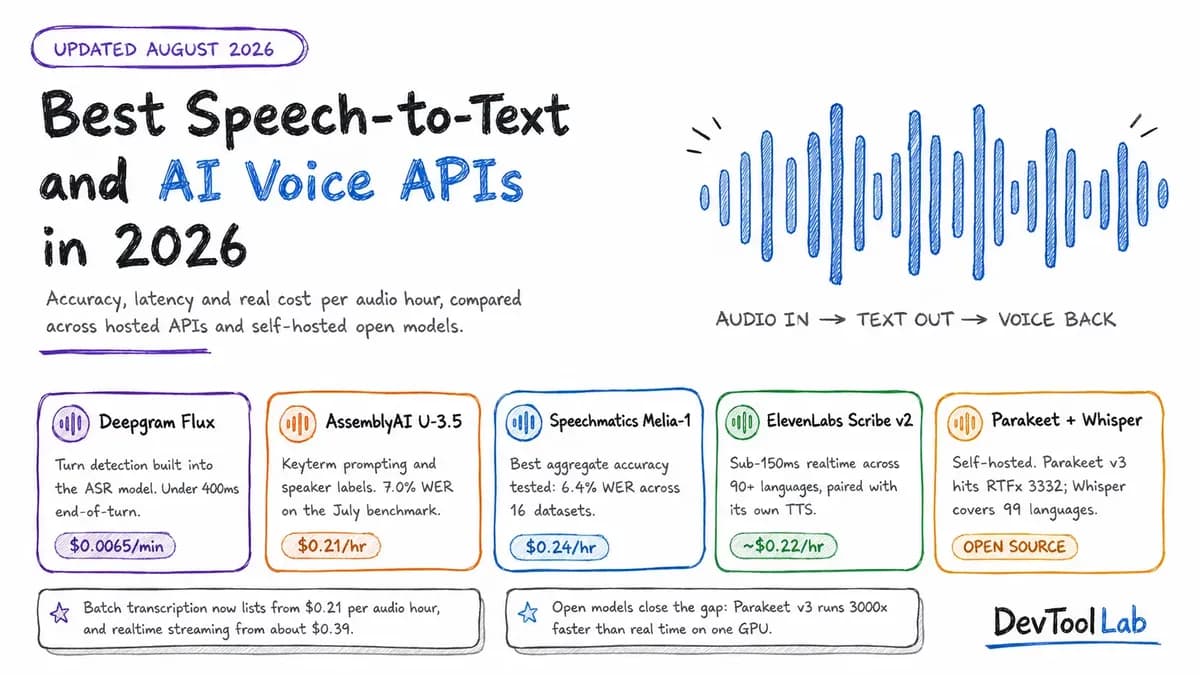
به گزارش DevToolLab، مدل Speechmatics Melia-1 با نرخ خطای کلمه (WER) ۶.۴ درصد، اکنون در صدر ۱۴ مدل تجاری بازار قرار دارد. این برتری اندک نسبت به رقبایی چون AssemblyAI Universal-3.5 Pro (۷.۰٪) و Deepgram Nova-3 (۸.۹٪) نشان میدهد که دقت پایه دیگر وجه تمایز اصلی نیست. این وضعیت تداوم روندی است که در آن شکاف دقت در مدلهای بازشناسی گفتار به زیر یک درصد رسیده و رتبهبندیهای تئوریک دیگر پیشبینیکننده عملکرد واقعی در محیط تولید نیستند. در واقع، شکاف ۲.۵ درصدی بین برترین سرویسها، گاهی کمتر از تفاوت کیفیت بین یک فایل صوتی شفاف و یک فایل پر از نوفه است. همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی استنتاج اشاره کردیم، تمرکز بازار دارد از «مدلهای بزرگتر» به سمت «ابزارهای کاربردیتر» حرکت میکند.
انتخاب API مناسب اکنون به نوع مسئله صوتی شما بستگی دارد. بازشناسی گفتار (ASR) — شبیه به یک گوش شنوایی که سعی میکند صداهای محیط را به حروف الفبا تبدیل کند — به سه لایهی متمایز تقسیم میشود:
سه سطح تبدیل گفتار به متن
- رونویسی دستهای (Batch Transcription): برای فایلهای ذخیره شده که تأخیر در آنها مهم نیست، اما هزینه و دقت در اصطلاحات تخصصی حیاتی است.
- جریانهای آنی (Real-time Streaming): مورد استفاده در عاملها (Agents)؛ جایی که چالش اصلی «تشخیص نوبت» (Turn Detection) است تا سیستم بفهمد کاربر مکث کرده یا صحبتش تمام شده است.
- تبدیل متن به گفتار (TTS): گام نهایی برای تبدیل پاسخ متنی به صوت.
یک مدل که برای رونویسی یک جلسه دو ساعته بهینه شده، احتمالاً در هدایت یک عامل تلفنی زنده، جایی که تأخیر (Latency) تنها معیار مهم است، شکست میخورد.

برای کسانی که محصولات تخصصی میسازند، «پرامپتینگ کلمات کلیدی» (Keyterm Prompting) بسیار ارزشمندتر از بهبود جزئی در نرخ خطا است. اگر محصول شما نامهای خاص دارویی یا کدهای کالا (SKU) دارد، این ویژگی اولویت شماست. برای مثال، AssemblyAI به کاربران اجازه میدهد تا ۱۰۰۰ کلمه کلیدی خاص را از طریق SDK پایتون خود در اولویت قرار دهند.
به همین ترتیب، مدل متنباز Whisper از آرگومان initial_prompt برای اصلاح اصطلاحات تخصصی استفاده میکند. در یکی از تستهای DevToolLab روی یک فایل ۹ ثانیهای در پردازشگر CPU، مدل تنها در ۰.۶ ثانیه پاسخ داد. مدل ابتدا «DevToolLab» را اشتباه شنید، اما با افزودن یک خط راهنمای واژگانی، این خطا کاملاً و رایگان برطرف شد.
جزئیات فنی عملکرد
- پشتیبانی چندزبانه: مدل Speechmatics Melia-1 بیش از ۵۶ زبان را در یک مرحله و بدون نیاز به راهنمایی کاربر پردازش میکند. این قابلیت مشکل «تغییر کد» (Code-switching) را حل میکند؛ یعنی جملهای که با اسپانیایی شروع و با انگلیسی تمام میشود، بدون بههم ریختگی مرزهای زبانی پردازش میشود. هزینه این سرویس از ۰.۱۲۹ دلار برای هر ساعت شروع میشود.
- تأخیر عامل: مدل Deepgram Flux تشخیص پایان نوبت را مستقیماً در مدل ادغام کرده است. این مدل در کمتر از ۴۰۰ میلیثانیه تصمیم میگیرد که آیا کاربر صحبتش را تمام کرده یا خیر و رویدادهایی مثل
EndOfTurnرا صادر میکند تا از قطع صحبت کاربر توسط عامل جلوگیری شود. - توان عملیاتی (Throughput): مدل NVIDIA Parakeet TDT 0.6B v3 میتواند یک ساعت صوت را در حدود یک ثانیه روی GPU A100 پردازش کند و به نرخ خطای ۶.۳۲٪ با سرعتی بیش از ۳۰۰۰ برابر زمان واقعی برسد.
- رایانش لبه (Edge Computing): مدل Moonshine روی دستگاههایی مثل رزبری پای تا ۵ برابر سریعتر از Whisper اجرا میشود. این رویکرد باعث شده تا مدلهای بسیار کوچک در حجم ۵۰۰ کیلوبایت برای میکروکنترلرها، جایگزینهای جذابتری برای APIهای ابری باشند.
توسعهدهندگان باید مراقب «محرکهای پنهان» در صورتحسابها باشند که میتواند هزینهها را سه برابر کند. بسیاری از APIهای استریمینگ، هزینه را بر اساس «زمان باز بودن اتصال» محاسبه میکنند، نه حجم صوت ارسالی؛ یعنی حتی در زمان سکوت کاربر، ترافیک WebSocket هزینه میبرد.
هزینه افزونهها
هزینهی قابلیتهایی مثل تفکیک گوینده (Diarization)، تشخیص موجودیت و تحلیل موضوع معمولاً بهصورت تجمعی اضافه میشوند. هر یک از اینها میتواند ۵ تا ۱۵ سنت به نرخ ساعتی بیفزاید. فعال کردن چهار افزونه میتواند صورتحساب شما را در مقایسه با ارزانترین نرخ پایه، سه برابر کند.
این تغییرات ثابت میکند که میزبانی شخصی (Self-hosting) دیگر یک سازش نیست. مدل Whisper large-v3 با پشتیبانی از ۹۹ زبان — که بیشتر از هر API تجاری است — اکنون به اندازه کافی قدرتمند هست که به عنوان لایه اصلی تولید در محصولات قرار گیرد.
گام بعدی شما
- اگر از سرویسهای ابری استفاده میکنید، صورتحساب خود را برای نشت هزینههای اتصالهای Idle بررسی کنید.
- پیش از تغییر تامینکننده برای بهبود ۱ درصدی دقت، قابلیت Keyterm Bias آنها را تست کنید.
- برای پروژههای با حجم بالا، مدلهای متنباز را در لایه اول (Primary Production Layer) تست کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو