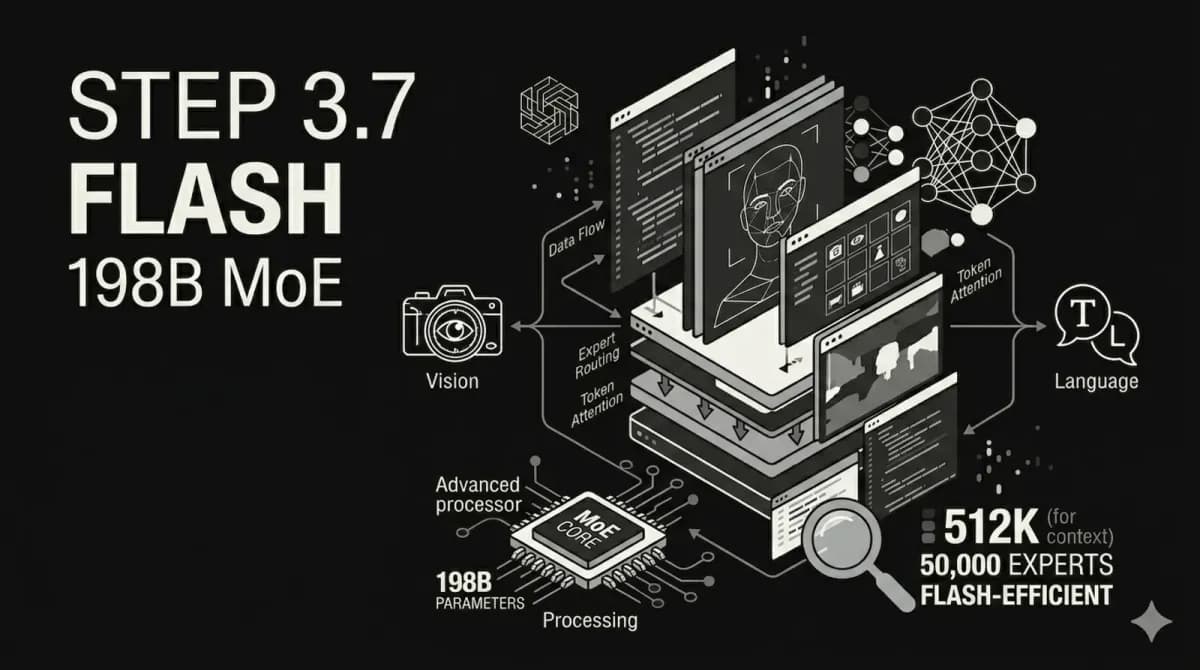
اگر امروز برای اجرای مدلهای بینایی پیشرفته بودجهای کلان اختصاص میدهید، احتمالاً از این به بعد با یکنهم آن هزینه به همان نتیجه میرسید. مدل جدید Step 3.7 Flash ثابت کرد که برای رسیدن به عملکرد سطح Pro، لزوماً نیازی به زیرساختهای غولآسا نیست. در حالی که اکثر مدلهای بینایی با ۱۹۸ میلیارد پارامتر به زیرساختهای عظیم نیاز دارند، Step 3.7 Flash اکنون روی یک باکس DGX Spark در اندازه دسکتاپ، بدون هیچ فشاری اجرا میشود.
به نقل از گزارشهای منتشر شده در شبکه X، این مدل روی یک دستگاه که دقیقاً کنار مانیتور جای میگیرد، بدون هیچ مشکلی اجرا میشود. این پست صرفاً یک نمایش قدرت یا «فلکس» نبود، بلکه راهنمایی برای یک پیکربندی (Config) بود که سه ساعت از زمان کاربر را در عیبیابی (Debugging) ذخیره کرد. Stepfun در ۲۹ مه ۲۰۲۶ با عرضه این مدل، بحث را از «اندازه خام مدل» به «قابلیت استقرار واقعی» تغییر داده است. ما با تغییری در ریاضیات تولید هوش مصنوعی در مقیاس صنعتی روبهرو هستیم.
بسیاری از توسعهدهندگان با یک دوگانگی سخت مواجهاند: یا از مدلهای کوچک و ارزان استفاده کنند که در کارهای پیچیده شکست میخورند، یا به سراغ مدلهای پیشرو (Frontier) بروند که بودجه را میبلعند. Step 3.7 Flash تلاش میکند این دوقطبی را بشکند. این مدل دقیقاً نقطه میانی و «عاملمحور» (Agentic) را هدف قرار داده است؛ جایی که قابلیت اطمینان و هزینه به ازای هر تسک تنها معیارهای مهم هستند. این رویکرد یادآور استراتژیهای مشابه در مدلهای دیگر است، همانطور که مدل V4.1-Flash دیپسیک نیز توانست با بهینگی بیشتر جایگزین نسخه پرچمدار خود شود.
معماری بهرهوری
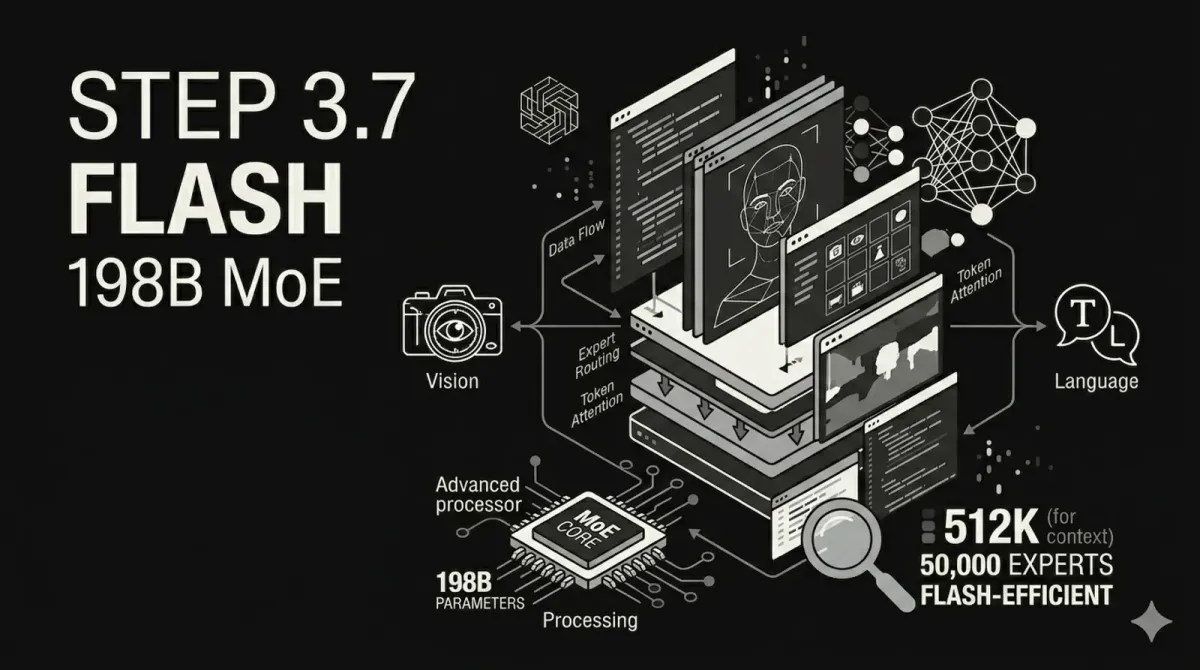
همانطور که در تحلیلهای قبلی ما درباره بهینهسازی استنتاج در مدلهای بازمتن اشاره کردیم، کاهش هزینه بدون افت کیفیت، مقدسترین هدف فعلی صنعت است. این مدل برای رسیدن به این هدف از معماری ترکیب خبرهها (Sparse Mixture of Experts یا MoE) استفاده میکند؛ شبیه به تیمی از متخصصان که هر کس در یک زمینه مهارت دارد و فقط وقتی لازم است فراخوانده میشود. اگرچه مدل در مجموع ۱۹۸ میلیارد پارامتر (Parameters) دارد، اما برای هر توکن (Token) — تکههای کوچکی از متن که مدل میخورد — تنها حدود ۱۱ میلیارد پارامتر فعال میشوند و ۱۸۷ میلیارد پارامتر دیگر در حالت استراحت میمانند و منتظر ورودی خاصی هستند که به تخصص آنها نیاز باشد. این تلاش برای بهینهسازی منابع، در راستای تحولات جدیدی است که دستوردههای پیشآموزش جدید مانند Magic، هزینه محاسباتی مدلهای باز را تا ۱۰ برابر کاهش دادهاند.
سیستم بر اساس نیازهای خاص هر پرامپت، ورودیها را به ۸ خبره از میان ۲۸۸ خبره موجود هدایت میکند. این سازوکار مسیریابی (Routing) تضمین میکند که هزینه محاسباتی هر توکن، شبیه به یک مدل متراکم ۱۱ میلیارد پارامتری باشد، نه یک غول ۱۹۸ میلیارد تایی. نتیجه این طراحی، رسیدن به توان عملیاتی (Throughput) ۴۰۰ توکن در ثانیه است که برای تعاملات بلادرنگ عاملهای هوش مصنوعی، سرعتی خیرهکننده و واقعاً کاربردی محسوب میشود.
قدرت بینایی و کدنویسی
در بخش بینایی، Stepfun یک رمزگذار ViT ۱.۸ میلیارد پارامتری را در بدنه زبانی مدل ادغام کرده تا درک بومی تصاویر را فراهم کند. این یعنی مدل میتواند طرحهای رابط کاربری (UI Wireframes)، اسناد متراکم، صحنههای طبیعی و نمودارها را بدون پرداخت «مالیات چندوجهی» (هزینه پردازشی سنگین مدلهای بزرگتر) تحلیل کند. مدل پس از پردازش ورودی بصری، میتواند بر اساس آنچه میبیند، کدنویسی کند یا ابزارها را فراخوانی نماید.
بر اساس ارزیابیهای Stepfun، نتایج این مدل با برترینهای جهان رقابت میکند:
- در آزمون SimpleVQA با جستوجو، امتیاز ۷۹.۲ را کسب کرد و با رتبه اول در دسته خود، با اختلافی بسیار اندک از GPT 5.5 (۷۹.۱) پیشی گرفت.
- در آزمون V* با ابزارهای پایتون به امتیاز ۹۵.۳ رسید که تنها کمی پایینتر از Kimi K2.6 (۹۶.۹) و Gemini 3 Flash (۹۶.۳) است.
- در محک ClawEval-1.1 با امتیاز ۶۷.۱، پیشتازی کرد و فاصله زیادی با رقیب بعدی که امتیاز ۵۹.۸ داشت، ایجاد کرد.
- در BrowseComp به ۷۵.۸۲٪ رسید که آن را به Claude Opus 4.7 با امتیاز ۷۹.۳٪ نزدیک میکند.
ترفند «حالت مشاور» (Advisor Mode)
مهمترین ویژگی برای محیطهای تولیدی، «حالت مشاور» است. اکثر گردشکارهای عاملمحور روتین هستند — مانند فراخوانی ابزارها، خواندن نتایج و تکرار گامهای ساده — که نیازی به مدلهای پیشرو و گرانقیمت ندارند.
Step 3.7 Flash کل مسیر را بهصورت سرتاسری (End-to-End) مدیریت میکند. اما وقتی به یک نقطه تصمیمگیری بحرانی میرسد — مثلاً در یک گام برنامهریزی که میتواند کل مسیر را منحرف کند یا هنگام بازیابی از شکستهای مکرر — برای دریافت راهنمایی به یک مدل «مشاور» بزرگتر مراجعه میکند. سپس بر اساس آن راهنمایی سطح بالا، به اجرای عملیات ادامه میدهد.
این پیادهسازی استراتژی «مجری-مشاور» (که ابتدا توسط Anthropic توصیف شد)، هزینه مدل گرانقیمت را در میان تعداد زیادی گام ارزان توزیع (Amortize) میکند. مدل گرانقیمت فقط در جایی استفاده میشود که واقعاً اهمیت دارد.
در محک SWE-Bench Verified، این استراتژی اجازه داد Step 3.7 Flash به نرخ موفقیت ۷۶.۳٪ با هزینه تنها ۰.۱۹ دلار به ازای هر تسک برسد. برای مقایسه، Claude Opus 4.6 به موفقیت ۷۸.۷٪ میرسد اما هزینه آن ۱.۷۶ دلار به ازای هر تسک است. در واقع شما ۹۷٪ عملکرد را با یکنهم هزینه به دست میآورید.
نقاط ضعف و چالشها
البته این مدل جایگزین همهجانبه برای سیستمهای پیشرو نیست. یک شکاف واضح در تعاملات ترمینال و اجرای دستورات پیچیده وجود دارد. در Terminal-Bench 2.1، امتیاز ۵۹.۵ این مدل در برابر ۸۲.۷ امتیاز GPT 5.5 و ۷۶.۲ امتیاز Gemini 3.5 Flash، نشان میدهد که این رقابت هنوز یک رقابت نزدیک نیست.
همچنین پوشش وظایف حرفهای عمومی نیز کمتر است. در آزمون GDPval در ۴۴ شغل مختلف، این مدل امتیاز ۴۵.۸٪ را کسب کرد در حالی که Claude Opus 4.7 به ۶۳٪ رسید. برای سختترین تسکهای استدلالی شامل ابزارها (HLE)، این مدل با ۴۷.۲٪ پشت سر Claude Opus 4.7 (۵۴.۷٪) و GPT 5.5 (۵۲.۲٪) قرار دارد.
باید به خاطر داشت که این اعداد از ارزیابیهای داخلی Stepfun است و نتایج خوداظهاری همیشه باید با این هشدار خوانده شوند.
استراتژی اولویتدهی به استقرار
من یک بار دو ساعت وقتم را صرف خواندن نسخه اشتباه یک مستند API کردم چون URL میگفت «v2» اما صفحه میگفت «v3». مستندات بهطور تصادفی زود منتشر شده بودند و من گیج شده بودم که چرا نقاط انتهایی (Endpoints) مطابقت ندارند. به همین دلیل است که من برای دستورالعملهای استقرار شفاف ارزش قائلم.
Stepfun برخلاف بسیاری از آزمایشگاهها که فقط یک پست وبلاگی و یک API بسته ارائه میدهند، وزنهای مدل را در فرمتهای BF16، FP8، NVFP4 و GGUF بهصورت همزمان در Hugging Face منتشر کرد. این یعنی مدل روی هر چیزی، از Mac Studio با ۱۲۸ گیگابایت حافظه یکپارچه تا نمونههای ابری از طریق NIM و OpenRouter، قابل اجراست.
این پشتیبانی اکوسیستمی، فاصله بین «در دسترس بودن فنی» و «قابلیت استفاده واقعی» را کاهش میدهد. مدل همچنین ثبات بهتری نشان میدهد و واریانس عملکرد در هر اجرا را از بازه ۴۳-۷۳٪ در نسخه ۳.۵ به ۶۴.۵-۷۱.۵٪ کاهش داده است.
برای توسعهدهندگانی که عاملهای تولیدی میسازند، این پیشبینیپذیری اغلب ارزشمندتر از یک افزایش جزئی در نمرات بنچمارک است. این یعنی عامل هوشمند فارغ از داربست (Scaffold) مورد استفاده، یکسان رفتار میکند.
تحلیل نهایی و صادقانه
اگر در حال ساخت یک چتبات ساده هستید که به سوالات از یک پایگاه دانش پاسخ میدهد، یک مدل متراکم کوچکتر برای شما بهتر عمل میکند. اگر کمتر از ۱۰ هزار درخواست در روز دارید، تفاوت قیمت، پیچیدگی زیرساختی را توجیه نمیکند. و اگر به بالاترین عملکرد مطلق در ترمینال نیاز دارید، مدلهای پیشرو همچنان جلوتر هستند.
اما برای ارکستراسیون ابزارها در حجم بالا، جایی که قابلیت اطمینان و هزینه به ازای هر تسک مهمتر از سقف نمرات بنچمارک است، این مدل ارزش بررسی جدی دارد. پیشتازی در ClawEval و پروفایل هزینه در حالت مشاور، تمایزهای واقعی این مدل هستند.
من مدام به آن پست X برمیگردم که یک مدل بینایی ۱۹۸ میلیارد پارامتری روی یک دسکتاپ اجرا میشد. داستان واقعی اینجا قیمت یا نمرات نیست؛ داستان این است که این سطح از توانایی اکنون به چیزی تبدیل شده که میتوانید بهسادگی اجرا کنید. شکاف بین مدلهای پیشرو و باز در حال کوچک شدن است، اما شکاف بین «در دسترس» و «کاربردی» حتی سریعتر در حال بسته شدن است. اگر Stepfun در نسخه ۳.۹ Flash شکاف Terminal-Bench را پر کند، بحث بسیار جالبتر خواهد شد.
گام بعدی شما
- اگر از مدلهای گرانقیمت برای تسکهای تکراری استفاده میکنید، معماری «مجری-مشاور» را با Step 3.7 Flash تست کنید تا هزینههایتان را کاهش دهید.
- فرمتهای GGUF مدل را برای استقرار روی سختافزارهای محلی (Local) بررسی کنید تا وابستگی به APIهای ابری را کم کنید.
- در صورت نیاز به دقت بالا در ترمینال، همچنان از مدلهای Frontier استفاده کنید اما برای تحلیلهای بینایی-زبانی، این مدل را جایگزین کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو