
تصور کنید یک مدل کوچکتر و چابکتر، مدل پرچمدار و غولپیکر خودش را بازنشسته کند. در ۱۰ سپتامبر ۲۰۲۶، شرکت دیپسیک (DeepSeek) مدل V4.1-Flash را عرضه کرد و در اقدامی نادر اعلام کرد که مدل بزرگتر V4-Pro را کنار میگذارد، چون نسخه فلش در عمل بهتر پاسخ میدهد.
این چرخش درست زمانی رخ میدهد که صنعت هوش مصنوعی از دوران «هرچه بزرگتر، بهتر» فاصله میگیرد. سالها هدف این بود که بزرگترین مدل ممکن برای کسب بالاترین نمره در بنچمارکها ساخته شود. اما حالا تمرکز روی اقتصاد استقرار است؛ یعنی چطور کیفیتی در سطح پرچمدار را با کسری از هزینه محاسباتی به دست آوریم.
این اتفاق شبیه جایگزینی یک سدان لوکس و سنگین با یک خودروی برقی کوچک و پرقدرت است که هم سریعتر است، هم سوختش ارزانتر است و هم پارک کردنش راحتتر است. در واقع مدل Pro در برابر معماری بهینه Flash به یک سربار تبدیل شده بود.
تغییر در معماری
مدل DeepSeek-V4.1-Flash صرفاً نسخه کوچکشده نسل قبل نیست. این مدل یک ترکیب خبرهها (Mixture of Experts یا MoE) — شبیه تیمی از متخصصان که هر سوال را فقط به فرد خبره در آن حوزه میسپارند — با ۵۵۲ میلیارد پارامتر و طراحی بنیادین جدید است. نکته بسیار مهم این است که این مدل از نظر خانواده و نسل با مدل DeepSeek-V4-Flash که در روز هفتم این سری معرفی شد، متفاوت است و نباید این دو با هم اشتباه شوند.
بر اساس مستندات منتشر شده، این مدل از بودجه محاسباتی نامتقارن استفاده میکند. یعنی برای پردازش ورودی تنها ۸ میلیارد پارامتر و برای تولید خروجی ۱۶ میلیارد پارامتر را فعال میکند. این تفکیک هوشمندانه باعث میشود مدل بتواند حجم عظیمی از دادهها را بخواند بدون اینکه در مرحله نوشتن و تولید متن، انرژی و منابع محاسباتی را هدر دهد.
همانطور که در تحلیل قبلی ما دربارهی بهینهسازی استنتاج در مدلهای بازمتن اشاره کردیم، کاهش ردپای سختافزاری اولویت اول توسعهدهندگان شده است. این مدل با معرفی طراحی رمزگذار-رمزگشای علی (Causal Encoder-Decoder) و درک بصری بومی، نیاز به حافظه را بهشدت کاهش داده است. بهطور مشخص، KV Cache (حافظه موقت کلید-مقدار) اکنون تنها به یکچهارم حافظه HBM (حافظه با پهنای باند بالا) و یکهشتم فضای SSD نسبت به نسل قبل نیاز دارد؛ به گونهای که کاهش خیرهکننده ۴۳۷ برابری اشغال حافظه KV Cache در این مدل به چشم میخورد.
کالبدشکافی عملکرد در دنیای واقعی
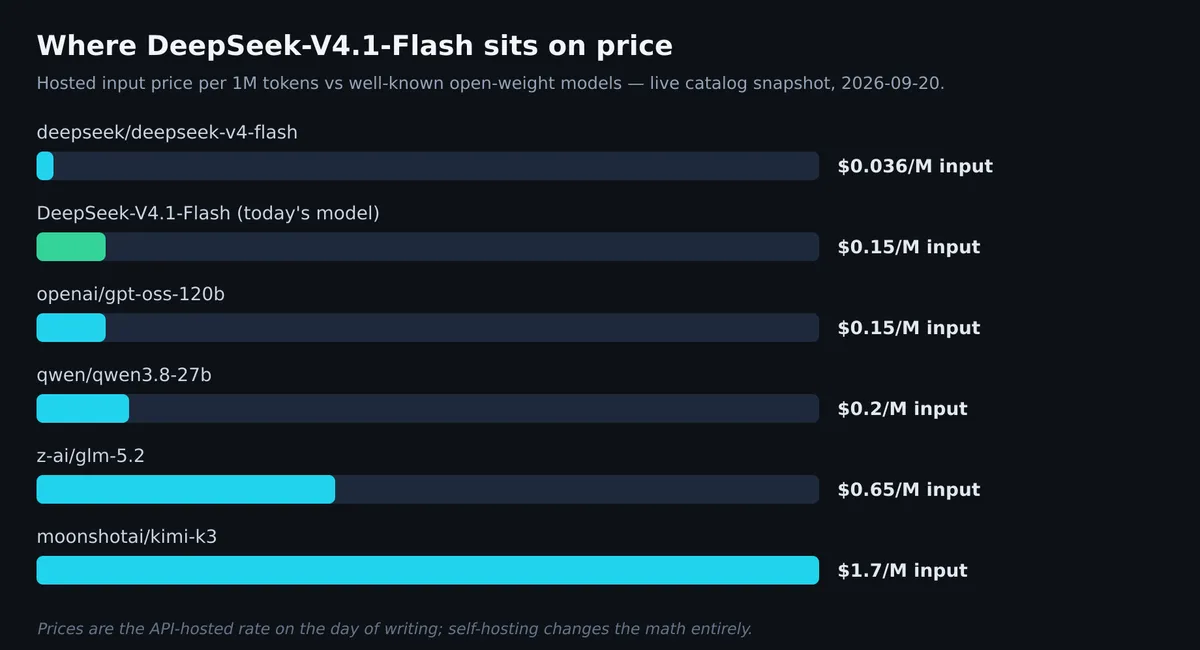
در حالی که مشخصات فنی خیرهکننده است، تستهای زنده روایت پیچیدهتری دارند. این مدل دارای پنجره زمینه (Context Window) — مثل میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — عظیم ۱,۰۴۸,۵۷۶ توکنی است. قیمتگذاری آن نیز بسیار تهاجمی است: ۰.۱۵ دلار برای هر میلیون توکن ورودی و ۰.۶۰ دلار برای هر میلیون توکن خروجی از طریق شناسه Hugging Face یعنی deepseek-ai/DeepSeek-V4.1-Flash.
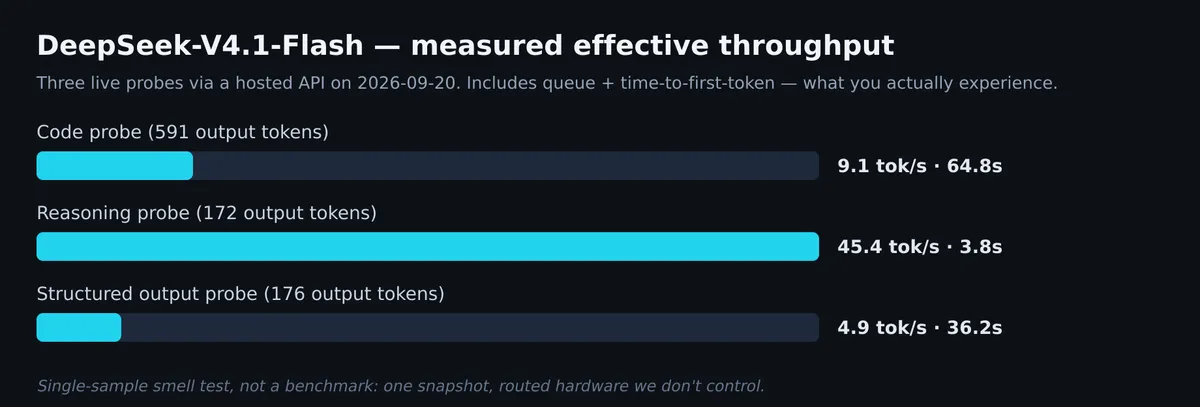
با این حال، توان عملیاتی بسته به نوع تکلیف بهشدت نوسان میکند. من سه تست سریع روی API این مدل اجرا کردم که نتایج آن شامل زمان انتظار در صف و زمان تا نخستین توکن است؛ این نتایج تجربه واقعی کاربر را نشان میدهد و نه صرفاً حداکثر سرعت رمزگشایی (Peak Decode Speed):
- تست استدلال: در یک مسئله ریاضی مربوط به پر کردن دو مخزن، مدل محاسبات را دقیق انجام داد (محاسبه ۶۰۰ لیتر پس از ۲۰ دقیقه، ۱۸۰۰ لیتر باقیمانده و ۲۰ دقیقه دیگر با سرعت ۹۰ لیتر در دقیقه). سرعت پاسخدهی خیرهکننده بود: ۴۵.۴ توکن در ثانیه و اتمام کار در ۳.۸ ثانیه با تولید ۱۷۲ توکن.
تست کدنویسی: وقتی از مدل خواسته شد تابع
merge_intervalsرا بنویسد و پیچیدگی آن را بیان کند، کد پایتونی صحیح و استانداردی تولید کرد. مدل ابتدا بر اساس نقطه شروع مرتب کرد، لیست را پیمایش نمود و با استفاده ازmax()روی مرز انتهایی، بازهها را در جای خود ادغام کرد. همچنین پیچیدگی زمانی را بهدرستی O(n log n) تشخیص داد که ناشی از عملیات مرتبسازی بود. اما تولید ۵۹۱ توکن حدود ۶۴.۸ ثانیه زمان برد که میانگین سرعت را به ۹.۱ توکن در ثانیه رساند.تست استخراج ساختاریافته: این کندترین بخش بود. مدل یک شیء JSON معتبر و دقیق شامل فروشنده، تاریخ و مبلغ کل برگرداند. با وجود دقت بالا، برای تولید تنها ۱۷۶ توکن، ۳۶.۲ ثانیه زمان صرف کرد که منجر به سرعت بسیار پایین ۴.۹ توکن در ثانیه شد.
این تفاوت فاحش — از ۴۵.۴ تا ۴.۹ توکن در ثانیه در یک جلسه واحد — نشان میدهد که در حالی که تولیدات کوتاه و متکی بر ریاضیات سریع پیش میروند، تولیدات طولانیتر یا تولیداتی که محدودیتهای ساختاری دارند، هزینه زمانی بیشتری به ازای هر توکن تحمیل میکنند.
توصیههای استقرار
به دلیل این نوسانات، این مدل برای همه کاربردها یک راهکار واحد نیست. بر اساس رفتارهای اندازهگیری شده، سه مورد استفاده مشخص پیشنهاد میشود:
- تحلیل و استدلال روی اسناد طولانی: ترکیب پنجره متنی میلیونی و سرعت بالای استدلال (۴۵.۴ توکن در ثانیه)، این مدل را برای بررسی قراردادها، سنتز پژوهشی یا ممیزی کدهای چندفایلی ایدهآل میکند؛ جایی که باید روی زمینههای بسیار بزرگ بدون نیاز به تکهتکه کردن (Chunking) استدلال کنید.
- دستیارهای کدنویسی با اولویت صحت: خروجی تابع
merge_intervalsدقیق و با توضیح مناسب بود. اما ۶۴.۸ ثانیه برای کمتر از ۶۰۰ توکن، سرعت مناسبی برای جفتبرنامهنویسی (Pair Programming) تعاملی نیست. این مدل بیشتر برای بررسی دستهای کد (Batch Review) یا تحلیلهای فعالشده توسط CI مناسب است تا تکمیل خودکار کد در IDE. - خط لولههای استخراج داده (با احتیاط): خروجی JSON معتبر و دقیق است که برای مرزهای تبدیل OCR به پایگاهداده حیاتی است. اما در سرعت ۴.۹ توکن در ثانیه، خط لولههایی که حساس به توان عملیاتی هستند و هزاران سند را در ساعت پردازش میکنند، باید پیش از استقرار نهایی، این شکل خاص از تکلیف را تست کنند.
کسانی که به دنبال چتهای تعاملی با تأخیر بسیار کم یا لوپهای سریع عامل (Agent) هستند، فعلاً باید از این مدل دوری کنند. نوسان در تأخیر (Latency)، بودجهبندی برای فراخوانی ابزارها (Tool Calls) را سختتر از مدلهایی میکند که سرعت ثابت و پیشبینیپذیری دارند. در این راستا، کاهش ۷۵ درصدی نیاز حافظه برای عاملهای هوش مصنوعی یکی از نقاط قوت این مدل است که میتواند بخشی از این چالشها را تعدیل کند.
تعریف جدید «پرچمدار»
این عرضه سیگنالی از یک الگوی گستردهتر در هوش مصنوعی با وزنهای باز (Open Weights) — یعنی مدلهایی که دستور پختشان علناً منتشر شده — است. واژه «پرچمدار» دیگر به مدل با بیشترین پارامتر اشاره ندارد، بلکه به مدلی میگوید که بهترین نسبت کیفیت به هزینه را ارائه میدهد. این روشنترین درس این فصل است: پرچمدار همیشه نقطه پایان نیست.
دیپسیک با انتشار وزنها در Hugging Face، اجازه میدهد جامعه فنی ادعاهای بهرهوری را بهصورت زنده تأیید کند. این شفافیت، تصمیم داخلی شرکت برای بازنشسته کردن یک مدل بزرگتر به نفع یک مدل چابکتر را برملا میکند. این اتفاق بازتابی از مسیر ۳۰ روزه این سری است که همه چیز، از مدلهای 8B تا مدل ۲.۴ تریلیون پارامتری Qwen3.8-2.4T (در روز ۲۷) را پوشش داد.
در طول این ماه، ما موتورهای استنتاج مختلفی را دیدیم؛ مانند vLLM برای توان عملیاتی، SGLang برای بازاستفاده از پیشوندها (Prefix Reuse) و llama.cpp برای استقرار جهانی. رشته مشترک تمام اینها این بود که وزنهای باز به شما اجازه میدهند ابزار را با محدودیت خود تطبیق دهید؛ خواه این محدودیت یک مرز امنیتی HIPAA باشد، یا چرخه عمر ۱۵ ساله یک خودرو و یا بودجه توان مصرفی یک ماهواره.
در نهایت، V4.1-Flash ثابت کرد که بهرهوری معماری، بهویژه در نحوه مدیریت حافظه کش (Memory Cache)، میتواند بر مقیاس خام غلبه کند. اگر ادعای برتری مدلهای کوچکتر در اقتصاد استقرار درست باشد، سال ۲۰۲۶ سالی است که پرچمدار دیگر به معنای «بزرگترین» نیست، بلکه به معنای «ارزانترین مدل با کیفیت مورد نیاز» است.
اگر در حال ساخت خط لولههای تولیدی هستید، بنچمارک کردن بر اساس حداکثر سرعت را متوقف کنید. شکل خاص تکلیف خود را تست کنید تا ببینید در کدام «لاین سرعت» قرار میگیرید: لاین سریع ۴۵ توکن در ثانیه یا لاین کند ۴.۹ توکن در ثانیه. جایگزینی Pro با Flash درس اصلی این ماجراست: در دنیای هوش مصنوعی وزنباز، جایگزینی مدل کوچک جدید به جای پرچمدار ماه گذشته، دیگر یک مورد استثنایی نیست، بلکه تبدیل به یک الگو شده است.
گام بعدی شما
- اگر خط لولهای برای تحلیل اسناد دارید، مدل را با حجمهای مختلف ورودی تست کنید تا ببینید در کدام «لاین سرعت» (۴.۹ یا ۴۵ توکن) قرار میگیرید.
- برای کارهای استخراج داده، خروجی JSON را با مدلهای کوچکتر مقایسه کنید تا توازن بین دقت و تأخیر را بسنجید.
- بررسی کنید آیا جایگزینی مدلهای Pro با نسخههای Flash در پروژه شما، بدون افت کیفیت، هزینههای API را کاهش میدهد یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو