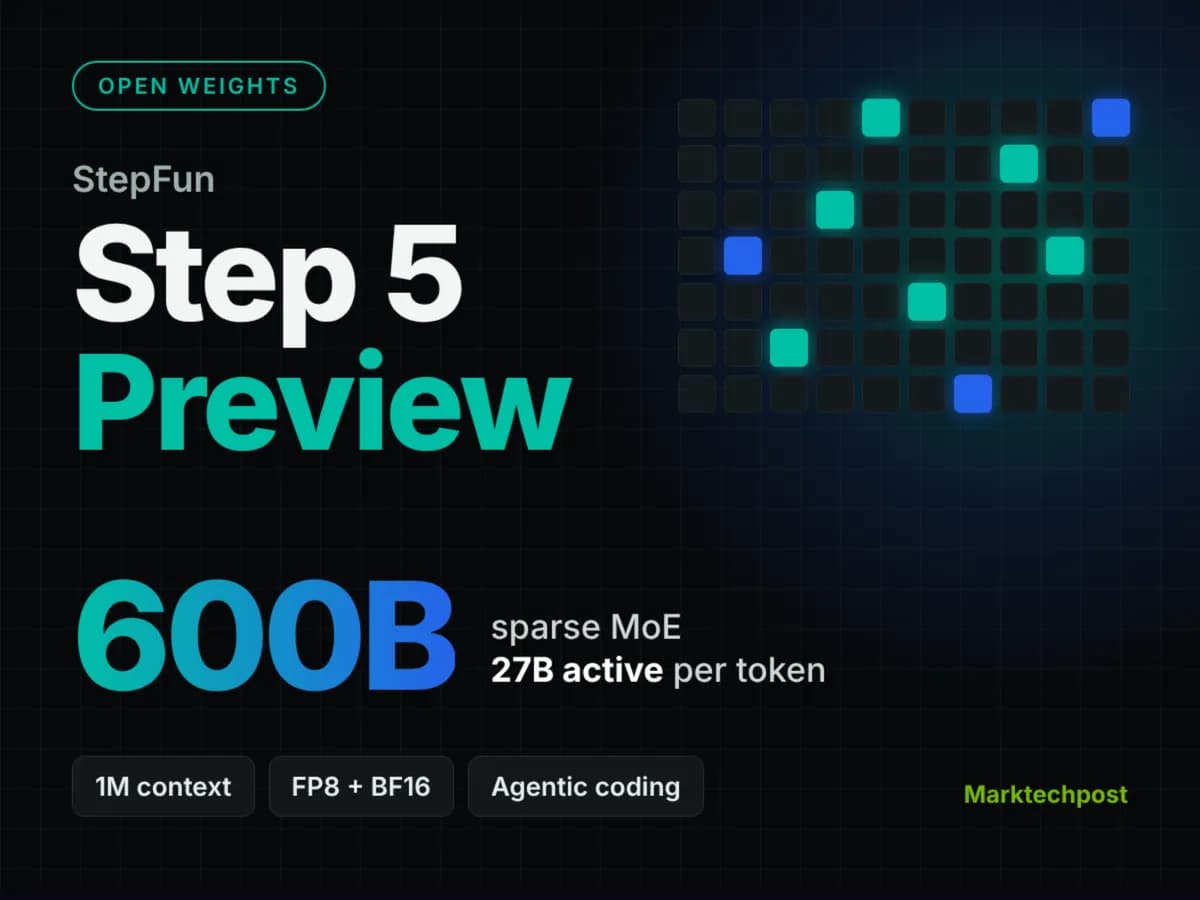
دقت ۸۸.۳ درصدی در استدلالهای متنی بلند، استاندارد جدیدی است که StepFun با آخرین انتشار خود تعریف کرده است. در ۱۴ اکتبر ۲۰۲۶، این شرکت وزنهای باز (Open Weights) مدل Step 5 Preview را منتشر کرد تا پس از عرضهٔ اولیهٔ API در ۲۰ سپتامبر، یک جایگزین قابلمیزبانی شخصی برای تحلیلهای مالی و عاملهای کدنویسی سطح بالا ارائه دهد. این مدل یک معماری ترکیب خبرهها (MoE) با ۶۰۰ میلیارد پارامتر است.
این عرضه در حالی رخ میدهد که صنعت به سمت هوش مصنوعی عاملمحور (Agentic AI) حرکت میکند؛ مدلهایی که تنها به چت کردن اکتفا نمیکنند، بلکه میتوانند در پایگاههای کد پیمایش کرده و نتایج را اصلاح کنند. در حالی که غولهای بستهای مثل GPT-6 Astra و Claude Opus 5 همچنان پیشتاز هستند، Step 5 Preview دقیقاً شکافی را پر میکند که توسعهدهندگان برای دسترسی به قدرت سطح مرکز داده (Data Center) بدون وابستگی به APIهای انحصاری به آن نیاز دارند.
StepFun این مدل پرچمدار را برای کارهای دانشبنیان حرفهای، مهندسی نرمافزار و امور مالی جایگاهسازی کرده است. این مدل بهطور خاص برای هماهنگسازی تغییرات در چندین فایل، اجرای کد و تکرار نتایج طراحی شده است. فراتر از متن، این مدل قادر است نمودارها، اسکرینشاتها و ویدیوها را تحلیل کرده و گزارشهای ساختاریافته تولید کند.
بر اساس مستندات فنی منتشر شده در Hugging Face، این مدل از یک معماری پراکنده استفاده میکند که در آن تنها ۲۷ میلیارد پارامتر به ازای هر توکن فعال میشوند. حضور پررنگ مدلهای چینی در این پلتفرم تصادفی نیست، چرا که بخش بزرگی از ورودیهای محکهای رسمی Hugging Face متعلق به سازمانهای چینی است و این نشاندهنده تسریع در توسعه مدلهای باز در این منطقه است. طراحی مدل «باریک و عمیق» است و از ۹۲ بلوک ترنسفورمر (Transformer) تشکیل شده است. برای مدیریت پنجرهٔ زمینه (Context Window) یک میلیون توکنی، StepFun از یک ترکیب ۳ به ۱ از لایههای توجه (Attention) پنجرهلغز گیتدار و لایههای توجه کامل استفاده کرده است.
مشخصات فنی و عملکرد مدل به شرح زیر است:
- معماری: ۶۰۰ میلیارد پارامتر کل / ۲۷ میلیارد پارامتر فعال به ازای هر توکن.
- زمینه: یک میلیون توکن با استفاده از Sparse GQA (انتخاب ۴,۰۹۶ توکن تاریخچه به ازای هر پرسوجو که در بلوکهای ۸ تایی امتیازدهی میشوند).
- سرعت: استفاده از یک سر MTP-3 برای رمزگشایی گمانهزنانه (Speculative Decoding) که سرعت نهایی را ۳۰٪ افزایش میدهد.
- آموزش: بهرهگیری از دقت ترکیبی (Mixed Precision) FP8 همراه با یادگیری تقویتی (RL) در محیطهای عاملمحور قابلتأیید در مقیاس میلیونی.
- استدلال: کسب امتیاز ۸۸.۳٪ در محک استدلال متون بلند AA-LCR طبق گزارش Artificial Analysis.
- کدنویسی: کسب امتیاز ۶۷.۷ در DeepSWE v1.1 (با تنظیمات temp 1.0 و top_p 0.95) که آن را در ردهای نزدیک به GLM-5.3 (امتیاز ۶۶.۹) و Kimi K3 (امتیاز ۶۷.۵) قرار میدهد.
با این حال، تحلیل دقیقتر نشان میدهد که مدل در حوزههای مختلف نوسان دارد. در حوزه مالی، این مدل با امتیاز ۶۶.۴٪ در FrontierFinance از GLM-5.3 (امتیاز ۶۴.۱٪) و Kimi K3 (امتیاز ۶۲.۶٪) پیشی میگیرد، اما همچنان از Claude Opus 5 با امتیاز ۶۹.۷٪ عقبتر است.
این مدل در وظایف سطح سیستم با چالش روبروست و در Terminal-Bench 4.0 تنها ۳۳.۳٪ امتیاز کسب کرده است که کمتر از امتیاز ۴۱.۹٪ مدل GLM-5.3 است. سایر امتیازات مستقل از Artificial Analysis شامل ۴۳.۷ در شاخص هوش (Intelligence Index)، ۴۶.۵٪ در Humanity’s Last Exam و ۵۴.۳٪ در GDPval-AA است. همچنین نقاط ضعف بحرانی در زمینههای تخصصی دیده میشود؛ از جمله امتیاز نزدیک به صفر (۰.۴٪) در SRE Bench و ۹.۲٪ در محک عامل حقوقی Harvey.
میزبانی این مدل یک چالش سختافزاری عظیم است. تنها نقطهٔ بازرسی (Checkpoint) در حالت FP8 به ۶۵۰.۳۲ گیگابایت VRAM نیاز دارد. برای اجرای آن از طریق vLLM یا SGLang، حداقل به ۴ عدد GPU B300 یا ۸ عدد H200 برای دقت FP8 نیاز است. در حالت BF16، این نیاز به ۸ عدد B300 یا ۱۶ عدد H200 در دو گره (Node) افزایش مییابد.
در سختافزارهای Blackwell، حالتهای موازیسازی خبره از بکاند MegaMoE استفاده میکنند. vLLM و SGLang تصاویر داکر اختصاصی با APIهای سازگار با OpenAI ارائه میدهند. StepFun پیکربندی temperature 1.0، top_p 0.95 و top_k 0 را توصیه میکند.
برای کسانی که API را به میزبانی شخصی ترجیح میدهند، StepFun قیمت هر یک میلیون توکن ورودی را ۱ دلار و خروجی را ۲.۷ دلار تعیین کرده است. هزینه Cache hitها هر یک میلیون توکن ۰.۱۰ دلار است. این قیمتها شامل توکنهای استدلالی است و از خروجی JSON Schema و فراخوانی ابزار در تنظیمات تلاش استدلالی پایین، متوسط و بالا پشتیبانی میکند.
این عرضه با اثبات اینکه معماریهای عظیم ترکیب خبرهها (Mixture of Experts) میتوانند کارایی را حفظ کرده (۲۷ میلیارد پارامتر فعال) و افقهای میلیون-توکنی را مدیریت کنند، معیار مدلهای عاملمحور با وزنهای باز را جابهجا میکند. این اتفاق، صنعت را از مدلهای زبانی عمومی به سمت وزنهای تخصصی «عامل-محور» سوق میدهد که قادر به مدیریت تغییرات چندفایلی در مهندسی نرمافزار هستند.
توسعهدهندگان باید اعتبارسنجی جریان کاری کامل BF16 shard را زیر نظر داشته باشند، زیرا StepFun اشاره کرده که این مسیر هنوز بهطور کامل تأیید نشده است. شما میتوانید وزنهای مدل را در Hugging Face و ModelScope بیابید تا تست روی کدبیس اختصاصی خود را آغاز کنید.
گام بعدی شما
- اگر زیرساخت سختافزاری لازم را دارید، وزنهای مدل را از Hugging Face یا ModelScope دریافت کرده و روی کدبیس اختصاصی خود تست کنید.
- برای کاهش هزینهها، از تنظیمات دقت FP8 و موتورهای vLLM یا SGLang استفاده کنید.
- وضعیت اعتبارسنجی جریان کاری BF16 را دنبال کنید، زیرا StepFun اشاره کرده که این مسیر هنوز بهطور کامل تأیید نشده است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو