۰.۳۶ ثانیه؛ این تمام زمانی است که Superfluid برای پاسخ به یک درخواست چت نیاز دارد، در حالی که یک سرور استاندارد برای همین کار ۱۰ ثانیه زمان میبرد. این سرور متنباز (تحت مجوز Apache-2.0) با رفع گلوگاه اصلی هوش مصنوعی محلی — یعنی ناتوانی موتورهای استنتاج در مدیریت همزمان چندین عامل روی یک لپتاپ بدون منجمد شدن تجربه تعاملی کاربر — عملکرد سیستم را بهطور چشمگیری شتاب بخشیده است.
بیشتر سرورهای استنتاج (Inference) — مثل آشپزی واقعی بعد از یادگیری دستور پخت — برای رکهای عظیم مراکز داده طراحی شدهاند، جایی که تنها معیار مهم، توان عملیاتی (Throughput) است. اما برای کاربری که همزمان یک پایشگر سلامت، یک خلاصهساز ایمیل و یک عامل خرید را روی سیستم خود اجرا میکند، این معماری شکست میخورد. بدون سیستم اولویتبندی، یک سؤال ساده کاربر باید در صف انتظار پشت هر پردازش دستهای (Batch) قرار بگیرد که در حال حاضر در حال اجراست. همانطور که در تحلیلهای قبلی ما درباره ابزارهایی مانند ابزارهای Irene Gray که هدفشان سادهسازی پیکربندیهای LLM است اشاره کردیم، Superfluid اکنون روی لایه اجرایی واقعی پشته هوش مصنوعی محلی تمرکز کرده است.
به نقل از گزارش وبسایت dev.to، این سرور در ۱۳ اکتبر ۲۰۲۶ منتشر شد و بهعنوان یک لایه واحد برای محیطهای مختلف اجرا (Runtimes) عمل میکند. این ابزار از llama.cpp برای مدلهای GGUF، MLX برای تراشههای اپل (Apple Silicon) و موتور BaseRT برای بستههای .base پشتیبانی میکند. این رویکرد محلی در تضاد با مدلهای ابری است؛ برای مثال، استراتژی جدید Cloudflare برای میزبانی Llama 3 بر پایه مدلهای Serverless و پرداخت بهازای مصرف استوار است.
آیندهای عاملمحور
آینده هوش مصنوعی محلی، عاملمحور (Agentic) است. این یعنی دستگاهی که بتواند همزمان چندین عامل را میزبانی کند؛ مثلاً عاملی که شبها ایمیلها را خلاصه کند، عاملی که دادههای سلامتی را زیر نظر بگیرد و عاملی که خریدها را مدیریت کند، در حالی که کاربر در فواصل زمانی مختلف میتواند به چت کردن و پرسیدن سؤالات خود ادامه دهد.
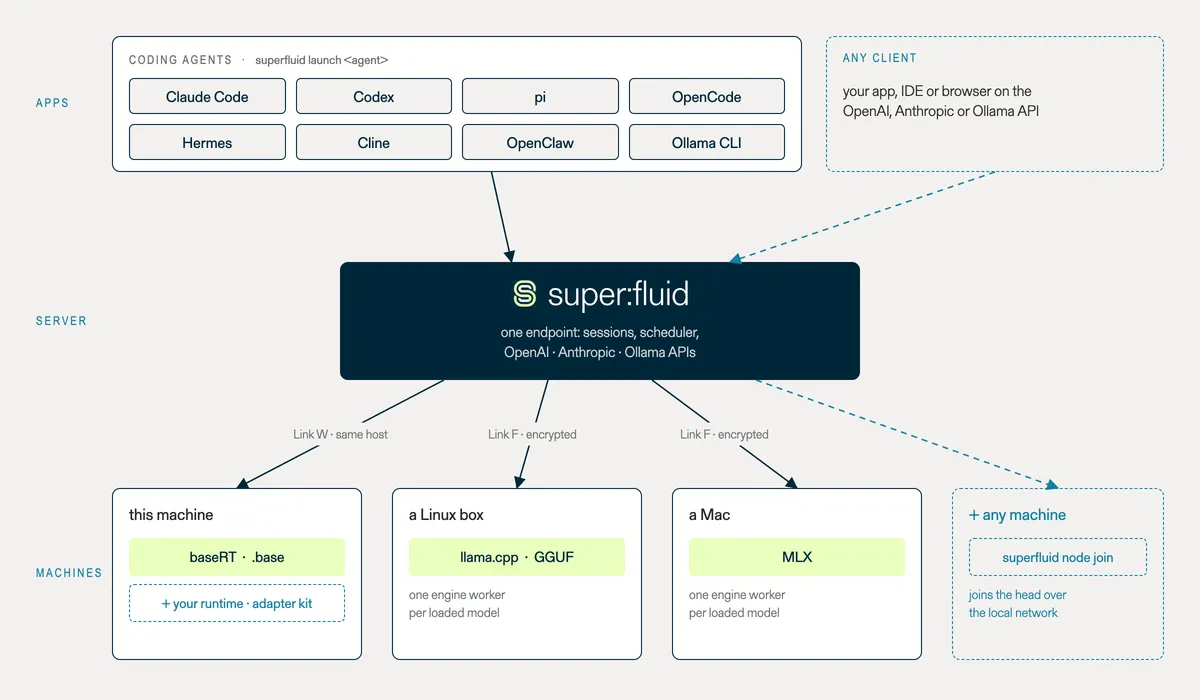
Superfluid یک سرور واحد برای هر محیط اجرا فراهم میکند. این ابزار قابلیتهای یکسانی از جمله APIها، فراخوانی ابزار (Tool Calling)، خروجی ساختاریافته (Structured Output) و قالبهای چت را به llama.cpp، MLX و BaseRT میآورد. این موضوع به کاربران اجازه میدهد عاملهای کدنویسی را از طریق دستور superfluid launch برای ابزارهایی مثل Claude Code، Codex، pi، OpenCode، Hermes Agent، Cline، OpenClaw یا حتی رابط خط فرمان (CLI) مدل Ollama اجرا کنند.
قابلیتهای فنی
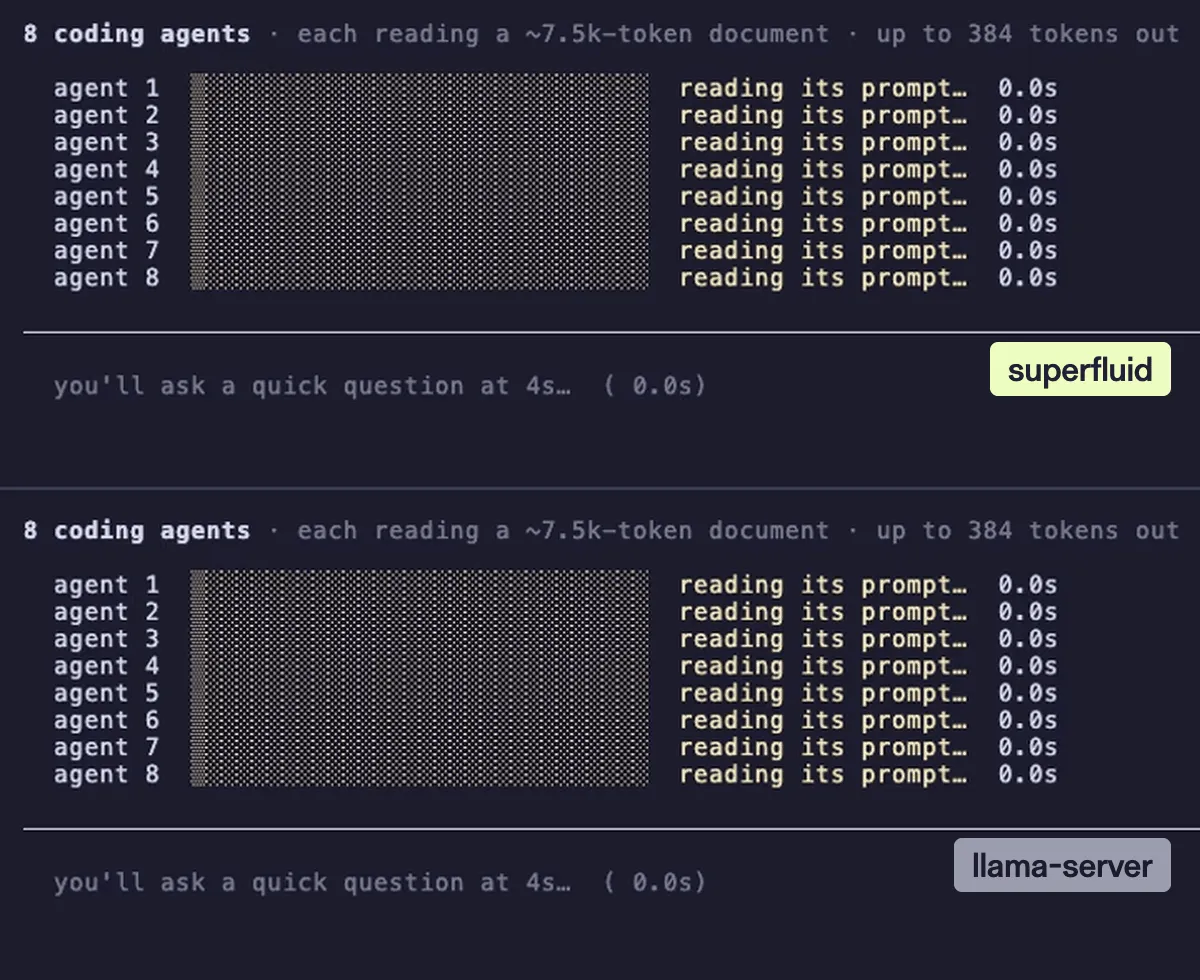
- زمانبندی پیشدستانه (Preemptive Scheduling): درخواستهای تعاملی در اولین تیکِ زمانبند (Scheduler Tick) به ابتدای صف میپرند. بنابراین چت شما پشت یک عامل پسزمینه که در حال پردازش سندی با ۷۵۰۰ توکن است، گیر نمیکند و پاسخ سریعاً دریافت میشود.
- پایداری نشستها (Session Persistence): هر توکن (Token) — تکههای کوچکی از متن شبیه برشهای کیک — قبل از نمایش در یک لاگ ثبت میشود. اگر یک Worker کرش کند یا سرور ریاستارت شود، نشستها دقیقاً از همان نقطهای که متوقف شده بودند، ادامه مییابند. در حالی که در محیطهای ابری، درگاههای LLM تلاش کردهاند تا هزینه این توکنها را تا ۸۰٪ کاهش دهند، Superfluid با محلیسازی کامل، هزینه توکن را به صفر میرساند.
- بهینهسازی پرامپت: پرامپت سیستمی (System Prompt) مشترک تنها یکبار محاسبه میشود. برای ۳۲ درخواست که از یک پرامپت سیستمی یکسان استفاده میکنند، سیستم تنها هزینه یکبار پیشپُرکردن (Prefill) را پرداخت میکند.
- سازگاری با API: این سرور از APIهای OpenAI، Anthropic و Ollama پشتیبانی میکند. کاربران میتوانند کلاینتهای OpenAI خود را بدون نیاز به هیچگونه کلید API به آدرس
http://127.0.0.1:8453/v1متصل کنند.
مقیاسپذیری چنددستگاهی
Superfluid به کاربران اجازه میدهد چندین ماشین را به یک ابر خصوصی تبدیل کنند. با تعیین یک ماشین بهعنوان سرور اصلی (Head Server) و سایرین بهعنوان گره (Node) از طریق یک لینک رمزنگاریشده، سیستم میتواند نشستهای کامل را در سراسر شبکه توزیع کند.
کاربران ابتدا یک توکن روی سرور اصلی ایجاد میکنند و سپس با استفاده از دستور --fleet-listen یک شنونده برای گرهها فعال میکنند. گرهها به شبکه میپیوندند، مدل را دریافت کرده و آن را روی لینک رمزنگاریشده سرویسدهی میکنند. در این معماری، تنها توکنهای نمونهبرداریشده (Sampled Tokens) به سرور اصلی بازمیگردند. اگر گرهی در میانهی استریم از کار بیفتد، سرور اصلی بهطور خودکار نشست را جایگزین میکند تا اطمینان حاصل شود که هیچ توکنی دوبار تحویل داده نمیشود. نکته قابل توجه این است که گرهها میتوانند برای یک مدل واحد، از محیطهای اجرای متفاوتی استفاده کنند؛ مثلاً اجرای BaseRT روی یک مک در کنار llama.cpp روی یک سیستم لینوکسی.
محکهای عملکرد
بر اساس مستندات فنی، در تستهای رودررو روی Apple M5 Pro با استفاده از مدل Qwen3.8-27B (۴ بیتی)، زمان تا نخستین توکن (TTFT) برای یک درخواست چت در حالی که ۸ عامل فعال در پسزمینه بودند، ۱.۵ ثانیه ثبت شد. در مقابل، Ollama به ۳۸۰ ثانیه، llama-server به ۲۹۱ ثانیه و mlx_lm.server به ۶۱۲ ثانیه زمان نیاز داشتند.
سایر معیارهای کلیدی عبارتاند از:
- نرخ برخورد حافظه پنهان (Cache Hits): برای ۳۲ درخواست که یک پرامپت ۴ هزار توکنی مشترک داشتند، Superfluid و llama-server به نرخ ۹۷٪ رسیدند، در حالی که mlx_lm.server نرخ ۰٪ را ثبت کرد.
- بازیابی: پس از توقف اجباری (Kill) یک Worker در میانهی استریم، Superfluid سرویس را در ۱.۸ ثانیه بازیابی کرد.
- توان عملیاتی: در حالت یک درخواست و همچنین هشت درخواست همزمان، Superfluid با تعداد توکن در ثانیهی llama-server برابری میکند. همچنین، این ابزار درخواستهای MLX را بسیار بهینهتر از mlx_lm.server دستهبندی (Batch) میکند، چرا که mlx_lm.server درخواستها را یکییکی پردازش میکند.
این تغییر، این فرض قدیمی را که هوش مصنوعی محلی تنها به یک وظیفه در هر لحظه محدود است، میشکند. Superfluid با تبدیل استنتاج محلی به یک محیط چندمستأجری (Multi-tenant) به جای یک لوله تکجریانی، «لپتاپ عاملمحور» را به یک واقعیت کاربردی تبدیل میکند. کاربران دیگر مجبور نیستند بین اتوماسیون پسزمینه و یک رابط چت پاسخگو، یکی را انتخاب کنند.
گام بعدی شما
- توسعهدهندگان میتوانند سرور را از طریق اسکریپت
curl -fsSL https://superfluid.sh/install.sh | shیا از طریق Cargo نصب کنند. - کلاینتهای سازگار با OpenAI را به آدرس
http://127.0.0.1:8453/v1متصل کنید تا سرعت پاسخدهی را تست کنید. - برای کسانی که سختافزار محدود دارند، ترکیب گرههای لینوکسی و مک برای توزیع بار محاسباتی را امتحان کنید.
اما مرز بعدی، مشاهده این موضوع خواهد بود که معماری گرههای توزیعشده چگونه با تأخیر (Latency) در شبکههای خانگی ناهمگون مقابله میکند — در گزارش بعدی بررسی خواهیم کرد که این سیستم چگونه با نوسانات شبکه برخورد میکند.



گفتگو