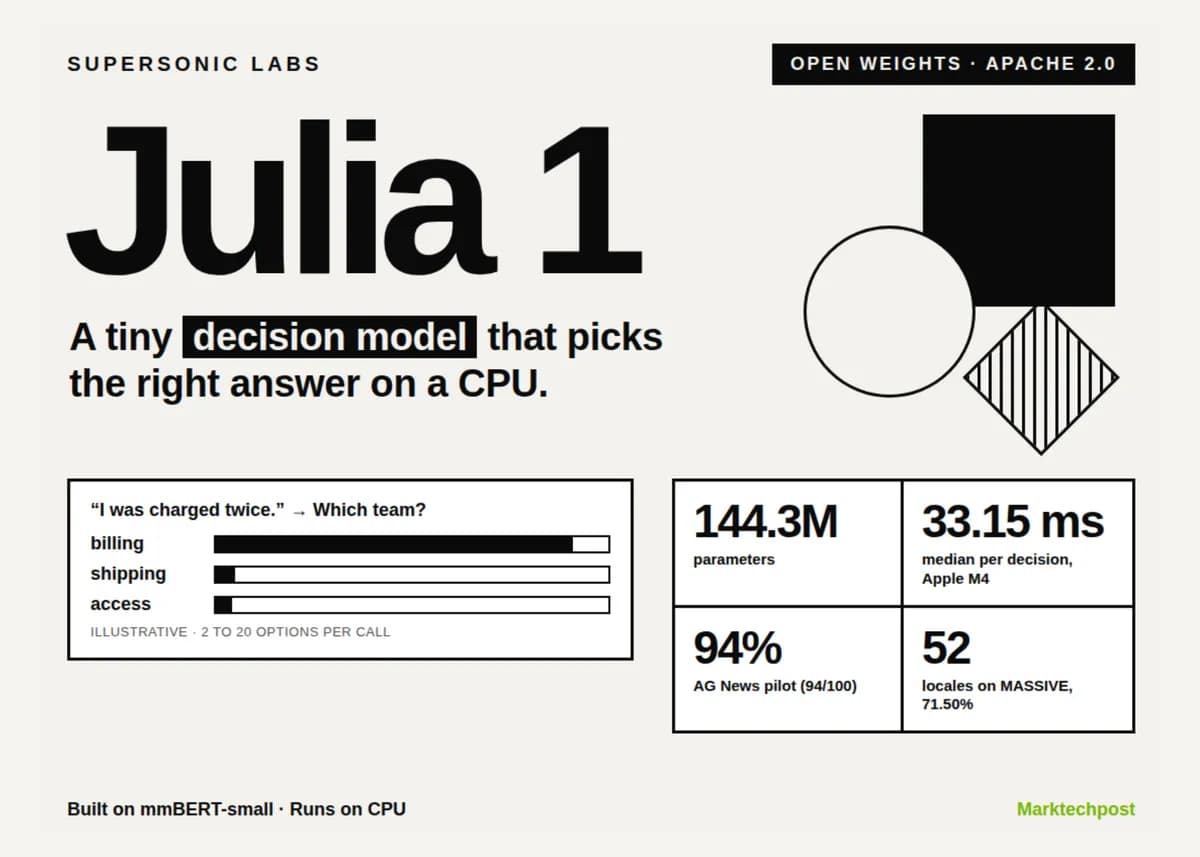
۱۴۴.۳ میلیون پارامتر؛ این تمام چیزی است که Julia 1 برای اجرای وظایف پیچیدهٔ طبقهبندی روی یک CPU استاندارد نیاز دارد. این مدل تصمیمگیرنده که توسط Supersonic Labs (آزمایشگاهی مستقر در برزیل) منتشر شده، این فرض رایج را که مسیریابی (Routing) با دقت بالا نیازمند مدلهای زبانی بزرگ است، به چالش میکشد. تمرکز این مدل بهطور خاص بر انتخاب از میان پاسخهای کاندید است، نه تولید متن آزاد.
بسیاری از استقرارهای فعلی هوش مصنوعی به خوشههای سنگین GPU یا APIهای ابری متکی هستند که باعث افزایش تأخیر و ریسکهای حریم خصوصی میشوند. Julia 1 بهعنوان یک ابزار تخصصی برای توسعهدهندگانی وارد بازار شده که به یک «سر تصمیمگیرنده» نیاز دارند؛ مدلی که بستر و سؤال را دریافت کرده و احتمال وقوع ۲ تا ۲۰ گزینهٔ مشخص را برمیگرداند. این معماری اجازه میدهد مدل بدون سربار یک ترنسفورمر (Transformer) مولد کامل، بهعنوان یک مسیریاب یا طبقهبندیکننده با سرعت بالا عمل کند.
همانطور که در تحلیلهای پیشین ما دربارهی مدلهای زبانی کوچک (SLM) اشاره کردیم، تمایل صنعت به سمت مدلهای تخصصی با مصرف انرژی کمتر در حال افزایش است.
زمینه و قابلیتها
برخلاف یک چتبات, Julia 1 یک مدل تصمیمگیرنده فشرده است و متن تولید نمیکند. در عوض، این مدل سه نوع تصمیمگیری خاص را از طریق یک API واحد مدیریت میکند:
- انتخاب (Choice): برگزیدن یک برچسب از بین ۲ تا ۲۰ گزینه توصیفشده برای طبقهبندی یا مسیریابی.
- امتیاز (Score): بازگرداندن شاخص مورد انتظار در یک معیار مرتبشده (مثلاً کم، متوسط، زیاد).
- نول (Noul): محاسبه احتمال درست بودن یک گزاره بله/خیر.
نتایج در ترتیب اصلی گزینههای ارسالی توسط کاربر و با احتمالات کامل softmax بازگردانده میشوند. همچنین شناسههای کاربر، مانند شناسههای صورتحساب، بدون تغییر بازگردانده میشوند.
به نقل از گزارش فنی marktechpost.com، مدل Julia 1 بر پایه انکودر mmBERT-small از JHU CLSP ساخته شده که از بیش از ۱۸۰۰ زبان پشتیبانی میکند. این آزمایشگاه با حفظ انکودر و توکنساز (Tokenizer)، یک لایه تصمیمگیرنده اختصاصی اضافه کرده و مدل را روی نمونههای فرمتبندیشده آموزش داده است. سازندگان صراحتاً تأکید کردهاند که Julia 1 یک مدل تنظیمشده (Fine-tuned) از Qwen نیست. جالب اینجاست که کل هزینه پردازشی ابری برای آموزش و آزمایشهای این مدل تنها ۱۰۴.۰۸ دلار (معادل ۵۴۰ رئال برزیل) بوده است.
جزئیات فنی و استقرار
مشخصات فنی و استقرار مدل به شرح زیر است:
- تعداد پارامترها: ۱۴۴.۳ میلیون
- پروانه: Apache 2.0 (وزنهای باز در Hugging Face)
- محیط اجرا: پایتون ۳.۱۱ به بالا روی CPU یا GPUهای BF16؛ نسخه ONNX برای اجرا در مرورگر (WebGPU) در دسترس است
- پنجره زمینه (Context Window): پشتیبانی تا ۸۱۹۲ توکن ترکیبی (اگرچه در بنچمارکها از محدودیت ۱۰۲۴ توکن استفاده شد)
- اشغال حافظه: وزنهای FP32 حدود ۵۵۰.۵ مگابایت (MiB) فضا میگیرند
- API: یک API میزبانیشده معرفی شده است که قیمت برنامهریزی شده برای آن ۰.۰۲۵ دلار به ازای هر ۱ میلیون توکن است، هرچند هنوز در دسترس عموم قرار نگرفته است. این رویکرد در ارائه APIهای تخصصی، یادآور تلاشهایی است که برای بهینهسازی تجربه توسعهدهندگان صورت میگیرد، مشابه آنچه AIWave برای حل مشکل «صفر کاذب» در جذب توسعهدهندگان به کار گرفت.
بنچمارکهای عملکرد
در ارزیابیهای ۲۴ سپتامبر ۲۰۲۶، که با استفاده از H200 BF16 و رمزگذاری سختگیرانه انجام شد، Julia 1 نتایج متفاوتی در برابر مرجع TypeSafe Jev نشان داد. این مدل در طبقهبندیهای Typed امتیاز ۷۳.۱۵٪ (۱۴۶۳ از ۲۰۰۰) را کسب کرد، در حالی که مرجع Jev امتیاز ۷۲.۷۰٪ داشت. همچنین در بنچمارک AG News (۴ برچسب) نمره ۹۴/۱۰۰ و در DAIR Emotion (۶ برچسب) نمره ۸۶/۱۰۰ را به دست آورد که در مورد دوم، بهطور قابلتوجهی از امتیاز ۴۸ درصدی Jev پیشی گرفت.
با این حال، مدل در وظایفی با تعداد برچسب بالا (High-cardinality) دچار مشکل شد؛ بهطوری که در مجموعه داده Banking77 با ۷۲ برچسب، تنها ۶۴/۱۰۰ امتیاز گرفت، در حالی که Jev در این بخش ۸۷٪ بود. در بنچمارک MASSIVE روی ۵۲ منطقه زبانی، صحت کلی (Macro Accuracy) مدل ۷۱.۵۰٪ بود که در زبانهای انگلیسی (en-US) با ۸۶.۷۵٪ و پرتغالی (pt-PT) با ۸۶.۲۵٪ نقاط قوت مشخصی داشت. یک اجرای مجدد روی CPU در ۲۵ سپتامبر، بیشتر اعداد را تأیید کرد، هرچند امتیاز Banking77 با ۳ مورد عدم پاسخ (Abstentions) به ۶۰/۱۰۰ کاهش یافت. این تفاوت در نتایج بنچمارکها تأکیدی است بر اینکه بسیاری از رتبهبندیهای درگاههای هوش مصنوعی بیشتر جنبه بازاریابی دارند تا معیاری دقیق برای سنجش عملکرد واقعی.
تأخیر در دستگاه (On-Device Latency)
اندازهگیریهای تأخیر (Latency) کارایی این مدل را برای رایانش لبه (Edge Computing) برجسته میکند:
- Apple M4: میانگین ۳۳.۱۵ میلیثانیه برای هر تصمیم.
- تبلت سامسونگ SM-X510: میانگین ۲۰۳ میلیثانیه از طریق ONNX Runtime (با اوج مصرف حافظه RSS برابر ۳۹۳.۱ مگابایت).
- Intel Core i5-1235U: میانگین ۱۰۷.۸۳ میلیثانیه برای AG News.
در لپتاپ i5، زمان پاسخدهی برای Banking77 به ۳۷۱۳.۵۴ میلیثانیه افزایش یافت، زیرا مدل باید ابتدا ۷۲ برچسب را فیلتر و محدود کند. توسعهدهندگان باید ادعای «۵ برابر سریعتر بودن» Julia 1 نسبت به Jev را با احتیاط بپذیرند، زیرا آزمایشگاه اجراهای محلی CPU را با یک سرویس ابری که از فرانسه فراخوانی شده بود مقایسه کرده است و این مقایسه تأخیر، معادل و عادلانه نیست.
برای جامعه فنی، Julia 1 معیار «اندازه کافی» برای مدلهای مسیریاب را جابهجا میکند و ثابت میکند یک انکودر زیر ۲۰۰ میلیون پارامتر میتواند در دامنههای محدود طبقهبندی، از سیستمهای تجاری بزرگتر پیشی بگیرد. شکست در تست Banking77 نشان میدهد که با افزایش تعداد گزینهها، مکانیزم مسیریاب ممکن است برچسبهای درست را حذف کند.
به دلیل ماهیت مقایسهای پاسخهای ارائه شده، این مدل برای جبر، محاسبات چندمرحلهای یا استخراج حقایق گمشده مناسب نیست. Supersonic Labs توصیه میکند برای تصمیمات حساس و پیامددار، نظارت انسانی حفظ شود. در آینده منتظر انتشار Julia 2 باشید که از معماری بنیادین اختصاصی این آزمایشگاه بهره خواهد برد.
گام بعدی شما
- اگر در حال توسعه سیستمهای مسیریابی (Router) برای عاملهای هوش مصنوعی هستید، وزنهای Julia 1 را از Hugging Face دریافت کرده و روی CPU تست کنید.
- برای کاهش هزینههای استنتاج در طبقهبندیهای ساده، جایگزینی مدلهای زبانی بزرگ با این مدل تصمیمگیرنده را بررسی کنید.
- محدودیت مدل در تعداد برچسبهای بالا (High-cardinality) را در طراحی معماری سیستم خود لحاظ کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو