آیا یک دستیار صوتی میتواند همزمان که فکر میکند، بدون یخ زدن، واقعاً گوش دهد؟ تیم پژوهشی تنسنت (Tencent)، شامل تیم Hunyuan Speech و محققان دانشگاهی، با معرفی Gander به این پرسش پاسخ دادند؛ مدلی که سیالیت گفتگو را از اجرای وظایف پسزمینه تفکیک میکند.
بیشتر دستیاران صوتی فعلی بر اساس نوبتدهی (turn-taking) عمل میکنند و وقتی کاربر سعی میکند حرف آنها را قطع کند یا بازخورد سریع بدهد، تجربهای تکاندهنده و غیرطبیعی ایجاد میشود. در گفتگوهای واقعی، انسانها یکدیگر را قطع میکنند و همزمان با صحبت کردن، گوش میدهند. این محدودیت به این دلیل است که یک مدل واحد معمولاً باید بین سرعت مورد نیاز برای گفتار و استدلال عمیق برای کارهایی مثل کدنویسی یا جستوجوی فایل، تعادل برقرار کند.
زمینه و معماری
مدل Gander بهگونهای طراحی شده است که گفتگوهای بلادرنگ را مدیریت کند و همزمان وظایف پسزمینه، مانند رفع یک باگ یا انتظار برای نمایش یک اسلاید خاص را پیش ببرد. این مدل ورودیهای صوتی، تصویری و متنی را بهطور همزمان دریافت میکند و به همین دلیل میتواند بدون نیاز به دستور کاربر، سوالات تکمیلی بپرسد یا گزارش پیشرفت کار را ارائه دهد.
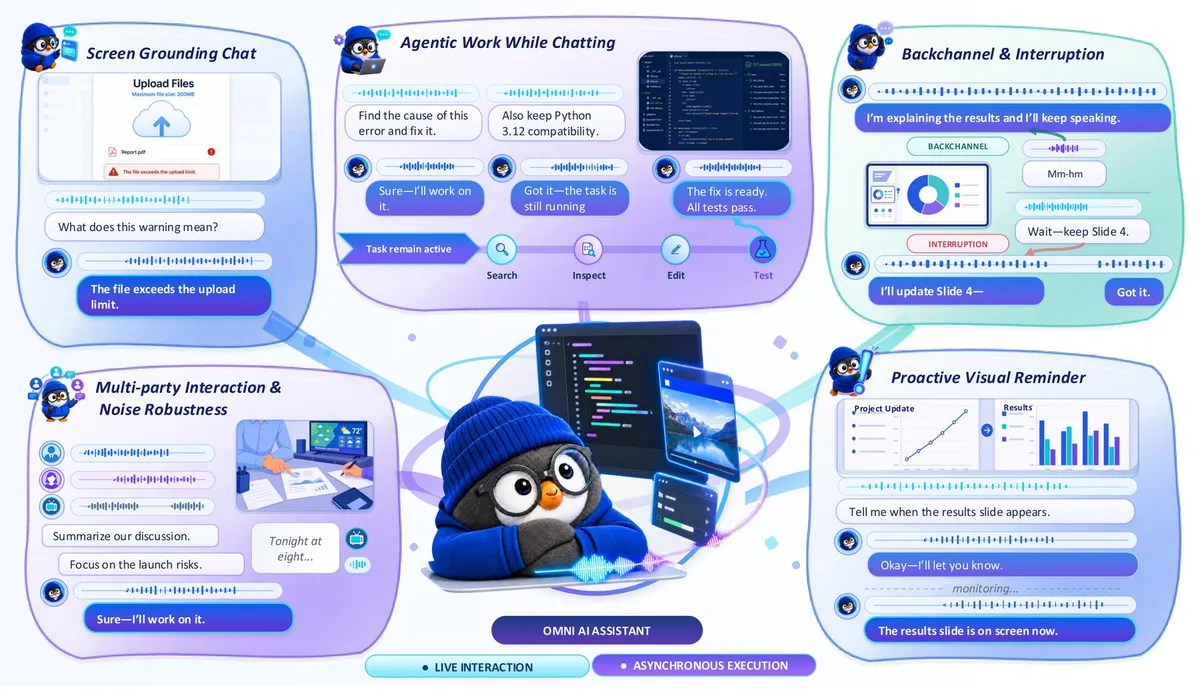
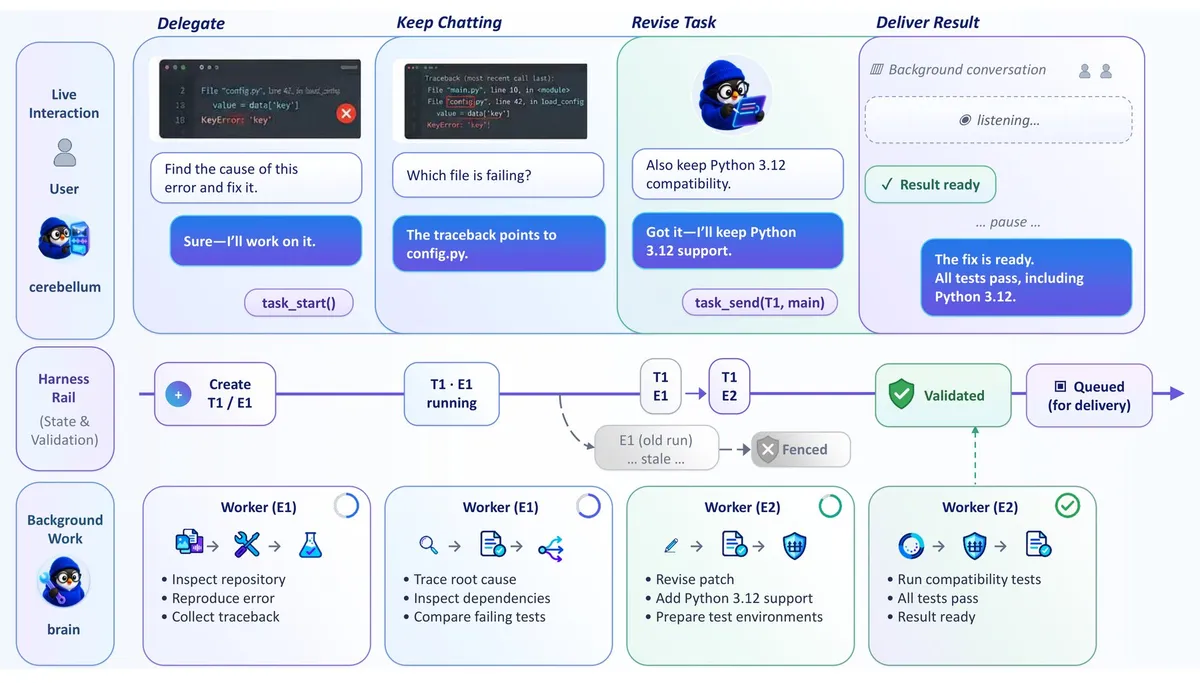
برای حل تضاد بین سرعت و استدلال، Gander از یک استعاره بیولوژیکی استفاده کرده و معماری خود را به «مخچه» و «مغز» تقسیم کرده است:
- مخچه: مدیریت گفتگوهای بلادرنگ با تأخیر (Latency) پایین.
- مغز: مدیریت استدلالهای پیچیده و وظایف عامل (Agent) در پسزمینه.
همانطور که در تحلیلهای پیشین ما دربارهی ارکستراسیون مدلها اشاره کردیم، این ساختار ماژولار اجازه میدهد «مغز» بدون نیاز به آموزش مجدد لایهی گفتگو، با سیستمهای دیگر مثل Claude Code یا Codex جایگزین شود. طبق گزارش فنی، در آزمایشها از مدلی از خانواده GPT-5.6 شرکت OpenAI برای این نقش استفاده شده است. این یعنی با بهبود مدل مغز، کل سیستم ارتقا مییابد؛ مثلاً در حالی که عامل پسزمینه در حال رفع یک باگ است، کاربر میتواند به صحبت ادامه دهد تا سازگاری با Python 3.12 را به وظیفه اضافه کند.
بر اساس مستندات فنی، Gander گفتگوها را به قطعات یکثانیهای تقسیم میکند. این سازوکار به مخچه اجازه میدهد بر اساس حافظه دو دقیقهای گفتگو، فوراً تصمیم بگیرد که گوش دهد، صحبت کند یا سکوت کند، بدون اینکه به ماژول جداگانهای برای تشخیص شروع و پایان گفتار نیاز داشته باشد.
عملکرد و موازنه
در تستهای رودررو در محک Full-Duplex-Bench v3، که دستیاران صوتی را در سناریوهای مختلف وظایف میسنجد، مدل Gander در مقایسه با رقبایی چون Gemini Live و Grok برتری چشمگیری در زمانبندی نشان داد. این رقابت در حالی صورت میگیرد که گوگل پیشتر با ارتقای مدلهای صوتی Gemini 3.8 توانسته بود کیفیت گفتار را به امتیاز ۸۲.۶ برساند.
- دقت زمانبندی: در ۱۰۰٪ سناریوهای تست شده، در لحظه درست شروع به صحبت کرد.
- نرخ قطع کردن: تنها در ۸٪ موارد کاربر را قطع کرد که بهطور قابلتوجهی کمتر از GPT-Realtime (۱۳.۵٪) و ضعیفترین رقیب (نزدیک به ۴۸٪) بود.
- صحت وظایف: با وجود برتری در زمانبندی، صحت (Accuracy) کلی اجرای وظایف در این مدل کمی پایینتر از ضعیفترین رقیب گروه بود.
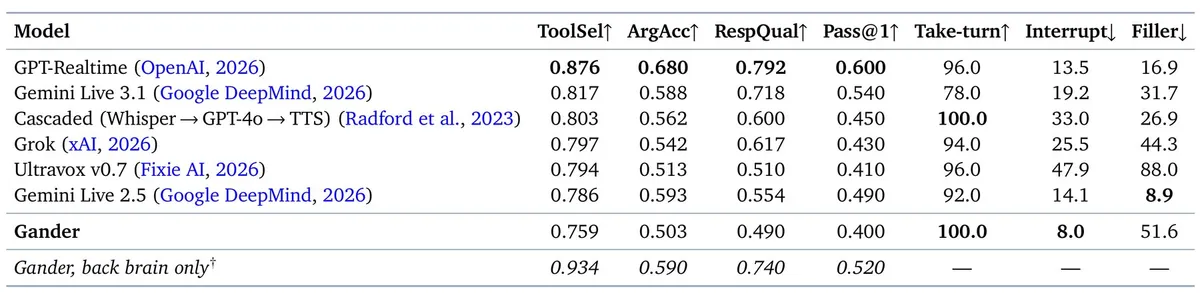
محققان این افت دقت را به نحوه امتیازدهی بنچمارک نسبت میدهند که کل سیستم را میسنجد؛ یعنی خطاهای بازشناسی گفتار و خروجی، نمره نهایی را کاهش میدهند. وقتی به «مغز» ورودی متنی مستقیم داده شد، عملکرد آن بهطور قابلتوجهی بهبود یافت. با این حال، تیم سازنده اشاره کرد که آموزش برای گفتگوی سیال، به قیمت کاهش دقت ادراکی تمام شده است؛ بهطوری که Gander در تستهای شمارش اشیا یا مکانیابی آنها در تصویر، ضعیفتر از مدل پایه عمل کرد.
روندهای صنعت و متنباز
این چرخش معماری نشاندهنده روند گستردهتر صنعت به سمت ارکستراسیون مدلها است. GPT-Live شرکت OpenAI نیز بهطور مشابه گفتگو را از استدلال جدا کرده و جستوجوهای وب را به یک مدل پسزمینه میسپارد. همچنین Fugu از شرکت Sakana AI از مجموعهای گسترده از مدلهای تخصصی استفاده میکند. علاوه بر این، OpenAI در حال آزمایش عاملهای پیشکنشی (Proactive Agents) است که بدون درخواست کاربر، با آنها تماس میگیرند.
تنسنت با انتشار مدل باز Hy3 در ماه جولای که در WorkBuddy، Yuanbao و WeChat استفاده میشود، روی آینده عاملمحور (Agentic) سرمایهگذاری کرده است. همچنین گزارش شده که این شرکت پس از آنکه پکن تصاحب متا (Meta) را مسدود کرد، در حال مذاکره برای تصاحب سهم بزرگی از استارتاپ Manus است تا عاملهای هوشمند را در دل ویچت جای دهد.
برای جامعه فنی، دستاورد اصلی Gander اثبات این نکته است که یک مدل نسبتاً کوچک میتواند در تأخیر تعامل، سیستمهای تجاری عظیم را شکست دهد. این موازنه نشان میدهد که مرز بعدی، مسیریابی بهینه بین ماژولهای تفکر «سریع» و «کند» است.
تنسنت قصد دارد وزنهای باز (Open Weights) و دادههای آموزشی این مدل را که بر اساس ۲.۷ میلیون نمونه است، منتشر کند. برخی از این نمونهها به مدل میآموزند که در حضور نویزهای پسزمینه سکوت کند. توسعهدهندگان هماکنون میتوانند از طریق مخزن گیتهاب به کد دسترسی داشته باشند.
گام بعدی شما
- بررسی مخزن گیتهاب Gander برای درک نحوه پیادهسازی تفکیک لایهی گفتگو و استدلال.
- تحلیل موازنه بین Latency و Accuracy در مدلهای صوتی برای بهینهسازی تجربه کاربر در محصولات خود.
- دنبال کردن انتشار وزنهای باز مدل برای تست روی سختافزارهای لبه.
اما چالش اصلی در این مسیر، مدیریت حافظه در مدلهای کوچک است — به تحلیل ما دربارهی بهینهسازی KV Cache مراجعه کنید.



گفتگو