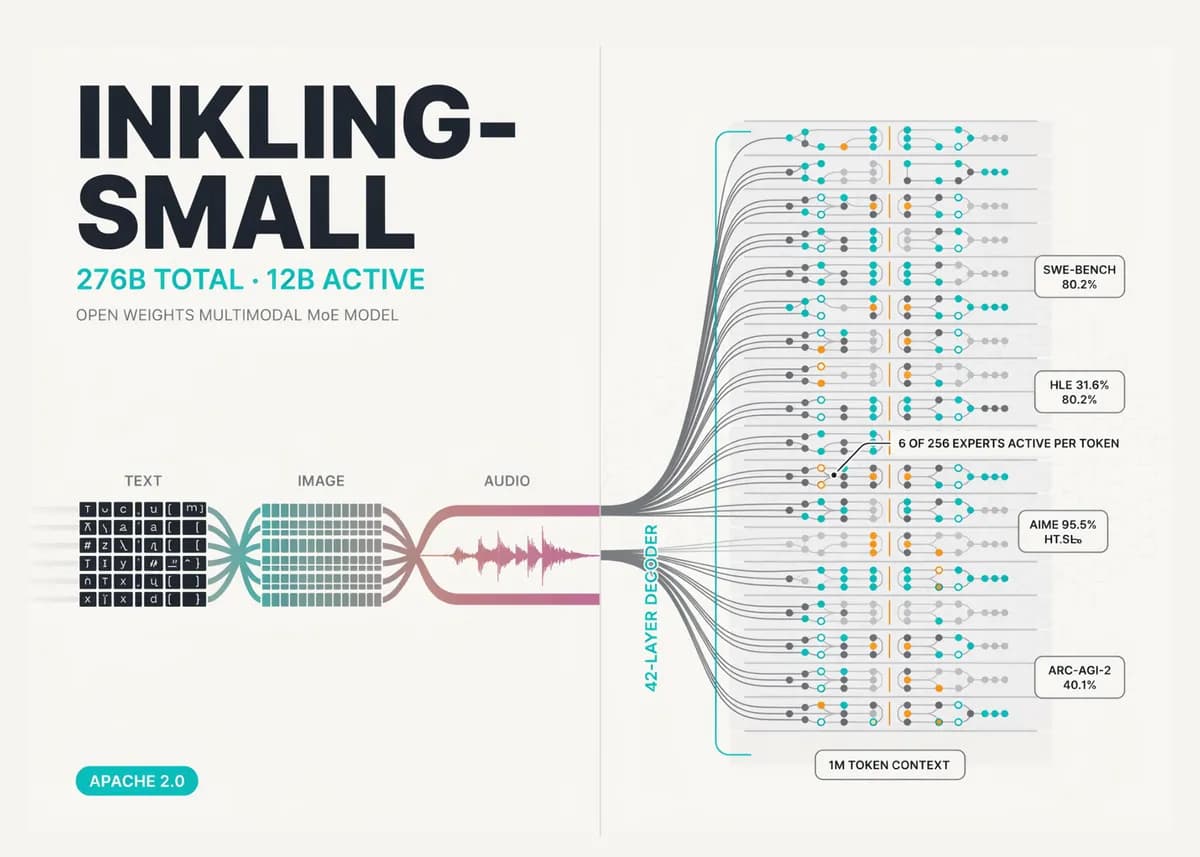
آیا یک مدل با ۲۷۶ میلیارد پارامتر میتواند در کدنویسی عاملمحور و استدلالهای پیچیده، معلم ۹۷۵ میلیارد پارامتری خود را شکست دهد؟ آزمایشگاه Thinking Machines با عرضه مدل Inkling-Small ثابت کرد که پاسخ مثبت است. این مدل یک مدل با وزنهای باز از نوع «ترکیب خبرهها» (Mixture-of-Experts یا MoE) است که نشان میدهد چگونه تقطیر هوشمندانه و یادگیری تقویتی (RL) متمرکز در مرحله پسآموزش میتواند قوانین سنتی مقیاسپذیری را به چالش بکشد.
این عرضه در زمانی رخ میدهد که صنعت از مدلهای یکپارچه و غولآسا به سمت معماریهای MoE کارآمد حرکت میکند. در حالی که مدل اصلی Inkling استانداردهای بالایی برای قابلیتها تعیین کرده بود، سختافزار مورد نیاز برای اجرای چنین غولی برای اکثر استارتآپها یک مانع بزرگ بود. این مدل پیشتر نیز توجهات را جلب کرده بود، بهطوری که میرا موراتی اشاره کرد Inkling در عملیاتهای عاملمحور از رقبای داخلی پیشی گرفته است. مدل اصلی Inkling دارای ۹۷۵ میلیارد پارامتر کل و ۴۱ میلیارد پارامتر فعال است. مدل Inkling-Small این مشکل را با فعالسازی تنها ۱۲ میلیارد پارامتر بهازای هر توکن حل کرده است که سقف هزینههای استنتاج را برای استفادههای تولیدی بهشدت پایین میآورد.
طبق گزارش وبسایت marktechpost.com، این مدل روی سیستمهای NVIDIA GB300 NVL72 آموزش دیده و تحت مجوز Apache 2.0 در پلتفرم Hugging Face منتشر شده است. معماری فنی آن شامل یک ترنسفورمر ۴۲ لایهای تنها-رمزگشا (decoder-only) با بدنه MoE پراکنده است. در این ساختار، هر توکن به ۶ خبره از مجموع ۲۵۶ خبره هدایت میشود و علاوه بر آنها، ۲ خبره مشترک وجود دارند که برای هر توکن فعال هستند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، دسترسی به وزنها برای سازمانها حیاتی است. Inkling-Small با ارائه وزنهای باز (Open Weights)، این امکان را فراهم میکند تا بدون وابستگی به APIهای ابری، مدل روی زیرساختهای خصوصی مستقر شود.
جزئیات معماری
- مدیریت ورودی: مدل بدون رمزگذار (encoder-free) و بهصورت بومی چندوجهی (Multimodal) است. تصاویر به تکههای ۴۰ در ۴۰ پیکسلی تقسیم شده و از طریق یک hMLP چهارلایه تبدیل میشوند. صداها نیز بهصورت طیفنگاشتهای dMel نمایش داده میشوند. هر دو ورودی از یک لایه جاسازی (embedding) سبک عبور میکنند تا بتوانند بهطور مشترک با توکنهای متنی پردازش شوند.
- مشخصات صوتی: ورودیهای صوتی WAV با نرخ ۱۶ کیلوهرتز پشتیبانی میشوند و ایدهآل است که مدتزمان آنها زیر دو دقیقه باشد. با این حال، خروجی مدل همچنان تنها متنی است.
- توجه و محاسبات: مدل از ترکیبی از لایههای توجه محلی (local) و جهانی (global) استفاده میکند. پشتیبانی عددی آن شامل BF16، MXFP8 و NVFP4 است.
- مسیر آموزش: آموزش این مدل پس از مدل بزرگتر آغاز شد تا محققان بتوانند ترکیب دادههای پیشآموزش و دستورالعمل ML را بازنگری کنند. یک نقطه بازرسی «پیشنمایش» اولیه با استفاده از تقطیر on-policy با مدل Inkling بهعنوان معلم آموزش دید و پس از آن، دو هفته یادگیری تقویتی (RL) مقیاسشده در زمینه کدنویسی عاملمحور را پشت سر گذاشت.
مشخصات فنی و سختافزار
- پنجره زمینه: ۱ میلیون توکن با قابلیت تنظیم میزان تلاش برای تفکر (thinking effort).
- نیازمندیهای VRAM: نقطه بازرسی BF16 به حداقل ۶۰۰ گیگابایت حافظه ویدیویی تجمیعشده نیاز دارد (که توسط ۴ عدد NVIDIA B300 یا ۸ عدد NVIDIA H200 تامین میشود). نقطه بازرسی NVFP4 این نیاز را به ۱۸۰ گیگابایت کاهش میدهد.
- دسترسی GPU: این مدل در حالت W4A4 روی یک تکتراشه B300 (نیازمند SM100+) یا در حالت W4A16 روی دو تراشه H200 اجرا میشود.
- استقرار: پشتیبانی کامل از SGLang، vLLM، TokenSpeed، Unsloth و Hugging Face.
عملکرد در محکها
بر اساس مستندات منتشرشده، Inkling-Small یک وارونگی شگفتانگیز در نسبت اندازه به عملکرد در دامنههای خاص نشان میدهد. در محک SWE-bench Verified، این مدل با استفاده از یک محیط اجرای bash-only، امتیاز ۸۰.۲٪ را کسب کرد و از امتیاز ۷۷.۶٪ مدل Inkling پیشی گرفت. همچنین در آزمون Humanity’s Last Exam با ۳۱.۶٪ در برابر ۲۹.۷٪ و در ARC-AGI-2 با ۴۰.۱٪ در برابر ۳۶.۵٪ پیروز شد.
سایر نتایج درخشان عبارتند از:
- Toolathlon Verified: ۵۴.۴٪ (در مقابل ۴۵.۵٪ مدل Inkling)
- Terminal-Bench 2.1: ۶۴.۷٪ (در بهترین حالت محیط اجرا)
- GPQA Diamond: ۸۹.۵٪
- AIME 2026: ۹۵.۵٪
- IFBench: ۸۲.۲٪
تمامی ارزیابیها در سطح تلاش ۰.۹۹ و دمای ۱.۰ انجام شده و محدودیت حداکثری مسیر توکنها برای کدنویسی ۲۵۶ هزار توکن بوده است. امتیازات خارجی از منابع Artificial Analysis، Scale AI و ARC Prize استخراج شدهاند.
با این حال، این کارایی به قیمت کاهش حافظه факти (Factual Recall) تمام شده است. امتیاز مدل در SimpleQA Verified از ۴۳.۹٪ در مدل معلم به ۲۰.۶٪ سقوط کرد و شاخص AA Omniscience از ۲.۱ به ۹.۰- رسید. علاوه بر این، امتیاز Tau 3 Banking در مقایسه با ۲۳.۷٪ مدل Inkling، به ۱۵.۵٪ کاهش یافت. این نتایج نشان میدهد که مدل کوچکتر در منطق و ترکیب مطالب عالی است، اما در بازیابی دقیق اطلاعات دشوار است.
چندوجهی بودن و ایمنی
قابلیتهای چندوجهی در این مدل با هزینه کمتر، رقابتی باقی مانده است. امتیاز MMMU Pro برابر با ۷۴.۰٪، Audio MC برابر با ۵۴.۹٪، MMAU برابر با ۷۷.۰٪ و VoiceBench برابر با ۹۰.۱٪ ثبت شده است. در آزمون CharXiv RQ، مدل ۷۷.۴٪ امتیاز گرفت که در صورت استفاده از پایتون برای برش، زوم و بررسی برنامهای نمودارها، این عدد به ۸۱.۳٪ افزایش مییابد.
در بخش معرفتشناسی (Epistemics) و ایمنی:
- کالیبراسیون: آموزش از طریق RL در برابر قوانین امتیازدهی مناسب در پیشبینیهای دنیای واقعی انجام شده است. در ForecastBench (بدون جستجو)، شاخص برایر ۶۱.۳ ± ۰.۴۶ ثبت شد که بهتر از ۶۰.۱ ± ۰.۵۴ مدل Inkling است.
- امتیازات ایمنی: نرخ StrongREJECT برابر با ۹۸.۴٪، FORTRESS در حالت متخاصمانه (adversarial) برابر با ۷۱.۶٪ و FORTRESS در حالت خوشخیم (benign) برابر با ۹۶.۹٪ است.
آزمایشگاه Thinking Machines نتیجه گرفت که این مدل پیشرفت مادی چشمگیری فراتر از اکوسیستم فعلی وزنهای باز ایجاد نمیکند و برای استقرار در سطح مصرفکننده، استفاده از لایههای نظارتی نظیر Llama Guard را توصیه میکند.
برای متخصصان، این عرضه این فرض را تغییر میدهد که برای رسیدن به سطح پیشرو در کدنویسی عاملمحور، حتماً به مدلهای تریلیون پارامتری نیاز است. توانایی اجرای یک مدل ۲۷۶ میلیاردی روی یک نمونه B300، این قابلیتها را از قلمرو آزمایشگاههای ثروتمند به دست شرکتهای متوسط میرساند.
این معماری همچنین درهای جدیدی را برای بخشهای تحت نظارت مانند عملیات بهداشتی-درمانی، خدمات مالی، بیمه، مخابرات و بخش دولتی باز میکند. زیرا وزنها باز هستند، سازمانها میتوانند مدل را روی زیرساختهای خصوصی خود میزبانی کنند. گنجاندن پردازش بومی صدا و تصویر، کاربرد آن را به تحلیلهای مرکز تماس، رابطهای صوتی، خلاصهسازی جلسات و درک خودکار نمودارها گسترش میدهد.
توسعهدهندگان در حال حاضر میتوانند از طریق Tinker Playground با چتهای متنی، تصویری و صوتی تعامل داشته باشند، جایی که هر دو مدل با تخفیفی محدود در دسترس هستند. این عرضه همچنین شامل یک راهنمای تعاملی است که مفاهیمی چون مسیریابی پراکنده (sparse routing)، رتبهبندی بنچمارکها، همگرایی وجهها و اندازهبندی سختافزار را پوشش میدهد.
توسعهدهندگان باید اکنون رصد کنند که جامعه متنباز چگونه Inkling-Small را برای دامنههای عمودی خاص، بهویژه در اتوماسیون ترمینالهای خودمختار و عوامل کدنویسی که در حال حاضر در آنها برتری عملکردی دارد، تطبیق میدهند.
گام بعدی شما
- بررسی مدل Inkling-Small در Tinker Playground برای تست قابلیتهای صوتی و تصویری.
- ارزیابی مدل در محیطهای محلی با استفاده از NVFP4 برای کاهش مصرف VRAM.
- رصد نحوه انطباق جامعه متنباز با این مدل در حوزه اتوماسیون ترمینال.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ برای درک بهتر لایههای محاسباتی، به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو