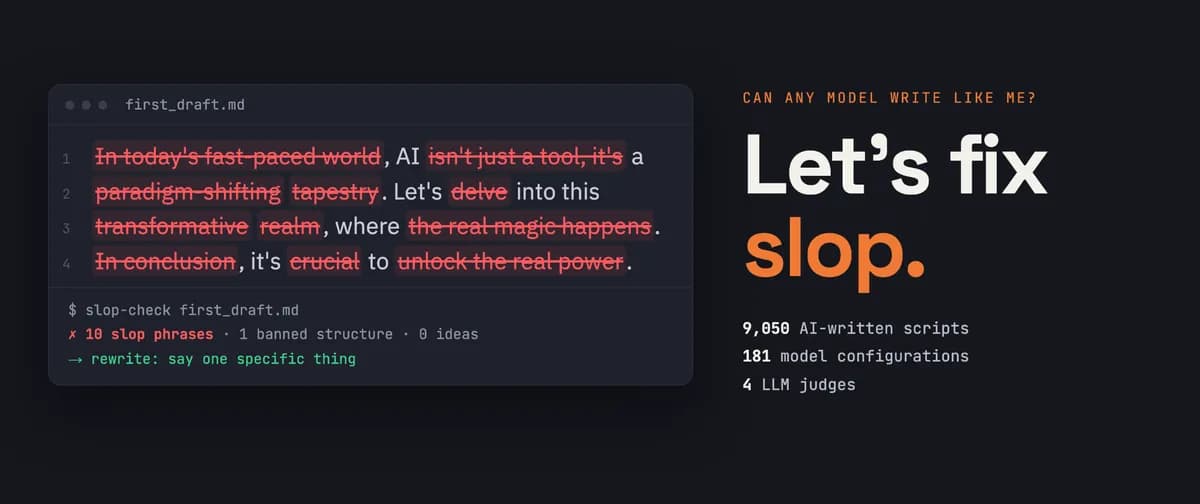
اگر امروز برای تولید محتوای برند خود از مدلهای گرانقیمت استفاده میکنید، احتمالاً متوجه شدهاید که خروجیها بوی «ماشینی» میدهند. مشکل اینجاست که حذف کلیشههای هوش مصنوعی ساده است، اما بازسازی یک صدای انسانی واقعی نیازمند تغییرات ساختاری عمیقی است که اکثر مدلها در آن شکست میخورند.
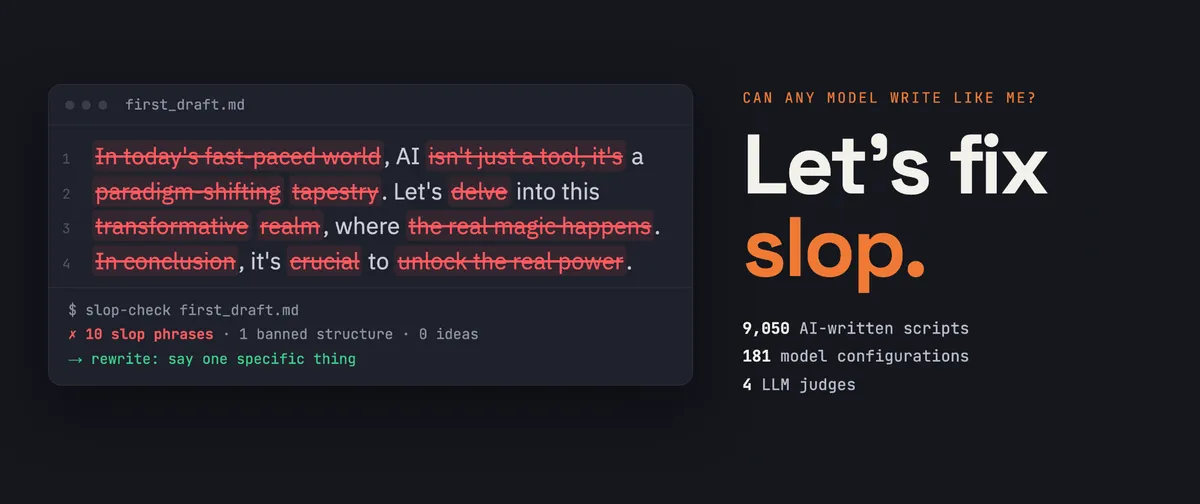
طبق گزارش منتشر شده در ۱۲ اکتبر ۲۰۲۶، محک جدیدی به نام ToneBench با تحلیل ۹,۰۵۰ اسکریپت، تفاوت میان «تمیزی متن» و «داشتن صدا» را آشکار کرد. در این تحلیل، مدلهای Claude در ۱۱ رتبه نخست ثبات لحن و صدا قرار گرفتهاند. همانطور که در پوشش پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تفاوت در لایههای استدلالی مدلهاست که باعث میشود برخی در شبیهسازی پیچیدگیهای انسانی موفقتر باشند.
مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — معمولاً به کلیشههای شرکتی پناه میبرد. عباراتی مانند «در دنیای پرشتاب امروز» یا «بیایید به این قلمرو تحولآفرین نگاهی بیندازیم» نمونههایی از این «زبالههای متنی» (AI Slop) هستند. این موضوع با یافتههای پژوهش گرافیت همسو است که ۱۳ هزار عبارت کلیدی را به عنوان اثر انگشتهای زبانی مدلها شناسایی کرد تا نشان دهد مدلها چقدر به الگوهای تکراری وابسته هستند. برای متخصصان، چالش اصلی نه تنها حذف این کلمات، بلکه بازسازی یک شخصیت (Persona) منحصربهفرد است. در حالی که حذف کلمات کلیشهای یک ویرایش ساده است، اما شکار یک صدای خاص نیازمند تغییرات ساختاری عمیق، بازسازی متن و تغییر مثالهاست؛ وظایفی که اکثر مدلها در اجرای آنها ناتواناند.
جزئیات طراحی محک
تیم Towards AI برای ساخت این بنچمارک، حدود یک ماه بهصورت تقریباً تماموقت — یعنی تقریباً ۴۰۰ ساعت — زمان صرف کرد تا ۱۰ اسکریپت ویدئویی را به دستورالعملهای دقیق (Rubrics) تبدیل کند. برخی از این اسکریپتها منتشر شده بودند و برخی برای جلوگیری از آلودگی دادهها (Contamination) مخفی نگه داشته شدند. آنها ۱۸۱ پیکربندی مختلف، شامل تمام سطوح تفکر مدلها را آزمایش کردند و از پانلی از مدلهای زبانی بهمثابه داور (LLM-as-a-judge) برای امتیازدهی پیشنویسها در مقایسه با نسخههای اصلی انسانی استفاده نمودند.
برای ارزیابی اینکه آیا یک مدل میتواند اسکریپتی مناسب بازتولید کند، تیم ابزارهای کاملی را در اختیار هوش مصنوعی قرار داد:
- راهنمای لحن (Voice Guide) و راهنمای استوریتلینگ
- قوانین خروجی مشخص و یک بریف (Brief) دقیق
- نمونههای پیشین و پژوهشهای لازم
هر پیشنویس سپس توسط چهار داور امتیازدهی شد: یک مدل GPT، یک مدل Claude، یک مدل بازمتن و Jev. نتایج این فرآیند، شکاف شدیدی را میان «تمیزی» (Cleanliness) و «صدا» (Voice) نشان داد.
موازنه هزینه و کیفیت
بر اساس مستندات ToneBench، نتایج یک تضاد جالب را آشکار میکند:
- GPT-6 Astra در حالت حداکثری (Max Effort)، تمیزترین مدل است و امتیاز ۹۴.۹ را در بررسی کلیشهها کسب کرد. با این حال، این مدل در رتبه ۶۲ کلی قرار گرفت زیرا در جذب صدای نویسنده شکست خورد و تنها امتیاز ۸۲ گرفت، در حالی که Opus امتیاز ۹۰ را کسب کرد.
- Claude Opus 5.5 با امتیاز ۹۰.۸ برترین نویسنده است. اما تفاوت هزینه بسیار چشمگیر است: حالت «max effort» برای هر اسکریپت ۲.۷۵ دلار هزینه دارد، در حالی که حالت «xhigh» با هزینه ۰.۶۹ دلار، امتیازی تقریباً یکسان (۹۰.۰) میگیرد. این یعنی پرداخت ۴ برابر هزینه بیشتر برای امتیازی که کمتر از ۱٪ تفاوت دارد. این موفقیت در حالی به دست آمده که Anthropic پیشتر با چالشهای جدی برای جلوگیری از تبدیل شدن لحن Claude به متنی ماشینی دست و پنجه نرم میکرد.
- GLM-5.3 Flash که یک مدل با وزنهای باز (Open Weights) — یعنی دستور پخت مدل علناً منتشر شده و نه فقط غذای آماده — است، با هزینه تنها ۱.۵ سنت برای هر اسکریپت، امتیازی معادل ۸۸.۲ گرفت. این مدل تقریباً ۱۹۰ برابر ارزانتر از Opus 5.5 در حالت حداکثری است، در حالی که امتیاز آن تنها حدود ۳٪ پایینتر است.
سوگیری داوران
این مطالعه افشا کرد که هیچ داور هوش مصنوعی خنثی نیست و هر داور یک آزمایشگاه مورد علاقه دارد. داور GPT به پیشنویسهای OpenAI حدود ۲.۷۵ امتیاز اضافه و از امتیازات Anthropic حدود ۲.۱۴ امتیاز میکاهد. داور DeepSeek حدود یک امتیاز به مدلهای DeepSeek و Kimi اضافه میکند. داور Claude کمترین سوگیری را دارد، هرچند همچنان مدلهای آزمایشگاه خود را بالا میبرد و بهطور غافلگیرکنندهای مدلهای گوگل را حتی بیشتر ترجیح میدهد.
Jev نسبتاً خنثی تشخیص داده شد و تمایل اندکی به مدلهای Gemini داشت. با این حال، Jev در وظایف نوشتاری ثبات کمتری داشت زیرا نمیتواند استدلالهای خود را در امتیازدهی توجیه کند و همین امر آن را برای داوریهای نوع «سیستم ۲» (تفکر کند و تحلیلی) ناکارآمد میکند. برای مقابله با این مشکل، پژوهشگران توصیه میکنند از پانلی از داوران استفاده شود و هرگز اجازه ندهید آزمایشگاهِ تولیدکننده مدل، تنها داور اثر باشد.
این تغییر در دادهها نشان میدهد که واحد کار در نویسندگی هوش مصنوعی تغییر کرده است. تولید متن اکنون به یک کالای عمومی (Commodity) تبدیل شده و ارزش واقعی در مرحله «انتخاب» و «داوری» نهفته است. با تولید ۱۰ پیشنویس ارزان توسط مدلهایی مثل GLM-5.3 Flash و استفاده از یک داور با قدرت استدلال بالا برای ترکیب بهترین بخشها در قالب یک «پیشنویس فرانکنشتاین»، کاربران میتوانند به نتایجی برسند که با گرانترین مدلها رقابت کند یا حتی از آنها بهتر باشد، در حالی که ۲۰ برابر ارزانتر است.
خط لوله (Pipeline) پیشنهادی
برای کسانی که قصد پیادهسازی این روش را دارند، خط لوله پیشنهادی شامل مراحل زیر است:
- دستورالعمل (Instruction): دستورالعملهای طولانی و دقیق درباره لحن، ساختار و قوانین بنویسید. نمونههای کامل از آنچه باید انجام شود و آنچه باید اجتناب شود ارائه دهید.
- فیلترینگ (Filtering): عبارات مورد نفرت را نام ببرید و بهجای تکیه بر پرامپت، از کد برای بررسی وجود این عبارات در پیشنویسها استفاده کنید.
- تولید (Generation): چندین پیشنویس با یک مدل باز و ارزان تولید کنید.
- انتخاب (Selection): اجازه دهید یک داور با تفکر بالا از یک آزمایشگاه متفاوت، بر اساس یک روب ریک (Rubric) شفاف، بهترین بخشها را انتخاب یا ادغام کند.
- اصلاح (Refinement): یک یا دو دور بازبینی و ویرایش با یک داور مجزا انجام دهید. فراتر از دو دور، مزایای این کار کاهش مییابد.
حتی بهترین پیشنویسهای Opus 5.5 همچنان به یک ویرایش نهایی انسانی نیاز دارند تا واقعاً صیقلخورده شوند. این متدولوژی در حال حاضر برای وظایف سفارشی مشتریان در حال انطباق است تا نویسندگی هوش مصنوعی را از یک فرآیند «حسمحور» (Vibe-based) به یک خط لوله مهندسی قابل اندازهگیری تبدیل کند. متدولوژی کامل ToneBench در روز سهشنبه ۱۳ اکتبر، ساعت ۱۰:۴۰ صبح در اتاق تورینگ (بخش Evals) ارائه شد.
گام بعدی شما
- دستورالعملهای طولانی و دقیق بنویسید و نمونههای «بایدها» و «نبایدها» را به مدل بدهید.
- برای حذف کلمات کلیشهای، بهجای تکیه بر پرامپت، از کدهای فیلترینگ ساده استفاده کنید.
- چندین پیشنویس ارزان تولید کرده و از یک داور مدل استدلالی از یک شرکت متفاوت برای ادغام آنها استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو